4.2 深度学习对象检测方法
4.2 深度学习对象检测方法
本节摘要:OpenCV 的 DNN 模块让你不搭深度学习框架也能推理预训练检测模型。本节跑通"加载网络 → blob 预处理 → 前向推理 → 后处理画框"四步完整流程,讲清单阶段与两阶段检测器的结构差异、NMS 非极大值抑制的作用,以及置信度阈值与输入尺寸对结果的影响。目标是用 CPU 跑通一个多类别检测器的完整闭环。
项目主线中的位置与目标
阅读完本节,你应当能够:
- 用 cv2.dnn.readNet 加载模型并完成一次前向推理
- 解释 blobFromImage 的四个关键参数(尺寸、缩放、均值交换、RGB 转换)
- 说出单阶段与两阶段检测器的流程差异与速度精度取舍
- 理解 NMS 为什么必要、IoU 阈值怎么定
- 按部署条件在模型与后端之间做出选择
先跑起来:DNN 检测四步曲
以 YOLO 为例(模型权重文件从公开渠道自行获取,配合同名配置文件),四步走完一个检测闭环:
import cv2 import numpy as np # 第一步:加载网络与类别 net = cv2.dnn.readNet('yolov3.weights', 'yolov3.cfg') classes = open('coco.names').read().strip().split('\n') layer_names = net.getLayerNames() out_layers = [layer_names[i - 1] for i in net.getUnconnectedOutLayers()] # 第二步:图像转 blob img = cv2.imread('street.jpg') blob = cv2.dnn.blobFromImage(img, 1/255.0, (416, 416), swapRB=True, crop=False) net.setInput(blob) # 第三步:前向推理 outputs = net.forward(out_layers) # 第四步:解析置信度(YOLO 输出行结构:中心x 中心y 宽 高 置信度 80类别分) h, w = img.shape[:2] boxes, confs, ids = [], [], [] for out in outputs: for det in out: scores = det[5:] cid = int(np.argmax(scores)) if scores[cid] > 0.5: cx, cy, bw, bh = det[:4] * np.array([w, h, w, h]) boxes.append([int(cx-bw/2), int(cy-bh/2), int(bw), int(bh)]) confs.append(float(scores[cid])) ids.append(cid)
前三步是所有 DNN 检测的通用骨架,第四步是 YOLO 特有的输出解析。跑在 CPU 上,一张图约一到数秒——速度不及 GPU,但流程完整、无需装深度学习框架,这正是 DNN 模块的定位:推理引擎,不是训练引擎。
核心原理:单阶段、两阶段与后处理
2.1 blob:图像进网络前的"安检"
网络不能直接吃图像数组,要先打包成四维张量 blob(批次 × 通道 × 高 × 宽)。blobFromImage 一步完成打包,参数各有含义:尺寸 (416,416) 是网络输入规格,YOLO 系取 320 到 608 的 32 倍数,越大越准也越慢;1/255.0 把像素值缩到 0–1(训练时的归一化要原样复刻);swapRB=True 做 BGR 转 RGB(第 1 章的老朋友);crop=False 表示缩放不裁剪(YOLO 训练时容忍纵横比失真)。**推理预处理必须与训练时一致**,这是深度模型部署的第一铁律,参数抄模型官方示例最稳。
2.2 单阶段与两阶段:一次看全 vs 先粗后细
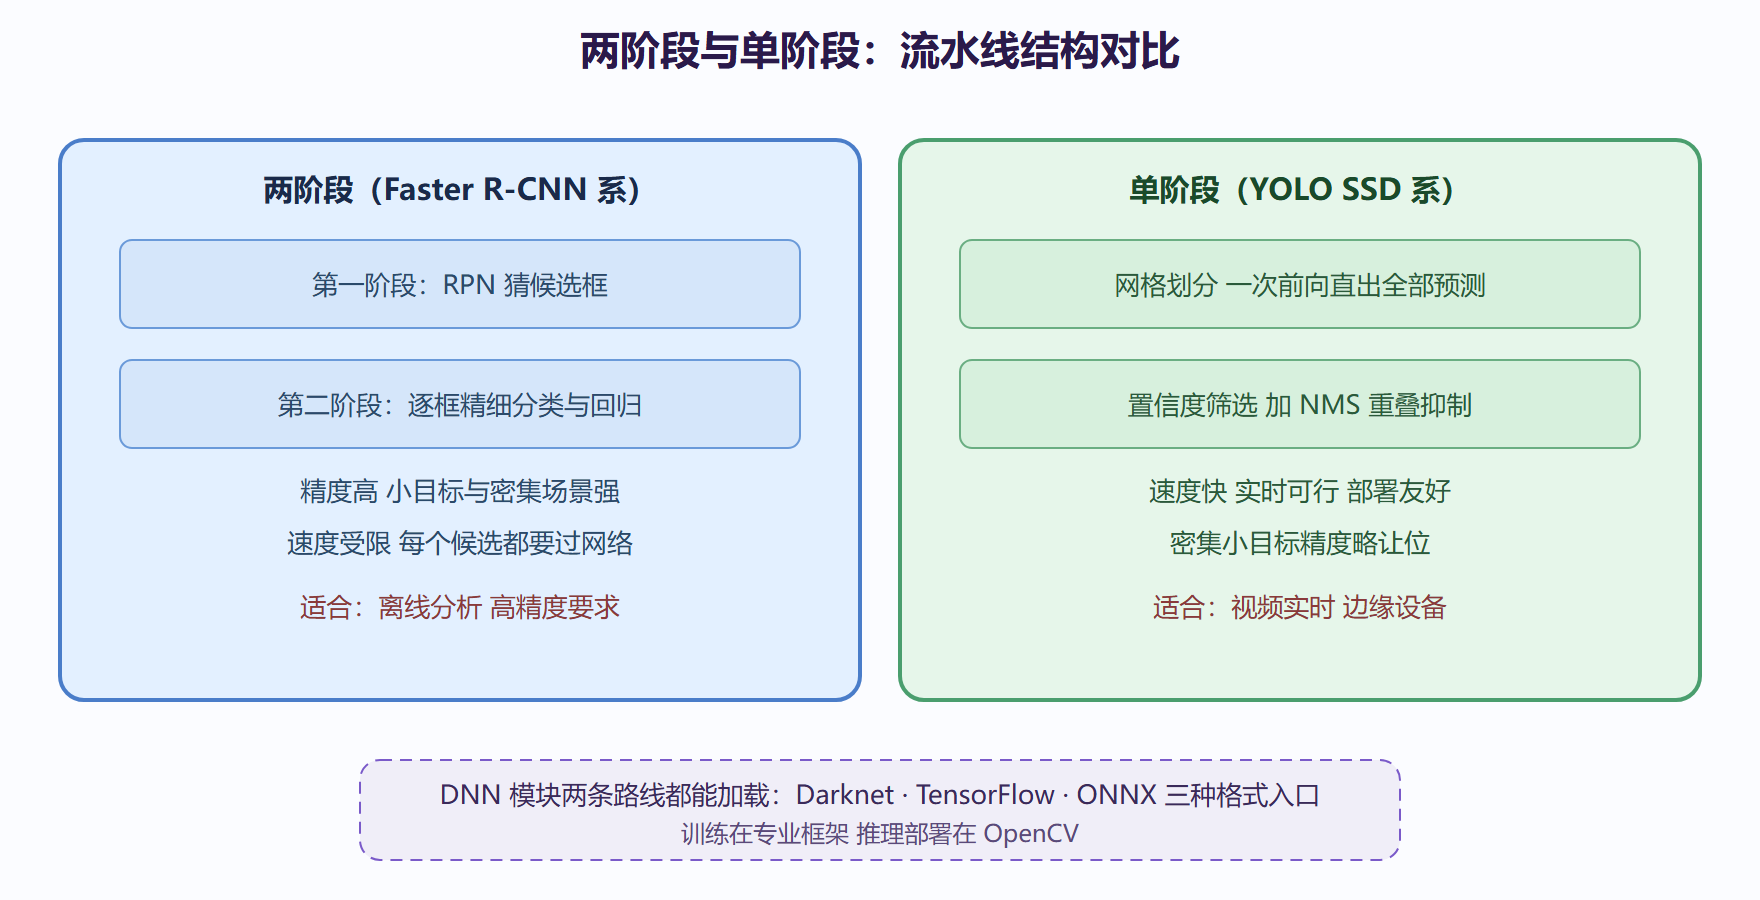
两阶段检测器(Faster R-CNN 为代表)像工厂流水线:第一阶段用区域建议网络(RPN)猜出"哪里可能有东西"的候选框,第二阶段对每个候选框精细分类并回归位置。精度高,尤其是小目标与密集场景,但每个候选框都要过一遍网络,速度受限。
单阶段检测器(YOLO、SSD 为代表)一步到位:把图划成网格,每个格子直接预测"我这里有没有目标、框在哪、是什么类别",一次前向全部输出。速度快(YOLO 的名字就来自"你只看一次"),代价是密集小目标的精度让位。
OpenCV 的 DNN 模块对两条路线都能加载:readNetFromDarknet 吃 YOLO 系列,readNetFromTensorflow、readNetFromONNX 分别对接 TensorFlow 与 ONNX 格式模型——后者是通用交换格式,PyTorch 训练的模型导出 ONNX 后即可在 DNN 模块推理,这让 OpenCV 成为"训练在别处、部署在此处"的轻量落点。
2.3 NMS:一物一框的最后一关
网格预测会产生大量重叠框:一条狗被相邻三个格子各报一次。非极大值抑制(NMS)的流程:按置信度排序,留下最高的框;计算其余框与它的 IoU(交并比,两框交集面积除以并集面积),超过阈值(惯例 0.4–0.5)的判定为"同一目标的重复"予以抑制;对剩余框重复上述过程。DNN 模块封装了这个函数:
idx = cv2.dnn.NMSBoxes(boxes, confs, score_threshold=0.5, nms_threshold=0.4) for i in np.array(idx).flatten(): x, y, bw, bh = boxes[i] label = f'{classes[ids[i]]} {confs[i]:.2f}' cv2.rectangle(img, (x, y), (x+bw, y+bh), (0, 255, 0), 2) cv2.putText(img, label, (x, y-8), cv2.FONT_HERSHEY_SIMPLEX, 0.6, (0, 255, 0), 2)
两个阈值分工:score_threshold 是"够不够格当检测"的分数线(第 4 章第 1 节 minNeighbors 的深度版),nms_threshold 是"算不算同一目标"的合并线。
工程实践要点
3.1 速度优化三板斧
CPU 上嫌慢,按性价比顺序试:换轻量模型(YOLO 的 tiny 版本、MobileNet-SSD,精度换速度,快 5–10 倍);降输入尺寸(608 到 416 到 320,速度升、小目标召回降);启用加速后端(net.setPreferableBackend(cv2.dnn.DNN_BACKEND_OPENCV) 与目标设备设置,有 OpenCL 或厂商推理引擎时再上一档)。GPU 部署时 CUDA 后端需要编译期支持,装包时留意(第 1 章第 2 节的发行包差异)。
3.2 版本与格式的坑
readNet 系列对模型版本敏感:Darknet 的 cfg 与 weights 必须配套、ONNX 的算子集版本不能超出 DNN 模块支持范围。加载报错时先确认模型对是否来自同一次发布,再用最小示例排除图像问题。类别名文件的顺序也要与训练时一致,文件顺序错乱时框是对的、标签全错,且没有任何报错。
3.3 与传统方法的决策线
承接第 4 章第 1 节的三块阵地:算力充裕或类别多样,直接单阶段模型;场景固定且算力极紧,传统方法;介于两者之间(比如中等算力、单一类别、需要较好的姿态鲁棒性),先试轻量深度模型,效果不达标再回落传统方案。决策的依据是量化的:拿你的目标硬件实测两条路线的帧率与漏检率,比争论"哪个先进"有意义得多。
⚠️ 常见坑:置信度阈值一刀 0.9 求稳,结果密集场景里远端小目标全被砍掉;或一刀 0.1 求全,误框爆炸。0.5 是起点,按业务容忍度(安防宁多勿漏、计数宁准勿多)双向微调。另一个坑是忘了 NMS,画面上一个目标叠着七八个框,误以为模型坏了。
3.4 动手实验清单
- 输入尺寸从 320、416 到 608 各跑一次,记录耗时与检出小目标数量,画出你自己的速度精度曲线。
- score_threshold 从 0.3 扫到 0.8,观察框数与误检的消长。
- 注释掉 NMS 那行重跑,数一数同一目标的重复框数量,直观理解 NMS 的必要性。
- 找一张密集人群图分别跑 Haar 行人的替代品 HOG 与 YOLO,对比密集场景的差距。
3.5 两条技术路线的结构对照
单阶段与两阶段检测器对比
3.6 常见疑问与解答
输入尺寸为什么必须是 32 的倍数?
YOLO 的主干网络含五次降采样,每次尺寸减半,32 等于二的五次方——输入尺寸不能被整除时特征图尺寸对不齐,直接报错。SSD 的倍数要求类似(对应其降采样次数)。记住"报错信息里出现尺寸相关字样先查输入规格"即可。
CPU 推理到底有多慢?
参考量级:入门级 CPU 跑 YOLO 全尺寸模型每帧秒级,tiny 版本百毫秒级,MobileNet 系骨干更快。加上第 5 章的"隔帧检测加跟踪"摊薄,不少 CPU 项目能做到"每秒五到十帧的有效检测",对很多监控场景够用。要上实时三十帧,就得考虑 GPU 或边缘加速硬件了。
置信度同一个模型会漂吗?
会。同一模型在不同光照、不同分辨率输入下的置信度分布不同——夜间画面整体置信度低一截是常态。跨场景复用阈值时先跑一批样本看看分布,别把甲场景调好的 0.5 直接搬到乙场景。
3.7 实战配方:一次模型上线的评估闭环
部署一个检测模型到真实场景,工程上的评估闭环比"选哪个模型"更决定成败,流程如下。
第一步离线基准。准备三十到五十张真实场景图(不是官方示例图),人工标注目标框作为真值,跑模型记录每类的检出率与误报率。这组数字是"要不要上线"的第一道闸。
第二步预处理一致性检查。逐项核对尺寸、归一化系数、通道序、均值减除与模型要求一致(本节 2.1 铁律),把核对结果写进代码注释——这四项是最常见的"离线好好的、上线就拉胯"的元凶。
第三步阈值标定。用真实场景的置信度分布定 score 阈值(本节 3.3 的漂移提醒),而不是沿用离线的 0.5;NMS 阈值按目标密度定(密集场景适当放松合并线,0.3 试起)。
第四步性能与降级路径。实测目标硬件的帧率与内存占用,确认有余量;设计降级方案:帧率不达标时先降输入尺寸、再降为隔帧检测(配第 5 章的跟踪补帧),每级降级对应的精度损失用第一步的基准重新量过。
第五步线上回流。抽检线上输出(每天几十张人工复核),错误样本归类(漏检、误报、定位偏),与离线基准对比——线上显著劣化说明场景分布漂移,回到第一步换样本重标。这个闭环转起来,模型才算真正"运维"而不是"扔上线"。
3.8 补遗:与第 5 章的衔接
本节的检测器在视频场景里扮演两个角色:跟踪器的初始化来源(第一帧或重检时给框)与周期性的身份校验(隔 N 帧确认框内还是不是目标)。衔接的接口就是"框加类别加置信度"的三元组——第 5 章第 3 节的完整方案里,检测每出现一次,都是这个三元组在驱动状态更新。把本节的四步骨架写成独立函数返回三元组,第 5 章的脚手架就能直接插上用,模块化的好处在两章交界处最为明显。多提一句工程细节:检测函数内部尽量不做显示与落盘(纯函数形态),调试输出通过返回的诊断信息交给外层决定去留——这条约定与第 5 章第 1 节的脚手架接口完全一致,两章的代码因此可以无缝拼装。
本节要点回顾
- 四步通用骨架:加载网络 → blob 预处理 → 前向推理 → 后处理画框,换模型只换第一步与解析细节。
- blob 参数即铁律:尺寸、归一化、通道序必须复刻训练时的预处理,抄官方示例最稳。
- 两条路线的结构差异:两阶段先粗后细精度高,单阶段网格直出速度快,IoU 与 NMS 是收敛到一物一框的最后一关。
- 格式生态:Darknet、TensorFlow、ONNX 各有对应加载函数,ONNX 是 PyTorch 模型进入 DNN 模块的通用桥梁。
- 提速三板斧:轻量模型、降输入尺寸、加速后端,按性价比顺序试。
- 阈值有分工:score 管资格线、nms 管合并线,按业务容忍度双向调整。
常见追问:输入尺寸降到多少会明显掉点
以常见基线为例,四百一十六降到三百二十,小目标召回掉的幅度通常比大目标明显得多——小目标的像素本就稀少,下采样后信息先被抹掉。若业务只关心大目标(如近景车牌、柜台前的脸),降到三百出头几乎无损还能快三成;若要盯远处的小目标,宁可换轻量模型也别硬降尺寸。验证方法很朴素:抽三十张难例,两个尺寸各跑一遍,对比框的数量与位置,十分钟就能有结论。
检测给出"框与粗类别",最后一步是把框住的东西分得又准又细。下一节讲对象识别与分类的完整闭环——特征、训练与预测。
还有一个易踩的坑:不同版本的 YOLO 权重文件后缀与配置要配套,cfg、names、weights 三件套缺一不可,加载前先判 empty,报错信息里最常见的就是少传了 names 文件。