4.2 匹配替换与捕获
4.2 匹配替换与捕获
Perl 正则三大操作符:
m//匹配、s///替换、tr///逐字符转换。捕获组把匹配到的片段装进$1 $2,列表上下文更能一次解包全部字段。
列表上下文一次取全
my $line = '10.0.0.5 [12/Aug/2026:03:14:51] "GET /api/order" 200 12ms'; my ($ip, $api, $status, $ms) = $line =~ /^(\S+) \[\S+\] "\w+ (\S+)" (\d{3}) (\d+)ms$/; if (defined $ip) { print "$ip 访问 $api,状态 $status,耗时 $ms\n"; }
匹配失败时右侧返回空列表,四个变量全部 undef——用 defined 判一次就能安全收场,比逐个查 $1 到 $4 干净得多。
s///:替换与清洗
my $url = '/api/search?q=hello%20world'; $url =~ s/%20/ /g; # 全局替换解码空格 $url =~ s{^/api/}{}; # 去掉前缀,m{} 风格定界符 $url =~ s/(\w+)/\u$1/; # \u 把捕获组首字母大写 print "$url\n"; # Search?q=hello world
s/旧/新/标志 常用三个标志:g 全部替换、i 忽略大小写、e 把替换侧当表达式求值。e 标志威力大也危险,仅在替换内容需要计算时使用。
tr///:逐字符翻译
my $dirty = "hello\tworld\r\n"; $dirty =~ tr/\t\r//d; # 删除制表符与回车 my $vowels = ($line =~ tr/aeiou//); # 数元音个数(顺手计数)
tr 不认识正则,只做字符对字符的映射、删除与统计,做这类事它比 s///g 快得多。
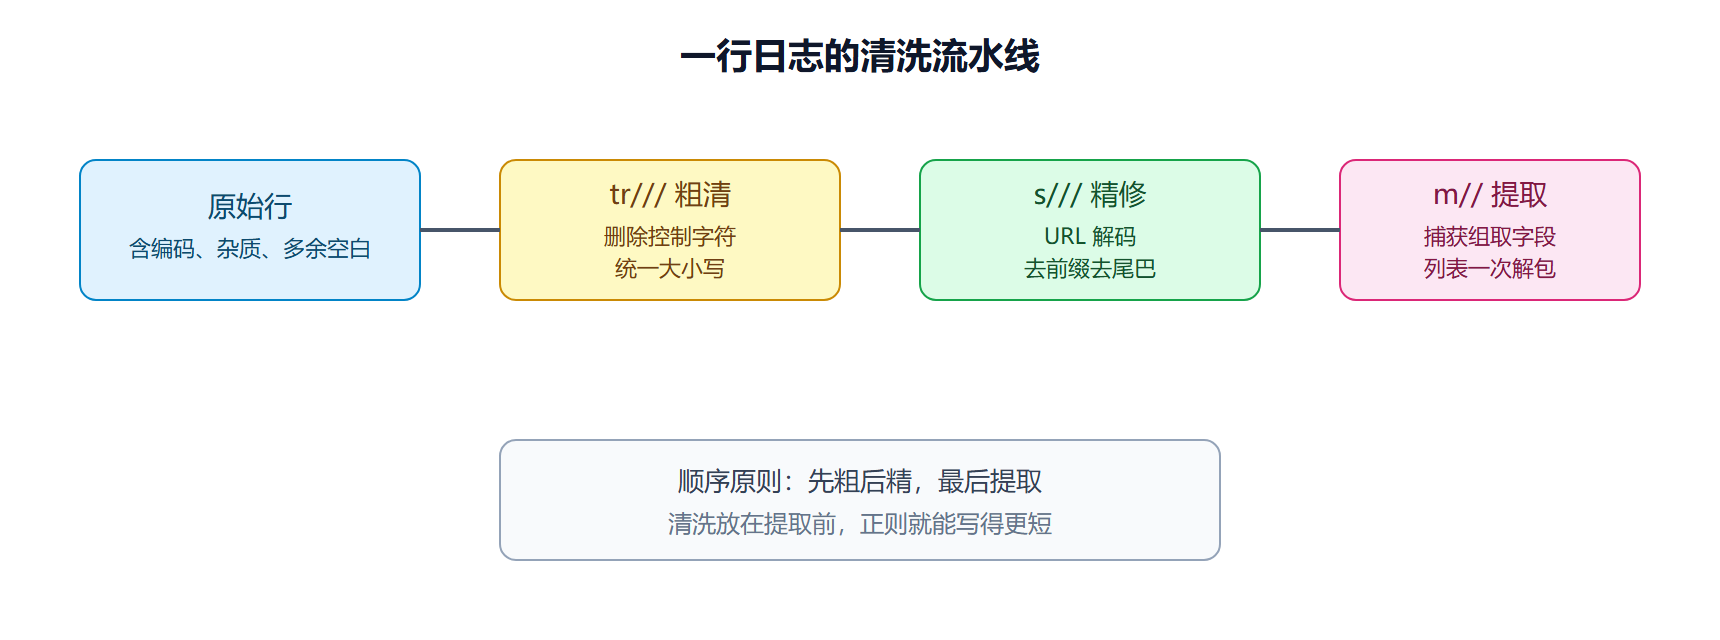
三种操作符的流水线分工
实用替换片段
# 压缩连续空白为一个 $line =~ s/\s+/ /g; # 千分位加逗号(环视断言) $total =~ s/(?<=\d)(?=(\d{3})+$)/,/g; # 交换两个捕获的字段位置 $row =~ s/^(\w+),(\w+)$/$2,$1/;
第二条用了环视(lookaround):(?<=...) 向后看、(?=...) 向前看,只定位不消费字符,是正则进阶的第一站。
⚠️ 常见坑:
s///不加g只替换第一处。统计类脚本里"数字只换了一半"几乎都栽在这个标志上。
命名捕获:给捕获组发工牌
$1 $2 的编号在模式改动后会整体错位——在中间插一个括号,后面所有取值全部移位,且编译器一声不吭。命名捕获(5.10 起)根治这个问题:
my $line = '10.0.0.5 [12/Aug/2026:03:14:51] "GET /api/order" 200 12ms'; if ($line =~ /(?<ip>\S+) \[[^\]]+\] "\w+ (?<path>\S+)" (?<status>\d{3}) (?<ms>\d+)ms/) { printf "%s -> %s 状态 %s 耗 %sms\n", @+{qw(ip path status ms)}; # %+ 哈希按名取值 }
(?<name>...) 定义,$+{name} 或 @+{...} 取值。模式的任何位置增删组都不影响既有名字,重构安全。工坊标准:三组以上的捕获必须命名。
递归替换与清洗流水线实战
把一串清洗步骤串成流水线处理脏数据,是 s/// 最常见的落地形态。以"用户填写的搜索词清洗"为例:
sub clean_query { my $q = shift; $q =~ s/^\s+|\s+$//g; # 去首尾空白 $q =~ s/\s+/ /g; # 压缩中间空白 $q =~ s/[<>"]//g; # 去危险字符 $q =~ tr/A-Z/a-z/; # 统一小写 return length $q ? $q : undef; # 清洗后为空则返回 undef } my @words = grep { defined } map { clean_query($_) } @raw_input;
要点在于顺序:先去空白再压空白(反了会留下空段)、先删字符再转小写(少做一轮无效转换)。每一步都可独立测试,出问题时二分注释定位——这比把所有逻辑塞进一个巨型正则可维护得多。
e 标志:替换侧的计算
e 把替换侧当 Perl 代码求值,适合"替换值需要计算"的场景,比如把日志里的字节读数换算成 KB 显示:
$line =~ s/(\d+)B$/ sprintf('%.1fKB', $1 / 1024) /e; # 更新式(ee 少用):替换侧是字符串形式的代码 $line =~ s/(\d+)/ $1 * 2 /e; # 数字翻倍
威力与风险同源:e 里可以执行任意表达式,若替换侧拼接了外部输入,等于开了个执行口子。纪律只有一条——e 的替换侧只写常量逻辑,永远不拼用户输入。
补一个 tr 与 s 的分工判据,收束本节:改"内容"(一段一段地替换、提取)用 s///;改"字符"(删掉某类字符、大小写翻转、统计某类字符出现次数)用 tr///。两个真实判断练习:把全角逗号统一成半角是字符映射,tr/,/,/;把日志里的多空格压成一个涉及"一串变一个",属于模式替换,tr 无能为力。判据立在脑子里,两种操作符就不会用错场合。再记一组返回值语义:s/// 与 tr/// 在标量上下文返回替换次数,这个数字本身就是有用的统计——my $n = ($line =~ s/-/--/g); 顺手就知道这行有几个连字符被处理,不需要再数一遍。
\K 与 \G:替换的两个进阶锚点
\K(5.10 引入)让"匹配前缀但只替换后半段"少写一组环视:s/金额:\s*\K(\d+)/新值/ 中 金额: 被匹配却不参与替换,也不占 $1;等价的 s/(?<=金额:)\s*(\d+)/新值/ 要靠环视,阅读成本更高。\G 锚定"上次匹配结束的位置",配合标量上下文 m//g 可做逐段游标式扫描:第一次 /\G(\w+)/g 从开头取一段,之后每次调用都从上一段末尾继续,字段再乱也不漏段不重段;pos($line) 可显式读写游标位置。两者组合的典型场景是"只处理一行里的第二个数字"——先用 \G 定位到目标段,再对该段单独做捕获替换。
本节要点回顾
- 列表上下文一次解包捕获组,配合 defined 判失败
s/旧/新/g的 g 别忘,默认只换第一处- tr/// 做字符级翻译、删除、计数,速度优于 s///g
- 清洗在前、提取在后,正则可以写得更短更稳
- 环视只定位不消费,千分位这类"插入"任务靠它