4.3 高级技巧:贪婪、回溯与性能
4.3 高级技巧:贪婪、回溯与性能
量词默认贪婪(尽可能多吃),加
?变懒惰(尽量少吃);匹配失败时引擎逐个退回重试的过程叫回溯,嵌套量词引发的灾难性回溯能让一个正则吃满 CPU。
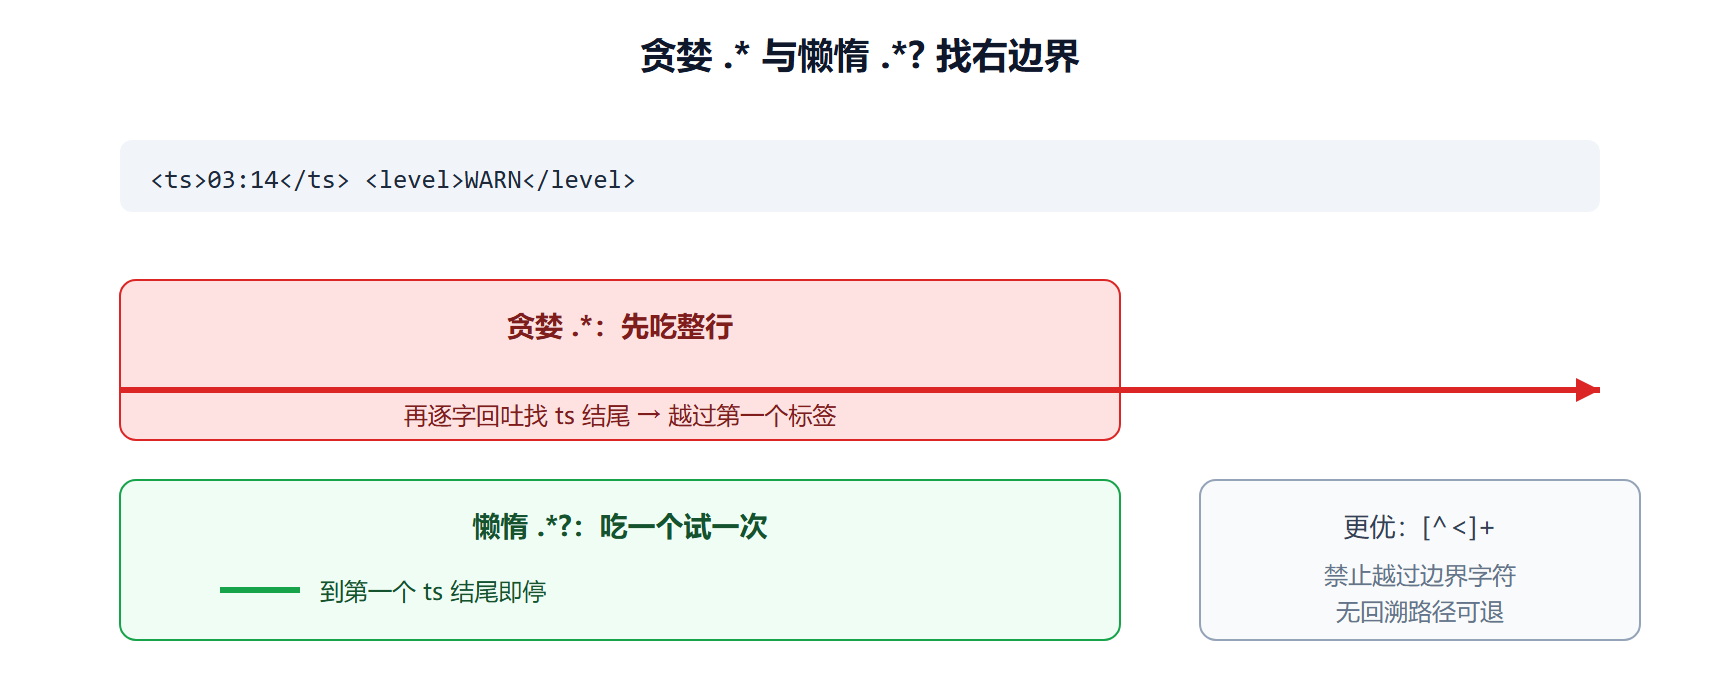
贪婪与懒惰的一次对照
my $line = '<ts>03:14</ts> <level>WARN</level>'; my ($greedy) = $line =~ /<ts>(.*)<\/ts>/; # 错:匹配到 "03:14</ts> <level>WARN</level" —— .* 一路吃到行尾再回吐 my ($lazy) = $line =~ /<ts>(.*?)<\/ts>/; # 对:匹配到 "03:14" —— 每吃一个字符就回头试试右边界
带 HTML/XML 类标签的文本,提取内容几乎永远用 .*?。另一个更稳的思路是排除型字符类:/<ts>([^<]+)<\/ts>/——"吃到下一个左尖括号为止",既快又不会越界。
灾难性回溯什么样
# 反面教材:嵌套量词 + 可互相顶替的字符类 if ($text =~ /^(\w+\s*)+$/) { ... }
\w+ 和 \s* 都能匹配空串边界的多种划分方式,文本一长,引擎尝试的组合数指数膨胀。表现是脚本卡在某一行不动。修法有三招:
# 1. 换成明确互斥的写法 $text =~ /^\w+(?: \w+)*$/; # 2. 加锚点与具体字符类,压缩可选路径 $line =~ m{^/\w+(?:/\w+)*\?q=\S+$}; # 3. 拆成两步:先用 index/substr 粗定位,再用短正则确认
两种量词的匹配路径差异
让正则更快的三个习惯
# 习惯一:能锚则锚 $line =~ /^\d+\.\d+\.\d+\.\d+ /; # 行首 IP,引擎直接跳过不可能的位置 # 习惯二:用 study 或预编译(同一模式匹配海量行时) my $re = qr/^(\S+) \[\S+\] "\w+ (\S+)" (\d{3}) (\d+)ms$/; if ($line =~ $re) { ... } # qr// 只编译一次 # 习惯三:超长行先截断 $line = substr($line, 0, 2048) if length($line) > 2048;
qr// 把模式编译成可复用的正则对象,十万行循环里编译一次和编译十万次的差别可以感知。
💡 关键直觉:正则性能问题几乎都能翻译成一句话——"可选路径太多"。定位到哪段模式产生了多条路径,删掉选择或用互斥字符类锁死它,速度自然回来。
环视的三个进阶用例
4.2 节见过环视做千分位,这里补三个日志工坊里的高频形态,把"只定位不消费"的直觉练扎实:
# 1. 否定环视:提取不是 ms 结尾的数字(比如排除耗时字段) my @nums = $line =~ /(\d+)(?!ms)/g; # 2. 肯定环视限定边界:取冒号后、空格前的内容而不要消费冒号 my ($user) = $line =~ /(?<=user:)\S+/; # 3. 密码强度检查:环视做"同时包含"类断言 my $ok = $pw =~ /^(?=.*[a-z])(?=.*[A-Z])(?=.*\d).{8,}$/;
第三个用例最能体现环视的不可替代性:三个 (?=...) 在同一起点各自向前看一眼,互不消费位置,"同时包含大小写与数字"这种 AND 语义用普通分组写不出来。
回溯的量化观察:让慢现形
怀疑某个模式拖慢了流水线,先量化再动手。给解析函数加个简单的计时,跑同一份十万行样本对比两种写法:
use Time::HiRes qw(time); my $t0 = time; $slow++ while $sample =~ /(\w+\s?)+$/g; # 病态模式 my $t1 = time; $fast++ while $sample =~ /\w+(?: \w+)*$/g; # 互斥改写 my $t2 = time; printf "病态写法 %.3fs,改写后 %.3fs,差 %.1f 倍\n", $t1-$t0, $t2-$t1, ($t1-$t0)/($t2-$t1);
文本几十字节时两者看不出差距,把样本拼到几 KB,病态版的时间开始指数上翘,改写版基本线性——亲眼看过这条曲线,"嵌套量词要重写"就不再是书本教条。生产上同思路的工具是给每行匹配设超时(用 alarm 包裹或拆行分批),超时行落盘单独分析,不让单行病态阻塞整晚批处理。
模式的单元测试习惯
正则是文本工坊里最容易"改一处崩三处"的零件,值得像函数一样做单元测试。最轻量的做法是把样本行与期望值写进 __DATA__:
use Test::More tests => 3; my @cases = ( [ '10.0.0.5 [12/Aug/2026:03:14:51] "GET /api/order" 200 12ms', '200' ], [ '10.0.0.9 - 03:14:52 WARN /api/search 503 890ms', '503' ], [ 'garbage line no fields at all', undef ], ); for my $c (@cases) { my ($got) = $c->[0] =~ $status_re; is $got, $c->[1], "样本: $c->[0]"; }
新格式上线、模式调整,跑一遍测试就知道旧样本有没有被破坏。7.3 节会展开 Test::More 的完整用法,这里先立习惯:改模式必配样本,加样本必写期望。样本集的选取比测试代码本身更重要——典型行、边界行(空值、超长、残缺)各留一条,覆盖住真实日志的三副面孔。性能与正确性在本节合流:测试保正确,量化保性能,两者都建立在"样本在手"这个朴素前提上。
本节要点回顾
- 默认贪婪,
.*?懒惰,提取标签内容优先考虑[^<]+这类排除写法 - 嵌套量词是灾难性回溯的标配,可互相顶替的字符类组合要重写
- 锚点、具体字符类、互斥结构是压缩回溯的三件套
qr//预编译,海量行复用同一模式时的标准做法- 超长输入先截断,防住病态行拖垮整条流水线