7.2 调试技巧
7.2 调试技巧
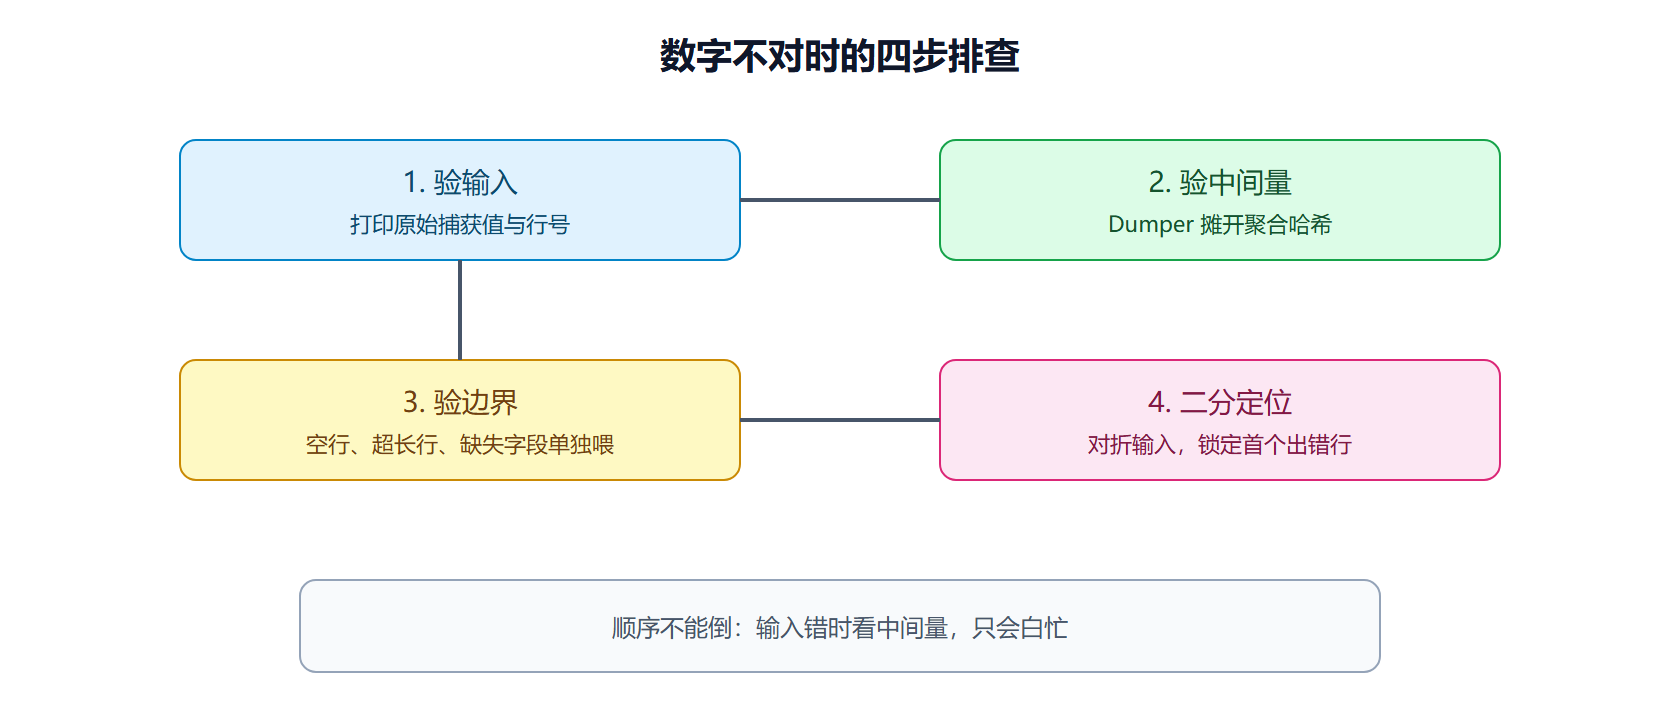
统计类 bug 的排查路线是固定的:先验输入、再验中间量、最后验边界。三板斧是打印诊断、Data::Dumper 看结构、二分定位;配上内置调试器处理难缠情况。
案例开场:平均耗时是负数
一份报告的平均耗时出现负值。数字越界的 bug 别盯着算式看,按路线走:
# 第一步:验输入——ms 字段到底进了什么 warn "ms=[$ms] 行 $. \n" if $ENV{DEBUG};
把诊断挂上 DEBUG 环境变量,正式跑批不受影响,排查时 DEBUG=1 perl report.pl 打开。很快发现部分行 ms 捕获到了 -12——原始日志的耗时字段本身带负号(上游时钟回拨产物)。
# 第二步:加输入守卫 next if $ms < 0; # 或记入 bad_lines
Data::Dumper:把结构摊开看
嵌套哈希的统计错位,肉眼追引用链是低效的:
use Data::Dumper; $Data::Dumper::Sortkeys = 1; # 键排序,两次输出可 diff print Dumper(\%stat); # };
Sortkeys 打开后,两次运行的 Dumper 输出可以做文本对比——"改前 vs 改后"差在哪一层,一目了然。
统计 bug 的排查路线图
内置调试器与单行诊断
perl -d report.pl access.log # 交互式:n 单步、p 打印、b 12 下断点、q 退出 perl -MO=Deps,-p report.pl # 看 deparse 后的代码,排查优先级坑 perl -c report.pl # 只查语法不执行
-d 适合大脚本;中小问题上 DEBUG 打印更快。另一个值得养成的习惯:可疑表达式用 B::Deparse 看它实际怎么结合——print -1 * $x ** 2 这类优先级疑问,depase 一秒出答案。
💡 关键直觉:修 bug 前先把出错场景固化成一条最小输入(一行日志、一个文件)。能复现的最小案例既用于定位,修完又直接变成第 7.3 节的测试用例。
第二个案例:总数对不上,差了 3 行
再走一遍完整路线,练熟"输入 → 中间量 → 边界"的节奏。现象:合并报告的行数比 wc -l 少 3。第一步验输入:两处统计口径先对齐——wc -l 数的是换行符,最后一行若无换行符则不计,先排除这种"假差"。第二步验中间量:在聚合处打印成功解析计数与跳过计数,发现 3 行进了坏行桶。第三步看边界:Dumper 这 3 行的原始内容,全是超过 2048 字符的超长行(被 4.3 节的截断守卫拦下后匹配失败)。修复不是放宽截断,而是把超长行单独落盘抽样观察——截断守卫拦下的正是要人工看的异常,统计口径里排除它们、报告里注明"另有 3 行超长未计入",两边的账就都清了。
if (length $line > 2048) { open my $lf, '>>', 'too_long.txt' or warn $!; print $lf $line; $skipped_long++; next; }
这个案例的教训是统计类 bug 的常态:多数"对不上"不是算错,而是口径不同——哪边的口径更合理需要业务判断,但两边必须显式声明,差异永远不该沉默存在。
防御性习惯清单
调试的高级形态是让 bug 没机会出生。工坊里沉淀下的五条防御习惯:统计入口处对负数、零、超长值设守卫(如上面的 ms < 0);所有 warn/die 带上下文(文件、行号、当前值),裸报错等于让人猜;脚本开头 use strict; use warnings; 并把 warnings 当测试跑,不是装饰;对外来数据默认不信任,字段类型与范围先验证再使用;任何"先临时关掉"的守卫,用醒目的注释标记并限期恢复。第五条最常见违例——三个月后发现某次"临时"注释掉的范围检查一直裸奔到现在。
日志式诊断:让脚本自己写病历
DEBUG 打印适合交互排查,无人值守的长跑脚本则需要一份"病历"——出了问题回看当时发生了什么。给脚本加一个轻量日志层,十分钟的事:
my $LOG; sub logit { my ($msg) = @_; $LOG //= do { open my $l, '>>', 'run.log' or die $!; $l; }; printf $l "[%s] %s\n", scalar localtime, $msg; } logit "开始处理 $dir,共 " . scalar(@files) . " 个文件"; process_one($_) == 1 and logit "$_ 完成" for @files; # 每文件记一行 logit "全部完成,总耗时 " . (time - $t0) . " 秒";
病历要记三类信息:进度里程碑(开始、每文件完成、结束)、关键计数(成功多少、跳过多少)、异常现场(哪个文件什么错)。量级控制住——按事件记而不是按行记,千万行日志的跑批病历也就几百行。它回本的方式很朴素:下次半夜出问题,你打开 run.log 而不是盯着脚本想象昨晚发生了什么,多数时候最后一行日志直接就是答案。这一层与 DEBUG 打印不冲突:DEBUG 给人看(即时、详尽),run.log 给未来的你看(持久、浓缩),两者共同构成工坊的"可观测性"。观测的粒度心法也一并记下:正常路径记里程碑(千行一记),异常路径记现场(每错必记)——日志的价值密度由异常记录决定,里程碑只是帮你定位"断在哪"。写日志最后一忌是完美主义:别想着设计一套完美格式再动手,先记起来、跑两周、按真实回看需求再调整——日志格式与正则一样,是要在使用中长出来的,不是一次性设计出来的。
让报错自带上下文:Carp 与致命化警告
裸 die 只报错误本身,不带调用现场。换成 use Carp qw(croak cluck);:croak 报错时带上调用者的文件与行号,定位"从哪一层调进来的"比裸报错快一个量级;cluck 在 warn 的同时打印完整调用栈,适合挂在深层嵌套的统计函数里当探针。另一个低成本改造是把最常见的噪音升级成硬错误:use warnings FATAL => 'uninitialized' 让"用了未初始化变量"从一行警告变成当场崩溃,配合 local $SIG{__WARN__} 捕获并打印堆栈,能直接揪出统计里悄悄出现的空值。正则表达式可疑时还有 perl -Mre=debug,它把匹配过程每一步的状态变化都打印出来——"这个正则为啥没匹配"这类问题,看 debug 输出通常比对着模式猜快。
本节要点回顾
- 诊断挂
DEBUG环境变量,正式运行零开销 - Dumper 加 Sortkeys,改前改后可文本对比
- 排查顺序固定:输入 → 中间量 → 边界 → 二分
perl -d处理大脚本,perl -c快速验语法- 最小复现案例顺手转测试,一次排查两份收益