7.3 自动化测试:Test::More
7.3 自动化测试:Test::More
Test::More 是 Perl 内置生态的测试框架:is 比对相等、like 比对正则、is_deeply 比对结构。给解析内核攒一套测试用例,每次改正则后跑三秒,回归立刻现形。
最小测试脚本
#!/usr/bin/perl use strict; use warnings; use Test::More tests => 5; use LogUtil qw(parse_line); my $good = '10.0.0.5 [12/Aug/2026:03:14:51] "GET /api/order" 200 12ms'; my $rec = parse_line($good); is $rec->{api}, '/api/order', '提取接口名'; is $rec->{status}, 200, '提取状态码'; is $rec->{ms}, 12, '提取耗时'; is parse_line('完全不是日志的一行'), undef, '垃圾行返回未定义'; like parse_line('10.0.0.5 [..] "GET /api/x" 503 999ms')->{status}, qr/^\d{3}$/, '状态码总是三位数字';
运行 perl t_parser.pl,输出逐条 ok/not ok:
ok 1 - 提取接口名 ok 2 - 提取状态码 ok 3 - 提取耗时 ok 4 - 垃圾行返回未定义 ok 5 - 状态码总是三位数字
改动解析正则后重跑,任何一条变 not ok 都是大声警告:上次修好的场景又坏了。
三个最常用的断言
| 断言 | 比什么 | 典型用途 |
|---|---|---|
is $got, $want, '说明' |
相等 | 字段值、返回值 |
like $got, qr/.../ |
匹配正则 | 格式约束(三位数字、IP 形状) |
is_deeply $got, $want |
整个结构 | 聚合哈希、嵌套输出 |
is_deeply 是统计逻辑的守护神——把期望的统计结构整个写出来比对,比逐字段 is 更省事也更严:
my %stat; LogUtil::aggregate(\%stat, { api => '/a', ms => 10 }); LogUtil::aggregate(\%stat, { api => '/a', ms => 30 }); is_deeply \%stat, { '/a' => [2, 40] }, '两次累加正确';
一次回归的完整循环
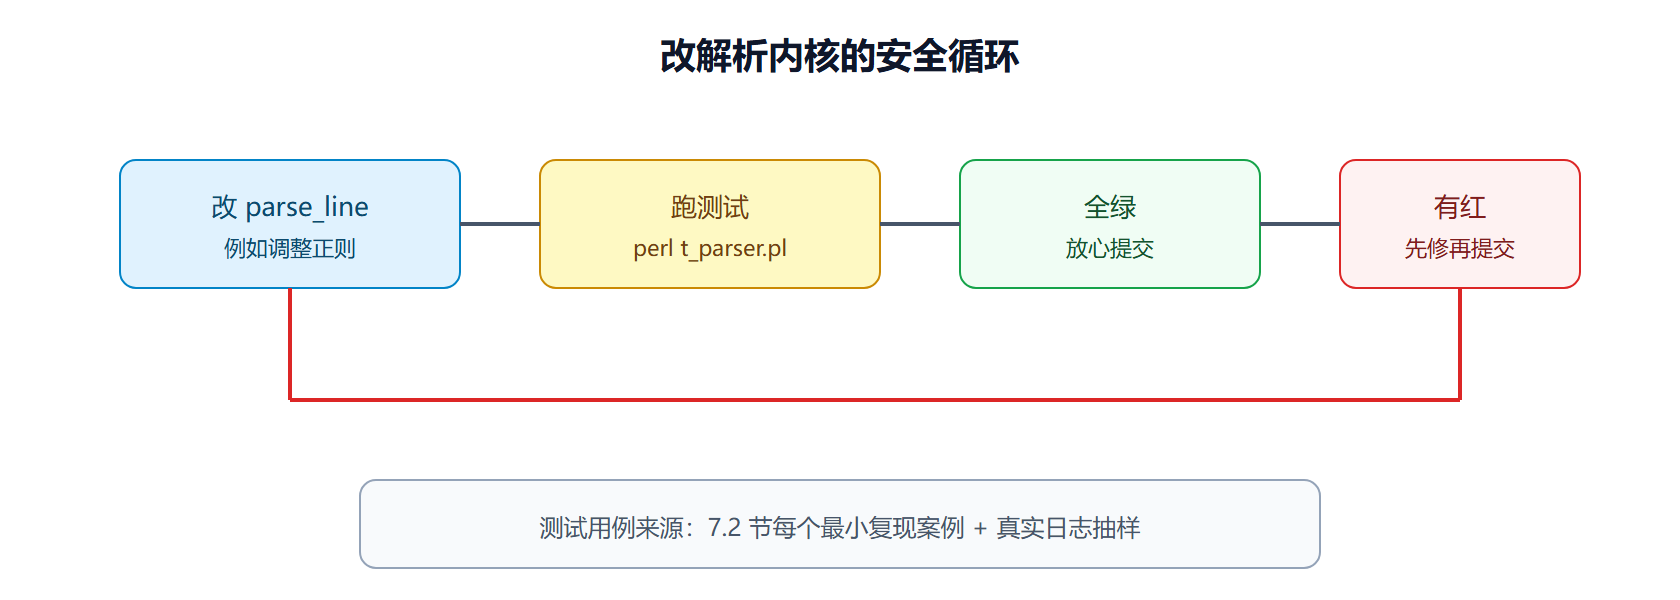
⚠️ 常见坑:测试只喂"正常行"。把空行、残缺行、超长行、负数耗时这些真实世界会出现的输入都收进用例集,垃圾行测试(返回 undef)往往比正常行测试救的命更多。
prove 与测试目录的标准布局
单文件测试跑通后,把它挪进 t/ 目录,用 prove 统一驱动,这是 CPAN 世界的标准布局:
t/ 00_load.t # 模块能加载 01_parse.t # 解析内核用例 02_aggregate.t # 统计累加用例 logutil_report.log # 汇总输出 prove -v t/ # -v 显示每条断言;不带参数默认跑 t/ # Result: PASS
prove 的价值在细节:失败时给出是哪个文件第几条断言;--merge 把测试里的诊断输出并入日志方便回看;退出码遵循惯例(全绿零、有红非零),可直接接 cron 与发布脚本——"测试不绿不许上桌"由此可以自动化执行。测试数不用预先声明时,结尾写 done_testing; 替代 tests => N,增删用例不用回头改数字。
测试驱动修 bug 的标准节奏
把 7.2 节的调试循环与测试合流,得到修 bug 的标准节奏,也回答"什么 bug 值得写测试":
# 1. 先写复现(此刻是红的) is parse_line('10.0.0.5 [12/Aug/2026:03:14:51] "GET /a" 200 -12ms')->{ms}, -12, '负耗时按原样返回,由守卫层拦截'; # 3. 提交测试与修复,用例常驻回归集
节奏三步:红(复现)、绿(修复)、留(用例入库)。值得写测试的判断标准:凡是"修过一次的解析/统计逻辑"都该有对应用例——出过 bug 的路径就是被现实证明脆弱的路径,一个用例的成本远低于同款 bug 第二次进报告。
测试数据的治理:样本从哪来、放哪、怎么不腐烂
测试用例的灵魂是样本数据,样本的治理比断言本身更值得设计。三层做法:第一层,手造最小样本——两三个典型行加两个边界行,进版本库跟着代码走,这是底线;第二层,脱敏真实样本——从生产日志里挑代表性行,把 IP、用户名替换成假值后存进 t/data/ 目录,测试读取该文件批量断言,真实世界的怪格式只有真实样本能覆盖;第三层,生成器——用脚本按已知分布合成大样本,验证性能与规模化行为,但合成数据永远替代不了真实样本的"怪"。防腐烂的关键一招是让测试样本与解析版本互相锁定:样本文件里记录"此样本适用于 parse_line 1.02",升级解析器跑一遍测试,若某些样本从"应解析成功"变成"应进坏行桶",改动影响面当场可见。样本治理投入的时间,会在每次改正则时不被默默咬伤的深夜里连本带利收回。最后补一个团队协作的约定:测试文件与代码同库同目录结构,提交信息里"改了什么、测了什么"并列写——测试在这里不只是质量工具,更是改动的说明书,读提交记录的人先看测试就知道这次变更的行为边界。给这个约定再配一条防衰退措施:测试数量只增不减的原则写进协作规范——删用例必须给出理由并单独成一次提交,让"悄悄删掉碍事的测试"在历史里无处遁形。
测试的组织方式直接影响维护成本。一个值得采用的约定是"一函数一文件":每个被测模块对应一个 t/ 下的测试文件,文件名与被测模块同名(如 t/parse_line.t 测 parse_line),测试内部按"正常输入、边界输入、垃圾输入"三组分组命名。这样定位失败时,报错行号 + 文件名的组合直接指向被测代码,不用在几十个测试文件里猜。配合 Test::Harness 跑全量时,任何一次回归都能在几秒内定位到具体函数,这正是测试要解决的问题。
本节要点回顾
- is / like / is_deeply 三板斧覆盖字段、格式、结构三类断言
- 垃圾输入必须有专门用例,解析器的稳健性就靠它们保证
- 最小复现案例直接转测试,排查成本二次利用
- 改内核 → 跑测试 → 全绿才提交,是工坊的质量纪律
- 测试文件独立存放,命名 t_ 前缀,跑批脚本永不加载它们