8.2 用 LWP 抓取网页
8.2 用 LWP 抓取网页
LWP 是 Perl 的 HTTP 客户端家族:LWP::Simple 一行取回网页,LWP::UserAgent 带超时、头部、重定向控制。抓回来的内容交给正则或 JSON 模块,就接进了已有流水线。
从最简单开始
use LWP::Simple qw(get); my $html = get('https://example.com/status'); defined $html or die "抓取失败"; print "页面长度 ", length($html), "\n";
get 失败返回 undef,一行判断足够。但要正经做事——设超时、带身份头、看状态码——就换 UserAgent:
use LWP::UserAgent; my $ua = LWP::UserAgent->new( timeout => 10, agent => 'logbot/1.0', ); my $res = $ua->get('https://example.com/api/meta'); if (!$res->is_success) { die sprintf "请求失败: %d %s", $res->code, $res->message; } my $body = $res->decoded_content; # 按头部自动解码
响应对象 $res 把状态码、头部、内容分开保管,is_success 判 2xx——永远判状态码再取内容,把 404 页面当数据解析是抓取脚本的经典事故。
抓 JSON 接口并接进统计
use JSON qw(decode_json); my $res = $ua->get('https://example.com/api/nodes'); die "接口不可用" unless $res->is_success; my $data = decode_json($res->decoded_content); for my $node (@{ $data->{nodes} }) { printf "%-20s %6.1f%%\n", $node->{name}, $node->{disk_used}; }
decode_json 把 JSON 转成第 2.4 节那套引用结构,取值语法完全相同——工坊里学过的结构操作直接复用。
一次抓取的完整防护链
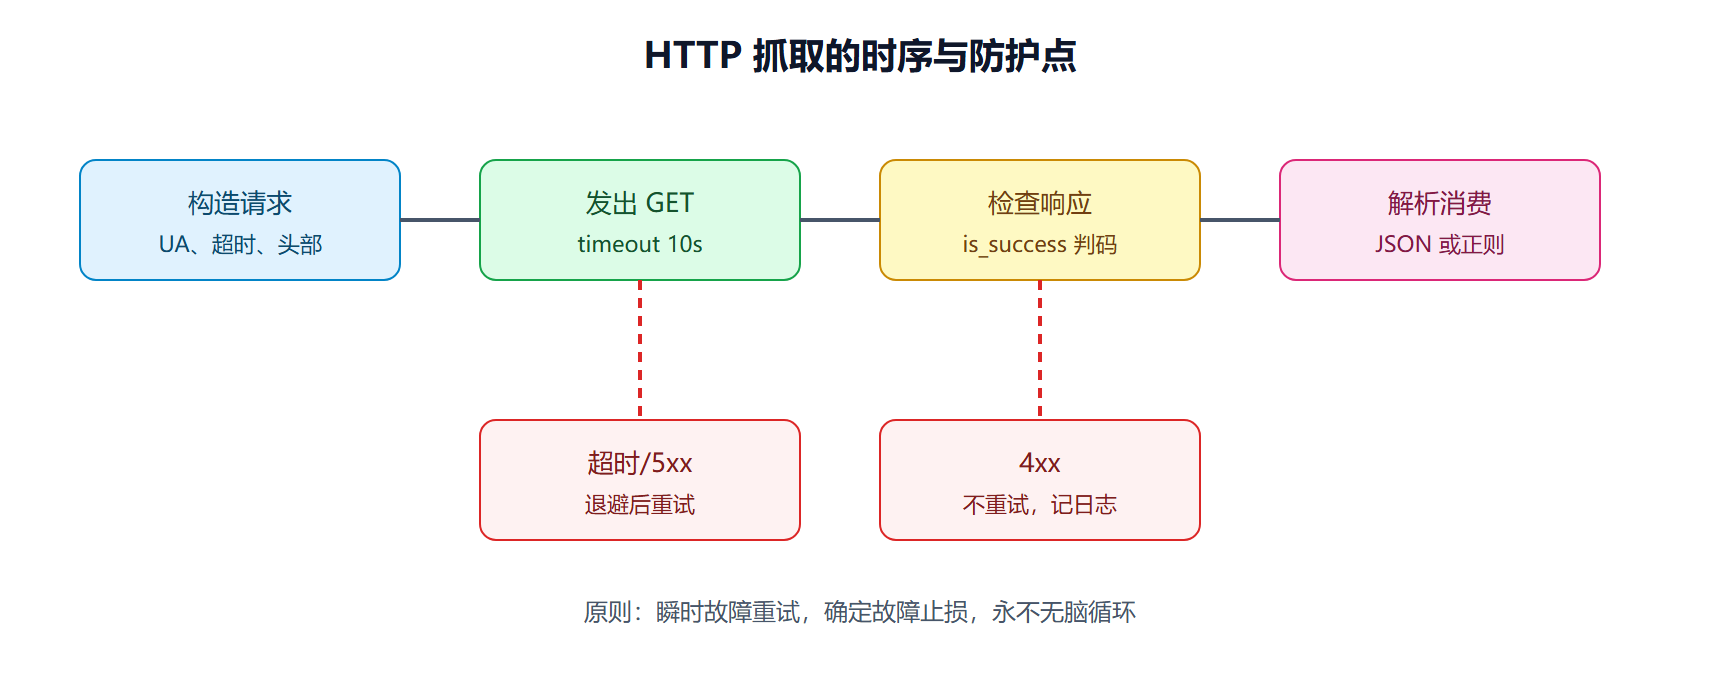
重试的简单实现:
sub fetch_retry { my ($ua, $url, $tries) = @_; $tries //= 3; for my $i (1 .. $tries) { my $res = $ua->get($url); return $res if $res->is_success; warn "第 $i 次失败: ", $res->status_line; sleep 2 ** $i; # 指数退避:2、4、8 秒 } return undef; }
⚠️ 常见坑:不给 timeout。默认 UA 可能长时间挂着等一个不通的服务,跑批脚本整个被拖死——
timeout => 10这行字省下的时间以小时计。
合规抓取的三条行规
抓取脚本迟早要面对"该不该抓、怎么抓"的问题,工坊行规三条:一看授权,接口有文档与开放条款的优先走正式接口,登录墙后的内容不碰;二控制节奏,串行加 sleep(哪怕 1 秒)、并发数压到个位数,把对方服务当自家服务爱惜——重试的指数退避正是节奏控制的延伸;三表明身份,agent 写真实名字与联系方式,出问题时对方能找到你而不是直接封 IP。这三条不是道德姿态,是抓取脚本能不能长期活下来的生存条件。
会话与认证:带 Cookie 的连续请求
需要登录态或多步接口的场景,UserAgent 自带 cookie jar 把会话串起来:
use HTTP::Cookies; my $ua = LWP::UserAgent->new( timeout => 10, cookie_jar => HTTP::Cookies->new, ); $ua->post('https://example.com/login', [ user => $u, pass => $p ]); # 登录,Set-Cookie 已入 jar my $res = $ua->get('https://example.com/api/report'); # 后续请求自动携带会话 Cookie
要点有二:凭据从环境变量读取而不是写死在代码里($ENV{API_USER}),脚本进版本库不带密码;登录响应也要判 is_success,登录失败后的"接口 403"经常被误报成接口故障,第一现场的报错信息要能区分这两者。
解析 HTML:结构与杂音的分界
接口优先的时代仍免不了要碰 HTML,解析它别用正则硬上——嵌套标签让正则的"字段"假设彻底失效。标准做法是 HTML::TreeBuilder 把页面变成树,然后按结构取值:
use HTML::TreeBuilder; my $tree = HTML::TreeBuilder->new_from_content($res->decoded_content); my @rows = $tree->find_by_tag_name('table')->find_by_tag_name('tr'); for my $tr (@rows) { my @cells = map { $_->as_trimmed_text } $tr->find_by_tag_name('td'); next unless @cells == 3; # 按列数过滤表头与杂行 printf "%-20s %10s %10s\n", @cells; } $tree->delete; # 显式释放,树结构占内存
结构化解析的容错力体现在 next unless @cells == 3 这一行:页面加个广告单元格、表头样式行,按结构断言过滤即可,正则方案遇到同样的变化只能重写。选择依据一句话收束:HTML 是结构数据,用结构工具;只有"从一个丑页面里抠一个数字"这种一次性脏活,才允许正则速战速决,且代码标注"临时"。
本节要点回顾
- 快速取页用 LWP::Simple,正经抓取用 UserAgent
- timeout 必设,is_success 必判
- JSON 用 decode_json,转成引用结构后复用已有操作
- 重试配指数退避,瞬时故障扛、确定故障停
- 抓取内容即流水线输入,解析、统计、入库一路复用