8.3 数据库交互 DBI
8.3 数据库交互 DBI
DBI 是 Perl 的数据库标准接口:connect 建连、prepare 编译、execute 执行、fetch 取行。占位符(?)是安全底线——拼接 SQL 的脚本等于开着门运行。
连接与查询的标准流程
use DBI; my $dbh = DBI->connect( 'DBI:mysql:database=logs;host=127.0.0.1', 'loguser', 'secret', { RaiseError => 1, AutoCommit => 1, mysql_enable_utf8 => 1 }, ) or die "连接失败: $DBI::errstr"; my $rows = $dbh->selectall_arrayref( 'SELECT api, COUNT(*) FROM access_log GROUP BY api ORDER BY 2 DESC LIMIT 10', { Slice => {} }, # 返回哈希引用数组 ); for my $r (@$rows) { printf "%-40s %8d\n", $r->{api}, $r->{'COUNT(*)'}; } $dbh->disconnect;
不同数据库只换 DSN 首段(DBI:Pg:、DBI:SQLite:),后面的代码不变——这就是接口层的意义。
占位符:唯一正确的传参方式
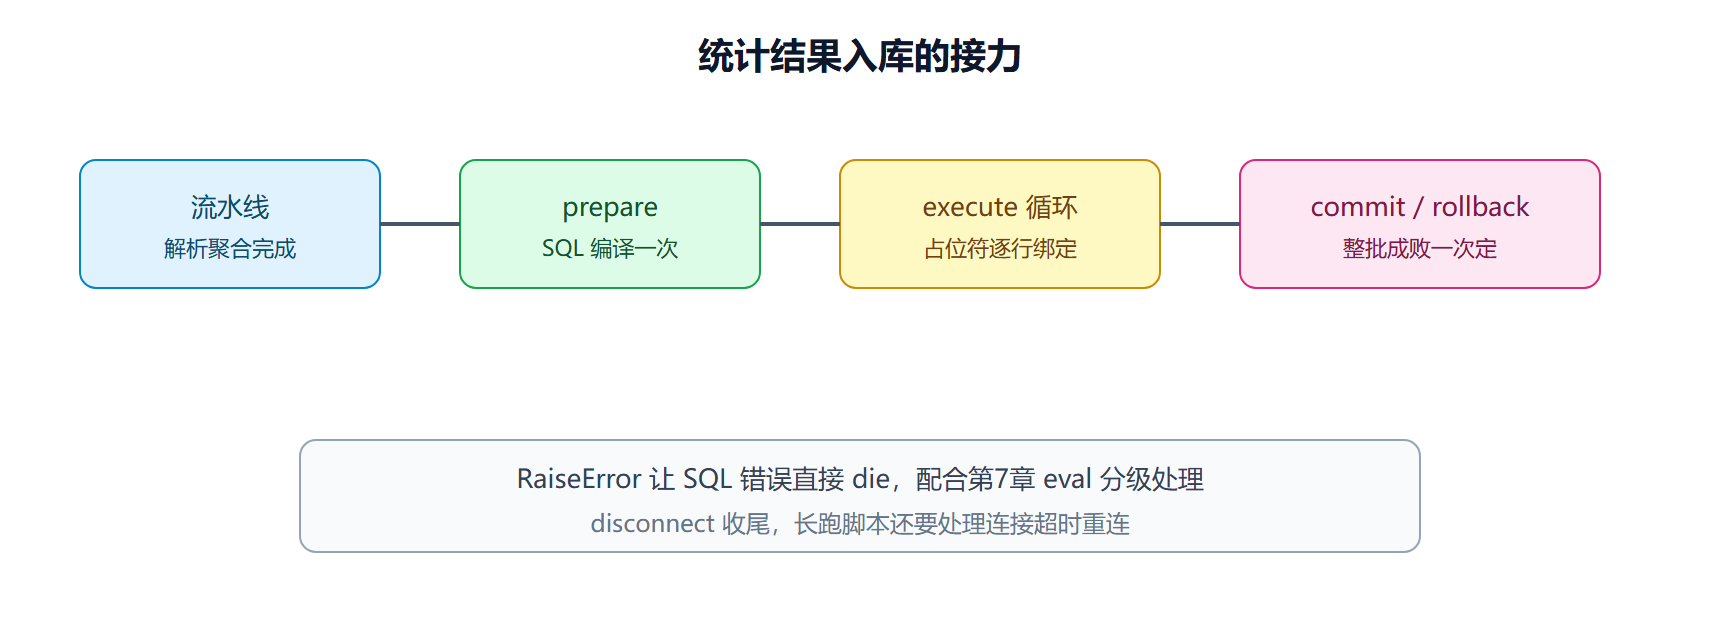
my $sth = $dbh->prepare( 'INSERT INTO access_log (ip, api, status, ms) VALUES (?, ?, ?, ?)' ); while (my $line = <>) { my $rec = parse_line($line) or next; $sth->execute($rec->{ip}, $rec->{api}, $rec->{status}, $rec->{ms}); }
问号处的值由驱动转义,引号、分号都只是数据。反面教材 "INSERT ... VALUES ('$ip', ...)" 在 ip 字段含引号时直接报错,被恶意构造时就是注入。占位符没有例外场景,静态值直接写进 SQL,动态值一律走问号。
提交策略:事务包批量
$dbh->{AutoCommit} = 0; # 接管事务 my $ok = eval { for my $rec (@records) { $sth->execute(@$rec{qw(ip api status ms)}); } $dbh->commit; # 一次提交 1; }; if (!$ok) { $dbh->rollback; # 全部撤销,不留半批 warn "本批入库失败已回滚: $@"; } $dbh->{AutoCommit} = 1;
十万行逐条自动提交既慢又危险:跑到第九万条断电,库里留下九万条没对账的数据。一批一个事务,要么全进、要么全无。
一次入库的数据路径
⚠️ 常见坑:
do方法适合一次性语句,但循环里逐条$dbh->do("INSERT ... $x")是双重反模式——既拼了字符串又丢了预编译。循环插入永远 prepare 一次、execute 多次。
连接管理:凭据、超时与长寿脚本的活叉
三个连接层面的工程细节。凭据不落代码:DSN、用户、密码从环境变量读,脚本进版本库不带秘密:
my $dbh = DBI->connect( $ENV{LOGDB_DSN}, $ENV{LOGDB_USER}, $ENV{LOGDB_PASS}, { RaiseError => 1, AutoCommit => 1 }, );
连接超时在 DSN 层配(如 mysql_connect_timeout=5),不给超时的连接在数据库主机假死时会挂住整个跑批。第三是常驻或长时间脚本要处理"连接被服务端踢掉":执行前 $dbh->ping 探活,失败则重连一次再试,把重连封装成函数,比让半夜的批处理死在 "MySQL server has gone away" 体面得多。
入库性能:批量执行的量级差异
十万行级别除了事务,还有 execute 的批量 cousins——execute_array 或按库而定的多值插入,量级差异值得知道:
# SQLite/MySQL 通用:攒批多值插入 my @batch; while (my $rec = next_record()) { push @batch, [ @$rec{qw(log_date ip api status ms)} ]; if (@batch == 500) { insert_batch($dbh, \@batch); # 500 行一条 INSERT @batch = (); } } insert_batch($dbh, \@batch) if @batch; # 收尾批 sub insert_batch { my ($dbh, $rows) = @_; my $ph = join ',', map { '(' . join(',', ('?') x 5) . ')' } @$rows; $dbh->do( 'INSERT INTO access_log (log_date,ip,api,status,ms) VALUES ' . $ph, undef, map { @$_ } @$rows, ); }
这里拼的是占位符框架、值仍走绑定参数,安全性与单条 execute 相同。十万行的入库时间从分钟级压到秒级,批大小 500 到 1000 是通用甜点区——太大超过包长上限,太小批量收益不明显。
查询侧的三个实用技巧
读数据这一侧也有三个值得固化的习惯。技巧一,取值方式按需选:selectrow_array 拿单行(my ($n) = $dbh->selectrow_array(...)),selectcol_arrayref 拿单列(比如"所有出现过慢请求的日期清单"),selectall_arrayref 加 Slice 拿整表——用对方法少写一层循环。技巧二,LIMIT 与分页:交互式探查数据时永远带 LIMIT,一条没约束的查询在千万行表上会把内存吃穿。技巧三,列名绑定别名:聚合列在驱动里名字五花八门(COUNT(*) 的键名各库不同),SQL 里显式起别名 COUNT(*) AS n,Perl 侧统一 $r->{n},换库不改代码。
my $dates = $dbh->selectcol_arrayref( 'SELECT DISTINCT log_date FROM access_log WHERE ms > 1000 ORDER BY log_date' ); printf "出现过慢请求的日期共 %d 天,最近 %s\n", scalar @$dates, $dates->[-1];
这三招不涉及任何高深机制,全是"少写代码、少踩兼容坑"的经验沉淀,但恰恰是这类细节决定 DBI 脚本写起来是顺手还是处处别扭。
本节要点回顾
- connect → prepare → execute → fetch → disconnect 五步是固定骨架
- 动态值只走占位符,拼接 SQL 一票否决
- 批量入库包事务,AutoCommit 关掉,整批 commit
- RaiseError 交给第 7 章 eval 体系,错误分级保持一致
- DSN 换前缀即换库,其余代码不动