1.1 一个连接的诞生:PostgreSQL 与客户端的三次握手
1.1 一个连接的诞生:PostgreSQL 与客户端的三次握手
本节摘要:PostgreSQL 采用每连接一进程的架构。客户端发起连接后,postmaster 守护进程 fork 出一个专属 backend,完成身份验证后双方直接通信。这套模型简单可靠,但每个连接都是一个操作系统进程,吃独立的内存——这决定了连接数的上限远比想象中低。
从敲下回车那一刻说起
psql -h 127.0.0.1 -p 5432 -u app_user -d orders
这行命令背后发生了三步:
- 建立 TCP 连接:客户端与 5432 端口完成三次握手,postmaster 的监听 socket 收到新连接
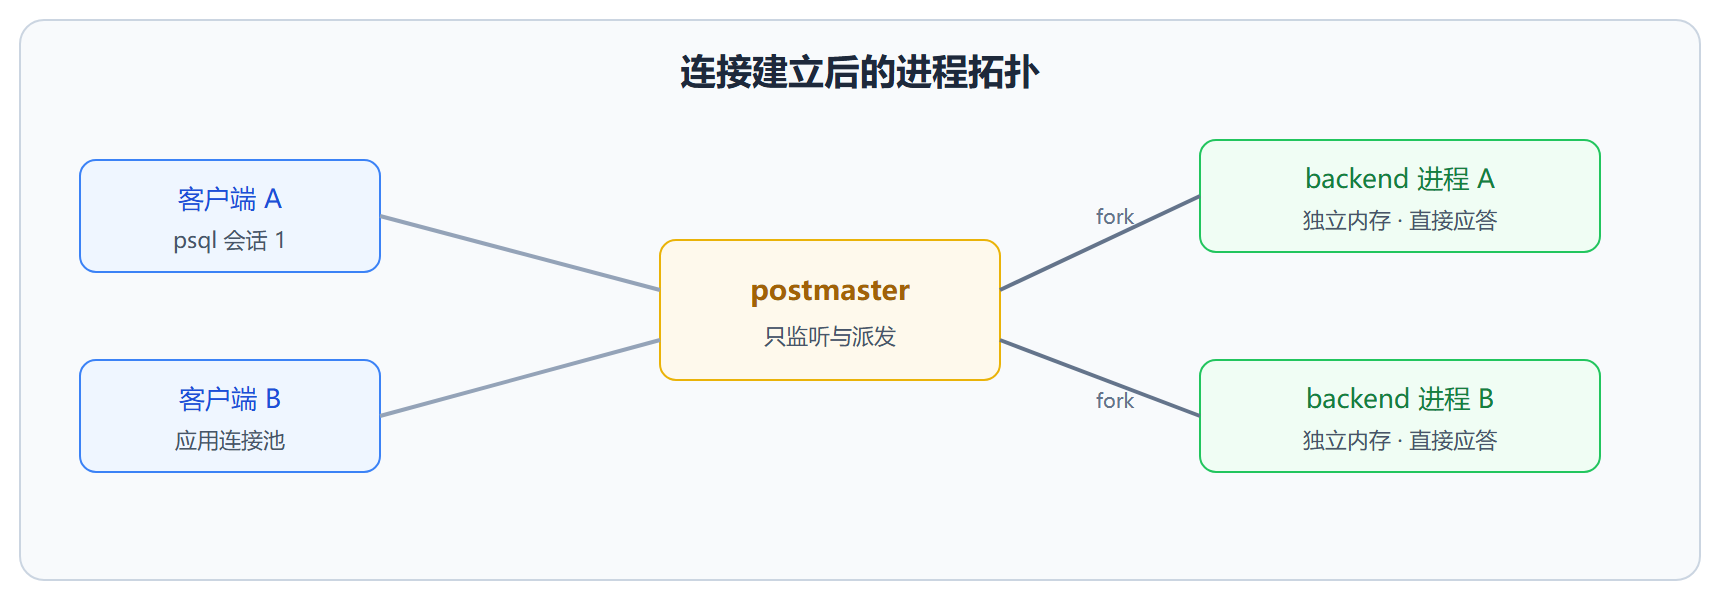
- fork backend:postmaster 不亲自服务,而是 fork 一个子进程,把连接移交给它。此后 postmaster 继续回去监听,客户端与 backend 点对点通信
- 身份验证:backend 根据配置的认证方式(口令、scram、证书等)核验身份,加载该用户的权限快照
postmaster 与 backend 是父子关系,但 postmaster 从不插手后续的 SQL 处理。它的另一职责是"收尸":任何 backend 异常退出,postmaster 负责回收资源,并触发崩溃恢复流程。
进程视图:眼见为实
连上数据库后,在操作系统层面可以直接看到这些进程:
# 在数据库所在主机上查看 ps -ef | grep postgres
典型输出里有五类进程:
| 进程 | 职责 | 数量 |
|---|---|---|
| postmaster | 监听连接、fork backend、崩溃后重启 | 1 |
| backend | 服务一个客户端连接 | 每连接 1 个 |
| background writer | 后台刷脏页 | 1 |
| checkpointer | 执行检查点 | 1 |
| autovacuum launcher | 派发清理任务 | 1 |
图:一个连接建立后的进程拓扑
每个连接的内存账单
backend 不是轻量级线程,而是一个完整进程。工作内存区域按连接独立分配:work_mem 在排序、哈希等操作时按需申请——一个复杂查询里可能出现多个 work_mem 级别的分配。粗略估算,一个几乎空闲的连接也要占几 MB,做重活时几十上百 MB 都正常。
这就是为什么生产环境几乎必配连接池组件:应用直连几千条连接,光进程切换与内存占用就能把服务器拖垮,哪怕每条连接都闲着。连接池把"应用并发"与"数据库连接"解耦,几十条复用连接往往就够了。
⚠️ 常见坑:max_connections 调到 5000 治不了"连接不够用",反而放大内存与调度开销。先上连接池,再谈连接数。
连接打满的现场排查
每连接一进程的架构意味着连接是稀缺资源,"too many clients" 是生产环境最常见的告警之一。完整的排查链路是先看余量、再看构成、最后看源头:
-- 第一步:还剩多少连接额度 SELECT setting::int AS max_connections, (SELECT count(*) FROM pg_stat_activity) AS used, setting::int - (SELECT count(*) FROM pg_stat_activity) AS free FROM pg_settings WHERE name = 'max_connections';
max_connections | used | free -----------------+------+------ 200 | 197 | 3
-- 第二步:连接都处于什么状态、来自哪些应用 SELECT state, usename, application_name, count(*) FROM pg_stat_activity GROUP BY state, usename, application_name ORDER BY count(*) DESC;
典型病根有两类。一类是 idle 连接堆积:应用池配置过大(比如五十个服务实例各配一百条连接),实际活跃的只有几十条,剩下几百个进程纯粹占着内存与进程表。另一类是 idle in transaction:代码开了事务后异常路径忘了回滚,这些连接不仅占坑,还持有快照阻断 VACUUM(第 2 章会展开这个连锁反应)。
处置手段从温和到激烈:先杀空闲事务会话,再考虑临时调大 max_connections(需要重启才生效,且只是争取时间),根治永远是收缩应用侧连接池并引入中间层池化。
-- 终止所有空闲超过十分钟的事务会话(先 SELECT 确认再执行) SELECT pg_terminate_backend(pid) FROM pg_stat_activity WHERE state = 'idle in transaction' AND now() - state_change > interval '10 min';
认证失败的三种面孔
握手第三步是身份验证,认证配置文件按"数据库、用户、来源地址、认证方式"逐条匹配,取第一条命中。新手常被三种报错绕晕,其实各有明确含义:
| 报错 | 含义 | 排查方向 |
|---|---|---|
| no pg_hba.conf entry for host ... | 来源地址没有任何一条规则接纳 | 认证配置里加条目或修正客户端地址段 |
| password authentication failed | 规则命中了,但口令不对 | 核对角色口令与认证方式是否匹配 |
| role "xxx" does not exist | 用户名本身不存在 | 确认连接串里的用户名与角色创建记录 |
值得单独一提的是 scram 认证:角色口令的加密方式存在角色属性里,如果角色是用旧的 md5 方式创建的,服务端却配置了 scram 认证,握手会直接失败——这不是口令错误,是加密机制对不上。升级认证体系时,改配置与改角色口令要配套进行。
留给运维的三个参数
连接行为有三个参数值得写进基线配置。superuser_reserved_connections(默认三)给超级用户预留名额,普通连接打满时管理员仍能登进来救火,不要把它调为零。idle_in_transaction_session_timeout 设一个上限(比如十分钟),让忘关的事务会话自灭,是防"长事务毒药"的自动化保险。authentication_timeout(默认三十秒)限制认证阶段的等待,防止慢客户端拖住 fork 出的进程。这三个参数共同的特点是:平时不起作用,出事时决定你有没有资格处理事故。
本节要点回顾
- 每连接一进程:postmaster 只监听与 fork,服务由 backend 独立完成
- 崩溃隔离:backend 挂掉会触发全库崩溃恢复,这是进程模型换可靠性的代价
- 内存独立:work_mem 等区域按连接分配,连接数与内存是乘法关系
- 连接池是标配:复用少量连接承载高并发,而不是调大连接上限