1.2 一条 SQL 的服务端旅程:五段流水线
1.2 一条 SQL 的服务端旅程:五段流水线
本节摘要:SQL 是声明式语言,你说"要什么",引擎决定"怎么拿"。从字符串到结果集,一条语句要经过解析、分析、重写、规划、执行五段流水线。每一段做的工作不同、报的错也不同,定位问题时先判断卡在哪一段,效率完全不一样。
五段流水线与各自的错误现场
拿这条语句当样品:
SELECT department, count(*) FROM emp WHERE salary > 10000 GROUP BY department;
它在 backend 内部的旅程:
| 阶段 | 输入 → 输出 | 典型错误 |
|---|---|---|
| 解析器 | 文本 → 语法树(只认结构) | syntax error,光标指出错位置 |
| 分析器 | 语法树 → 查询树(绑定表、列、类型) | relation does not exist、column 不存在 |
| 重写器 | 查询树 → 查询树(展开视图、规则) | 视图缺少可更新列时报错 |
| 规划器 | 查询树 → 计划树 | 不报错,但可能选错计划 |
| 执行器 | 计划树 → 结果集 | 运行期错误,如除零、类型转换失败 |
一个容易被忽略的推论:列名写错在分析阶段就报错,不会等到执行。而"跑得慢"几乎总是规划器与执行器这一段的问题——第 5 章整章都在讲它。
重写器:视图魔法发生的地方
视图在 PostgreSQL 里不是"特殊对象",而是一条命名查询。创建视图时:
CREATE VIEW high_paid AS SELECT department, salary FROM emp WHERE salary > 8000; -- 对视图的查询,会被重写器展开成对基表的查询 SELECT department FROM high_paid WHERE salary > 15000; -- 重写器实际交给规划器的是: -- SELECT department FROM emp WHERE salary > 8000 AND salary > 15000;
两个条件会被合并处理,规划器看到的是纯基表查询。所以视图不会引入额外的查询层开销——这是很多从其他数据库迁移过来的人第一次感到意外的地方。
执行器:火山模型
执行器按"火山模型"组织算子:每个算子向下一层要一行、处理、向上一层交一行。扫描算子(顺序扫描、索引扫描)在最底层从缓冲区取页面,过滤、连接、聚合层层向上堆叠。
EXPLAIN SELECT department, count(*) FROM emp WHERE salary > 10000 GROUP BY department;
QUERY PLAN --------------------------------------------------------- HashAggregate (cost=178.06..178.17 rows=11 width=14) -> Seq Scan on emp (cost=0.00..158.00 rows=1333 width=10) Filter: (salary > 10000)
计划树的缩进结构就是火山模型的层级:HashAggregate 拉动 Seq Scan,Seq Scan 每次吐一行经过过滤再上交。cost 两列数字是规划器的记账本,第 5 章第 2 节会拆开它的算法。
图:五段流水线与错误定位
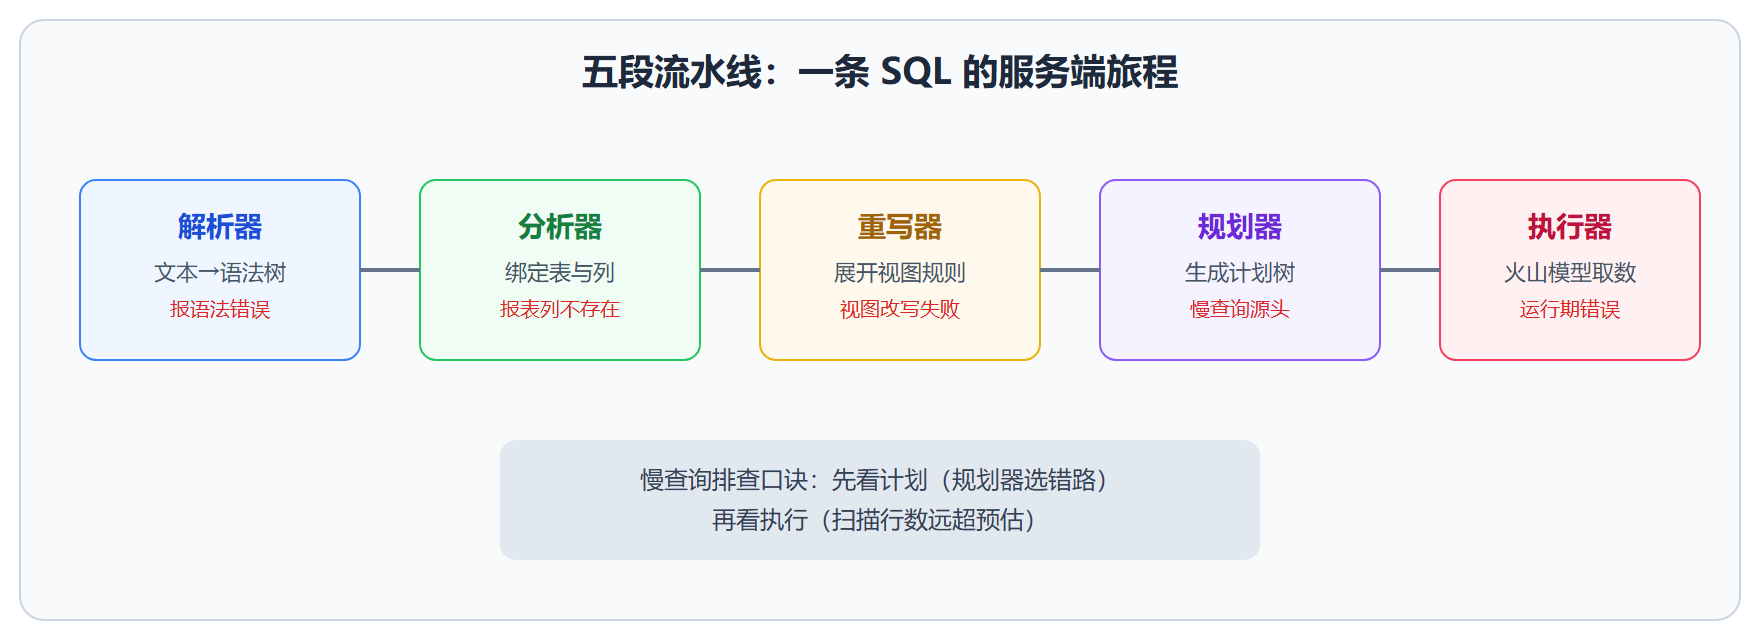
💡 关键直觉:SQL 慢只有两大类原因——计划不对(规划器的锅)或计划对但数据量大(执行器的账)。EXPLAIN 输出的 estimated rows 与实际 rows 的差距,是区分两者的第一线索。
三个报错案例的分段定位
掌握流水线最快的办法是拿报错当教材。三个真实案例,每个都先看现象再判断发生在哪一段。
案例一:应用日志大量出现 column "departmnt" does not exist。列名拼错,分析阶段绑定列对象时失败——注意它不是语法错误,"departmnt"是合法的标识符,解析器放行,分析器查系统目录找不到这列才报错。快速验证的办法是给正确的列名加双引号重跑,报错消失即证实是拼写问题。
案例二:一条跑了半年的报表 SQL 突然报 could not determine polymorphic type。函数调用缺少类型上下文,出现在重写或分析阶段对函数签名的推导中。这类错往往伴随"最近改过表结构或函数定义",对照变更记录检查函数入参的类型推断链即可定位。
案例三:语法完全正确的语句偶尔报 out of range,偶尔又正常。这种"薛定谔的报错"几乎必然在执行阶段——除零、日期溢出、数值越界都取决于具体数据行,哪次扫到脏数据哪次爆。处理思路是给表达式加防护(NULLIF、CASE)或在数据侧修复,而不是反复检查 SQL 写法。
三案例的共性:报错信息里藏着阶段编号式的线索。凡是在看到任何数据之前就能报的错,都在前三段;依赖具体数据才触发的错,都在执行段。
预备语句:把前三段缓存起来
同一条 SQL 反复执行(典型如应用里的循环查询)时,解析、分析、重写三段的工作产物完全可以复用。PREPARE 就是这个机制的直接暴露:
PREPARE get_dept (int) AS SELECT department, count(*) FROM emp WHERE salary > $1 GROUP BY department; -- 第一次执行:完整走五段 EXECUTE get_dept(10000); -- 后续执行:跳过前三段,直接进规划缓存取计划(参数化后计划可复用) EXECUTE get_dept(12000); -- 用完释放 DEALLOCATE get_dept;
应用侧的驱动大都用扩展协议把这件事做成了默认行为。收益有两面:省 CPU 是显性的;隐性的代价是"参数化后只有一份计划"——如果参数取值分布极不均匀(百分之九十九的行匹配参数一时走全表扫最快,参数二时走索引最快),一份通用计划可能两头都不优。这就是数据库层连接池与计划缓存场景下偶发的"应用直连快、上池化后慢"的机制解释之一,处理手段是对该语句退回每次规划的定制计划。
用日志亲眼看两次重写
把两个调试开关打开,视图展开的过程会直接打印在日志里:
SET debug_print_parse = on; -- 输出解析阶段的原始语法树 SET debug_print_rewritten = on; -- 输出重写阶段改写后的查询树 SET client_min_messages = log; -- 让这些输出在当前会话可见 SELECT department FROM high_paid WHERE salary > 15000;
日志先打出解析树,其中还能看到视图名 high_paid;再打出的重写树里,视图名已被基表 emp 替换,两个薪资条件并列出现在约束列表中。两棵树之间的差异,就是重写器这一段做的全部工作。生产库别开这两个开关(日志量巨大),但在实验实例上跑一次,"视图零开销"就从结论变成了亲眼所见。
本节要点回顾
- 五段流水线:解析、分析、重写、规划、执行,各报各的错
- 视图零成本:重写器把视图查询展开成基表查询,无额外间接层
- 火山模型:算子逐行拉动,EXPLAIN 的缩进就是算子层级
- 错误先分段:语法错在前两段,性能问题在后两段