2.1 页面结构与堆表物理布局
2.1 页面结构与堆表物理布局
本节摘要:堆表在磁盘上是一串固定 8KB 的页面文件,每个页面自上而下是页头、行指针数组,自下而上是元组数据,两头向中间生长。行在页内的位置由 ctid 标识。这套"页内双端生长"的布局,直接决定了后面几章讲的版本链、页分裂与空间回收方式。
8KB 里的乾坤
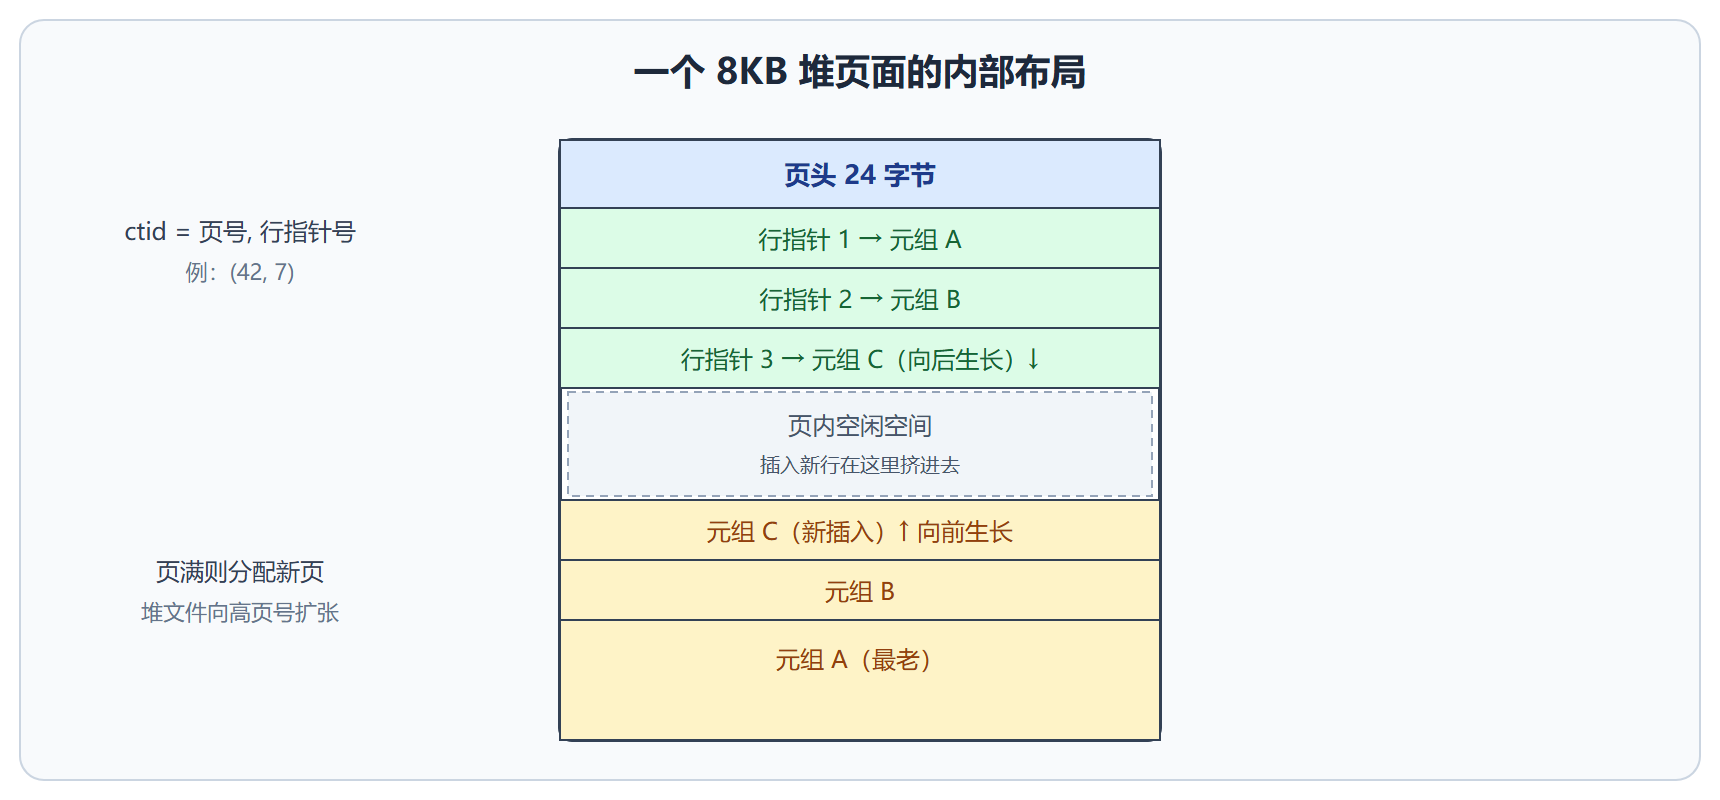
PostgreSQL 的页面大小编译期固定为 8192 字节。一张表就是若干这样的页面串成的堆文件,页面从 0 开始编号。单个页面内部:
- 页头:24 字节,记录空闲空间起止指针、校验和等
- 行指针:每个 4 字节,从页头之后向后生长,指向页内某条元组的物理偏移
- 元组数据:真正的行数据,从页尾向前生长
两头向中间挤,中间剩下的空洞就是页的空闲空间。行指针一旦分配不会真正"删除"(只标记为可复用),所以 ctid 的"行号"语义只在页内稳定。
-- 每张表都有隐藏的系统字段 SELECT ctid, xmin, xmax, id, name FROM customer LIMIT 3;
ctid | xmin | xmax | id | name -------+----------+----------+----+------- (0,1) | 10485770 | 0 | 1 | Alice (0,2) | 10485771 | 0 | 2 | Bob (0,3) | 10485775 | 10485790 | 3 | Carol
ctid 是"页号,行指针号"。Carol 那行 xmax 非 0——它已被某个事务标记删除或更新,2.2 节接着讲。
图:8KB 页面的双端生长布局
表膨胀的第一现场
理解页面布局后,一个重要推论自然浮出:行指针数组与元组从两端把页面填满,中途"删除"的元组只把空间还回页内空洞,不还给操作系统。表文件只增不减(除非做激进收缩),这就是"表膨胀"的物理根源。
-- 观察一张表的空间构成 SELECT pg_size_pretty(pg_relation_size('customer')) AS 表数据, pg_size_pretty(pg_indexes_size('customer')) AS 索引, n_dead_tup AS 死元组数 FROM pg_stat_user_tables WHERE relname = 'customer';
页内空洞会优先被同页的新插入复用;只有当整页几乎全空时,VACUUM 才可能把该页从堆里"摘除"(把末尾空页还给操作系统)。中间的空洞永远留在文件里,等待复用。
💡 关键直觉:PostgreSQL 的 DELETE 是逻辑动作——页面数不会少,表文件大小不会降。空间管理是"内部复用"而非"外部归还"。
用 pageinspect 拆开一个页
页面布局不是纸上谈兵,pageinspect 扩展能把一个 8KB 页的内部字段原样抖出来:
CREATE EXTENSION IF NOT EXISTS pageinspect; -- 取 customer 表第 0 号页的页头 SELECT * FROM page_header(get_raw_page('customer', 0));
lsn | checksum | flags | lower | upper | special | pagesize | version | prune_xid -----------+----------+-------+-------+-------+---------+----------+---------+----------- 0/4A2B180 | 0 | 0 | 80 | 2416 | 8192 | 8192 | 4 | 0
lower 是行指针数组的末端(也是空闲空间起点),upper 是元组数据的起点(空闲空间终点)。80 减 24 得 14 个行指针,2416 到 8192 之间还有约 5.6KB 可用——两头向中间生长的布局在这里就是两个数字。
-- 再看页内前三条元组的物理形态 SELECT lp, lp_off, lp_len, t_xmin, t_xmax, t_field3 AS t_cid FROM heap_page_items(get_raw_page('customer', 0)) LIMIT 3;
lp | lp_off | lp_len | t_xmin | t_xmax | t_cid ----+--------+--------+--------+--------+------- 1 | 8144 | 39 | 1074 | 0 | 0 2 | 8104 | 40 | 1074 | 0 | 0 3 | 8064 | 39 | 1074 | 0 | 0
lp_off 从 8144 往小走,印证元组从页尾向前堆;t_xmin 相同说明这批行是同一个事务批量插入的。对同一页做一次更新再回看,会看到新元组出现在更小的偏移处,旧元组的 t_xmax 被填上——2.2 节的版本链实验就是从这里长出来的。
空闲空间地图与插入路径
每次插入前,规划插入路径要回答"哪个页还有空间"。逐页拆开看太慢,PostgreSQL 为每个堆表维护一张空闲空间地图(FSM):以树状结构为每个页记一个粗粒度的剩余空间等级。INSERT 优先从 FSM 找到"够大且最满"的页塞进去——选最满是为了把空页留给更大的行。
观测它的直接手段是 pg_freespacemap 扩展:
CREATE EXTENSION IF NOT EXISTS pg_freespacemap; -- 表内各页的可用空间分布:满页多说明空间利用紧凑 SELECT avail, count(*) FROM pg_freespace('customer') GROUP BY avail ORDER BY avail DESC LIMIT 5;
与 fillfactor 的关系在此接上:fillfactor 90 的表,插入只在页内填到九成便申请新页,剩下的一成留给未来的 HOT 更新。也就是说插入时的"浪费"是更新时的"预留",两张地图(FSM 管插入、可见性映射管清理)共同决定了一个表的空间节奏。
排错案例:插入越跑越慢
一张订单表每天定时批量插入,起初每批十秒,三个月后涨到一分多钟。慢查询日志里 INSERT 本身没有变化,变化的其实是空间结构:大量更新留下的页内空洞使 FSM 里"看起来有空间"的页很多,但每个都塞不下整批插入的大行,插入路径反复试探落空,且新行被迫散落到文件尾部,文件体积涨了三倍。
处置分三刀:先确认没有长事务卡住清理(2.3 节的排查视图);再对该表收紧 autovacuum 阈值让死元组及时回收;最后在维护窗口做一次在线重排把散乱页面压实。一个月后单批耗时回到十五秒以内。这个案例把本节与 2.4 节连起来:页面布局决定了性能退化的形式,清理机制决定了退化的速度。
本节要点回顾
- 8KB 页面双端生长:页头与行指针向下,元组向上,中间是空闲空间
- ctid 定位行:页号加行指针号,页内稳定但跨更新会变
- 删除只是留洞:空间回到页内,表文件不收缩
- 膨胀有物理根源:布局决定了必须靠 VACUUM 体系维持复用秩序