2.2 MVCC 版本链:xmin 与 xmax 的双人舞
2.2 MVCC 版本链:xmin 与 xmax 的双人舞
本节摘要:MVCC 的核心是"写不阻塞读、读不阻塞写",实现手段是每个元组自带 xmin(创建它的事务号)与 xmax(删除它的事务号)。UPDATE 等价于"删旧插新",旧版本留在原地服务还在跑的老事务。版本多了谁来回收,就是 VACUUM 的任务。
一次 UPDATE 的真实动作
先建实验环境:
CREATE TABLE account (id int PRIMARY KEY, balance int); INSERT INTO account VALUES (1, 100);
开两个 psql 会话,会话 A 先做更新但不提交:
-- 会话 A BEGIN; UPDATE account SET balance = 200 WHERE id = 1;
此刻到会话 B 里查询:
-- 会话 B(A 未提交) SELECT balance FROM account WHERE id = 1; -- 结果仍是 100:B 看到的是旧版本
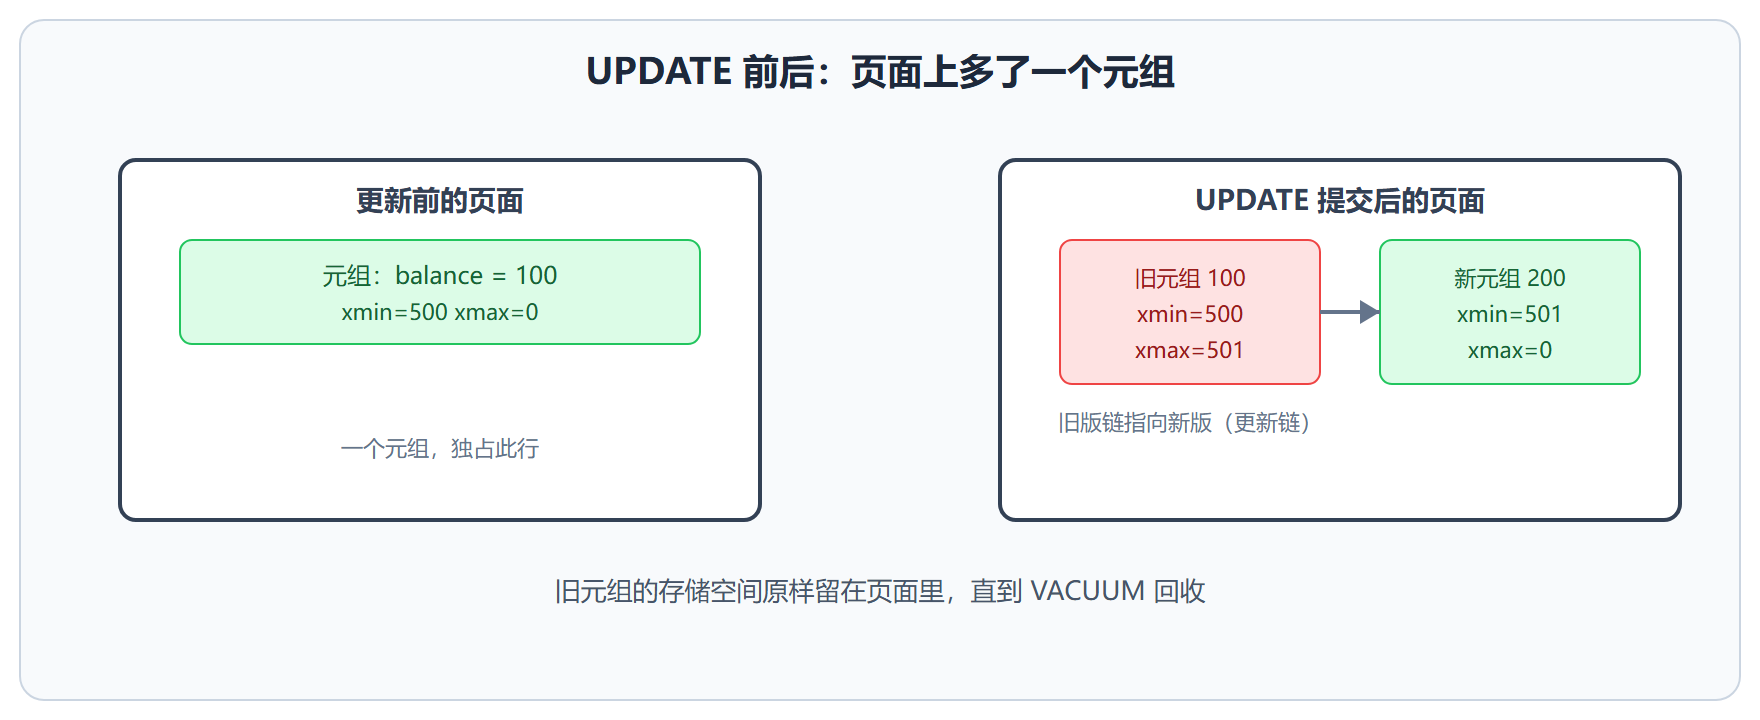
页面上实际躺着两个元组:
- 旧元组:xmin = 插入它的事务,xmax = A 的事务号(被标记死亡,但对未提交事务 xmax 不生效)
- 新元组:xmin = A 的事务号,xmax = 0,同时带着指向旧版本的链(t_ctid 指到新位置)
A 提交后,新事务都能看到 200;但在 A 提交前就开始的旧快照,依旧读 100。没有任何锁参与这场协调——读写互不等待,这就是 MVCC 的红利。
图:一次 UPDATE 前后的页面内容
用 SQL 亲眼看到版本
PostgreSQL 的系统字段可以直接暴露版本信息:
SELECT xmin, xmax, ctid, balance FROM account WHERE id = 1;
再跑一次更新后查看,会看到 xmax 被填上、ctid 指向新位置。配合 pg_stat_user_tables 的 n_dead_tup 计数,就能量化"这张表里躺着多少死版本"。
版本链与 HOT 更新
如果更新的列没有任何索引引用,PostgreSQL 会做 HOT(Heap-Only Tuple)更新:新元组挤在同一页面内,索引不动、仍指向旧位置,靠页内跳转找到新版本。这是降低索引写放大的关键优化:
| 更新方式 | 索引要不要跟着写 | 条件 |
|---|---|---|
| 普通更新 | 每个索引都要插入新条目 | 更新列被索引引用,或页内放不下新版本 |
| HOT 更新 | 索引完全不动 | 更新列未被索引引用且同页有空间 |
推论很实用:不要给频繁更新的列建索引。余额、状态、最后在线时间这类热点列,一旦被索引,每次更新的代价就翻着倍涨。
-- 查看表的 HOT 更新比例 SELECT n_tup_upd, n_tup_hot_upd, round(100.0 * n_tup_hot_upd / nullif(n_tup_upd, 0), 1) AS hot_ratio FROM pg_stat_user_tables WHERE relname = 'account';
⚠️ 常见坑:填因子(fillfactor)设成默认 100 时页内没有预留空间,HOT 更新频繁失败退化为普通更新。写多表配 70 到 90 的 fillfactor,给新版本留落脚点。
完整实验:亲眼看版本链生长
把 2.1 节的实验补完整,用系统字段直接观测版本链的每一步。准备一张带索引列的表,刻意制造两种更新:
CREATE TABLE acct (id int PRIMARY KEY, tag text, balance int); INSERT INTO acct VALUES (1, 'a', 100); -- 第一次:更新未建索引的列 balance(HOT 候选) BEGIN; SELECT txid_current() AS my_xid;
my_xid -------- 1088
UPDATE acct SET balance = 200 WHERE id = 1; COMMIT; SELECT ctid, xmin, xmax, balance FROM acct WHERE id = 1;
ctid | xmin | xmax | balance -------+------+------+--------- (0,2) | 1088 | 0 | 200
注意 ctid 从 (0,1) 变成 (0,2)——新版本在同页内,这正是 HOT 更新的落点。而换成更新被索引引用的 tag 列:
CREATE INDEX ON acct (tag); UPDATE acct SET tag = 'b' WHERE id = 1; SELECT ctid, xmin, xmax FROM acct WHERE id = 1;
用 pageinspect 看页内,此时会同时躺着三个元组:最老的 (0,1) 已死、中间的 (0,2) 也已死(xmax 被填)、最新的版本带 xmin 等于新事务号。tag 索引里也多了一个指向新元组位置的分列——每多一个引用被更新列的索引,就多一次索引写入,这就是"索引数量与更新代价成正比"的物理出处。
版本链的长度谁说了算
版本链不是无限长的。VACUUM 回收死元组后,链条会被"截断重指":索引指向的旧位置若已彻底死亡,清理时会把它改指到链上最新的活版本,中间环节全部抹掉。因此链长由两个速率的相对大小决定——版本产生速率(更新频率)与版本回收速率(清理是否及时)。
一个危险的组合拳:高频更新表遇上被长事务卡住的清理。每秒一百次更新、长事务卡一小时,这一小时内该表每个热点行都会积累三十多万个死版本?不会到那个数——同一行反复更新时新版本会不断复用死元组腾出的空间,链长被页内空间物理限制住——但页内会挤满版本翻滚,HOT 更新因无空间而失败,索引全跟着写,最终呈现为"更新类语句整体劣化、CPU 与 IO 双高"。处置顺序永远是先杀长事务,再谈别的。
概念辨析: xmax 非零不等于已删除
读系统字段时最容易犯的错是把 xmax 非 0 解读为"这行被删了"。xmax 的准确含义是"某个事务曾对它做过删除或更新尝试",这个尝试可能未提交、可能已回滚。回滚后的 xmax 会保留编号但配套的提示位(t_infomask 里的失效标记)会声明它不作数——判定可见性时引擎看的是提示位加提交状态,不是 xmax 是否为零。
这也解释了为什么频繁回滚的业务(比如用异常控制流程的代码)会加速死元组堆积:每次尝试都真实地写入了页面与 WAL,回滚只是打标记,空间要等清理。用下面的会话可以观察到"回滚留下的 xmax 痕迹":
BEGIN; UPDATE acct SET balance = 999 WHERE id = 1; ROLLBACK; SELECT xmin, xmax FROM acct WHERE id = 1; -- xmax 仍显示那个已回滚的事务号,但对该行可见性无影响
生产排查时如果看到大片 xmax 非 0 的行,先别惊慌,用 pg_stat_user_tables 的 n_dead_tup 与 VACUUM 后的变化交叉验证,那才是"真死元组"的账面。
本节要点回顾
- 元组双证:xmin 是出生证明,xmax 是死亡证明,均记事务号
- UPDATE = 删旧插新:旧版本原地保留,服务旧快照
- 读写互不阻塞:靠版本共存实现,不靠锁协商
- HOT 更新省索引:未索引列的更新尽量同页完成,fillfactor 是它的燃料