3.1 WAL 写入路径与 LSN:先写日志再改数据
3.1 WAL 写入路径与 LSN:先写日志再改数据
本节摘要:修改页面之前,PostgreSQL 先把"我要怎么改"的物理描述写进 WAL 日志。每条 WAL 记录有全局唯一的 LSN 字节编号;脏页上记着"诞生时"的 LSN,刷盘前必须保证该 LSN 之前的日志已持久化。事务提交的本质就是把自己的 WAL 刷到磁盘——数据页反而可以慢慢来。
一条 WAL 记录里装了什么
WAL 记录是"变更说明书"而不是数据快照。一次 UPDATE 的记录大致包含:
- 页定位:哪个表、哪个页面、页面里的哪个偏移
- 旧元组字节串与 新元组字节串:重演时直接按位替换
- 事务归属:哪个事务号干的
- LSN 与校验:全局字节位置与完整性
崩溃恢复时,从最近的检查点开始重放这些记录(跳过未提交事务的),数据页就能恢复到崩溃前一瞬。
-- 感受一次更新产生的 WAL 量 SELECT pg_current_wal_lsn(); UPDATE account SET balance = balance + 1; SELECT pg_current_wal_lsn(), pg_wal_lsn_diff(pg_current_wal_lsn(), '0/0')::bigint; -- 两次相减即字节增量
提交为什么是"刷日志"而不是"刷数据"
事务提交时 backend 做的事:把自己的 WAL 缓冲区写入磁盘(经 wal_writer 配合的组提交优化),磁盘确认后,才向客户端返回 COMMIT 成功。改过的数据页此时多半还在缓冲区里当脏页——这不影响正确性,因为日志已经足以重建它们。
性能含义很直接:每次提交至少一次日志落盘。这就是为什么把 wal 放在最快的盘上是生产环境的第一条军规。
| 放置 | 代价 | 适用 |
|---|---|---|
| sync_commit=on(默认) | 每次提交等日志落盘 | 账务、订单 |
| synchronous_commit=off | 提交不等落盘,可能丢最近几百毫秒事务 | 日志、计数器类可容忍场景 |
| commit_delay 组提交 | 微量延迟换批量刷盘 | 高并发小事务 |
图:提交一次事务的落盘顺序
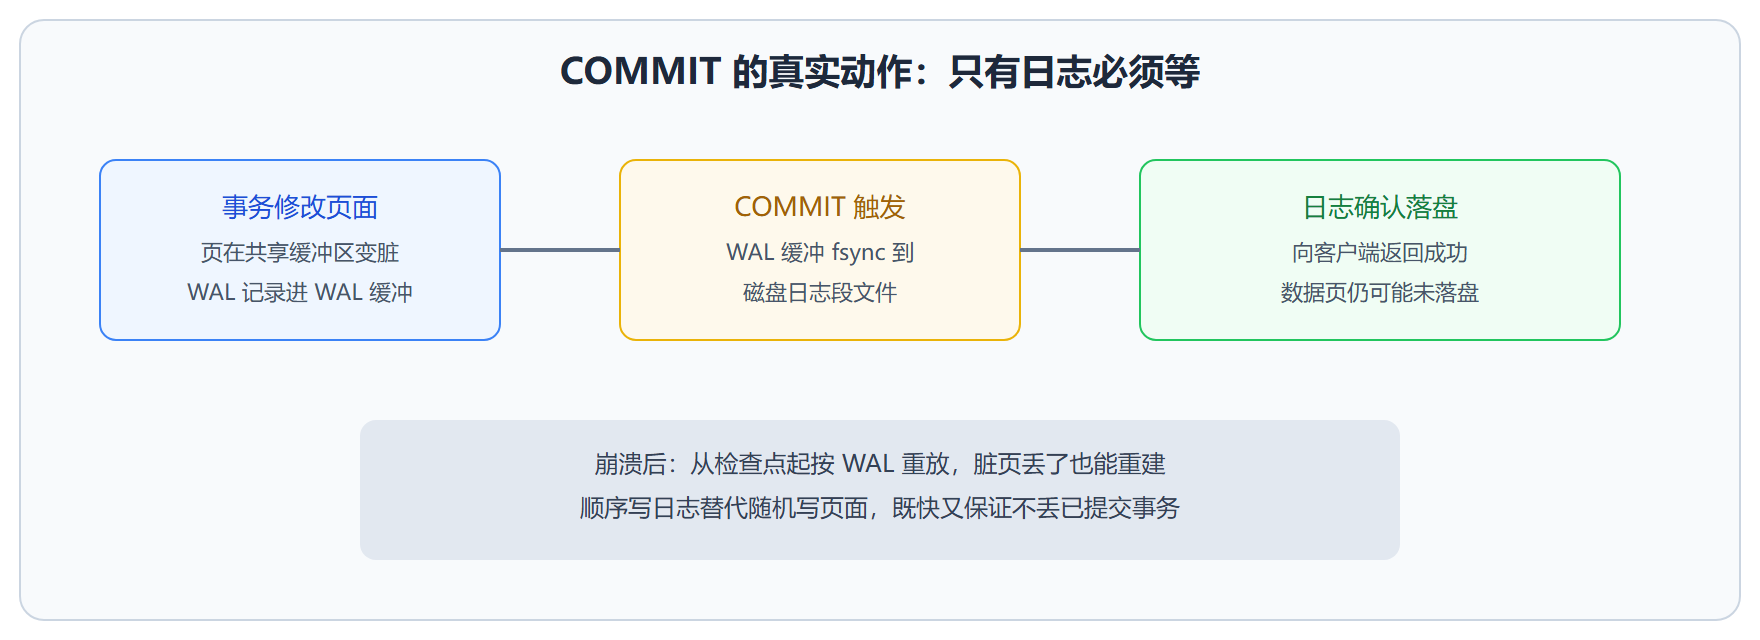
LSN 串起的一条铁律
每个脏页头部记着产生它的 WAL 记录 LSN。任何进程想把脏页刷盘,必须先检查磁盘日志是否已推进到该 LSN——没有就先把日志刷下去。这条"页不先于日志"的检查,是 WAL 正确性的全部根基,也是 3.2 节检查点工作的前提。
-- 监控 WAL 生成速度,估算磁盘需求 SELECT pg_size_pretty(pg_wal_lsn_diff(pg_current_wal_lsn(), '0/0'));
💡 关键直觉:把 WAL 想成会计流水账,数据页是随时可以按账重算的草稿。只要流水账在,草稿烧了都无所谓——这就是日志先行体系的底气。
LSN 实验与读法
LSN 形如"0/4A2B180"——高位是日志段编号、低位是段内字节偏移。亲手度量一条语句的日志产量:
SELECT pg_current_wal_lsn() AS before_lsn;
before_lsn ------------ 0/4A2B180
UPDATE customer SET balance = balance + 1 WHERE id <= 100; SELECT pg_current_wal_lsn() AS after_lsn, pg_wal_lsn_diff(pg_current_wal_lsn(), '0/4A2B180') AS bytes;
after_lsn | bytes ------------+------- 0/4A38F20 | 55840
一百行更新产生了约 55KB 日志——平均每行五百多字节,远大于行本身,因为 WAL 记录里还有页定位、事务头、备份块等开销,且这批更新可能触发全页写(3.2 节的整页镜像)。把这类度量跑在真实业务库上,就能把"日增日志量"从感觉变成数字,为 max_wal_size 与归档容量规划提供依据。
日志段文件本身也可以观察到:目录下的段文件默认 16MB 一段,写满即切换。切换频率是写负载的另一个温度计:
SELECT archived_count, stats_reset, pg_size_pretty(pg_wal_lsn_diff(pg_current_wal_lsn(), '0/0')) AS total_wal FROM pg_stat_archiver;
组提交:一次落盘服务一群事务
"每次提交至少一次日志落盘"听起来是硬性乘法,但高并发下有合并空间:多个事务几乎同时到达提交点时,第一个刷盘的进程可以捎带把同行者缓冲区里的日志一起写下去,后来者等第一轮落盘确认即可返回——一次 fsync 的成本被摊到多个事务头上,这就是组提交。
两个参数控制它的形态。commit_delay 是"稍等一下再刷"的微延迟(默认关),愿意让首批提交者多等几微秒换取捎带更多同行者;commit_siblings 是触发条件——只有同时活跃的提交足够多才值得等。吞吐敏感的小事务集群(订单、计费)值得一试,但收益要用压测验证,它属于"调了可能白调、不调不亏"的第二梯队参数,排在把日志盘换快之后。
排错案例:提交延迟尖刺
一套订单库每天固定几个时刻 COMMIT 延迟从两毫秒跳到两百毫秒。分层排查的路径:先确认日志盘本身(同时间段磁盘监控的 fsync 耗时是否同步抬高——是,则嫌疑在存储层,检查是否与其他 IO 大户共用磁盘);再看检查点(尖刺时刻是否与日志里的检查点记录吻合——3.2 节的全页写与刷页高峰会挤压日志写入带宽);最后看同步备库(主库提交等待备库确认的机制是否启用,备库网络或负载抖动会直接表现为主库提交慢)。
本案的真凶是第三种:同步复制的备库在夜间批量任务时段 replay 延迟升高,主库每个提交都要等它。处置是业务侧把同步级别从"任意同步备库落盘"降为应用级确认的混合模式,尖刺即除。回看这个案例,提交延迟从来不只是 WAL 写入快慢的问题——它是"本地日志、检查点节奏、备库确认"三条链路的最大值。
本节要点回顾
- WAL 是变更说明书:按页定位加前后字节串,恢复时按位重放
- 提交即刷日志:客户端拿到成功时,日志已落盘,页面未必
- LSN 铁律:刷脏页前,磁盘日志必须追上页面的 LSN
- 吞吐调优第一刀:日志盘速度与 synchronous_commit 策略