3.2 检查点与全页写:脏页如何安全落盘
3.2 检查点与全页写:脏页如何安全落盘
本节摘要:检查点是"此刻起,崩溃恢复从新起点开始"的边界:把所有脏页刷盘、在日志里写一条检查点记录。两次检查点之间的日志量决定崩溃后的恢复时长。全页写则解决另一个隐患:磁盘一次写不完整页时,重放会"二次伤害",办法是检查点后某页的首次修改把整页镜像进日志。
检查点做了什么
checkpointer 进程定期(默认最多五分钟,或 WAL 增量超过阈值时)执行:
- 把共享缓冲区里所有脏页按 LSN 铁律刷盘
- 在 WAL 里写入一条 CHECKPOINT 记录并持久化
- 更新控制文件里的重放起点
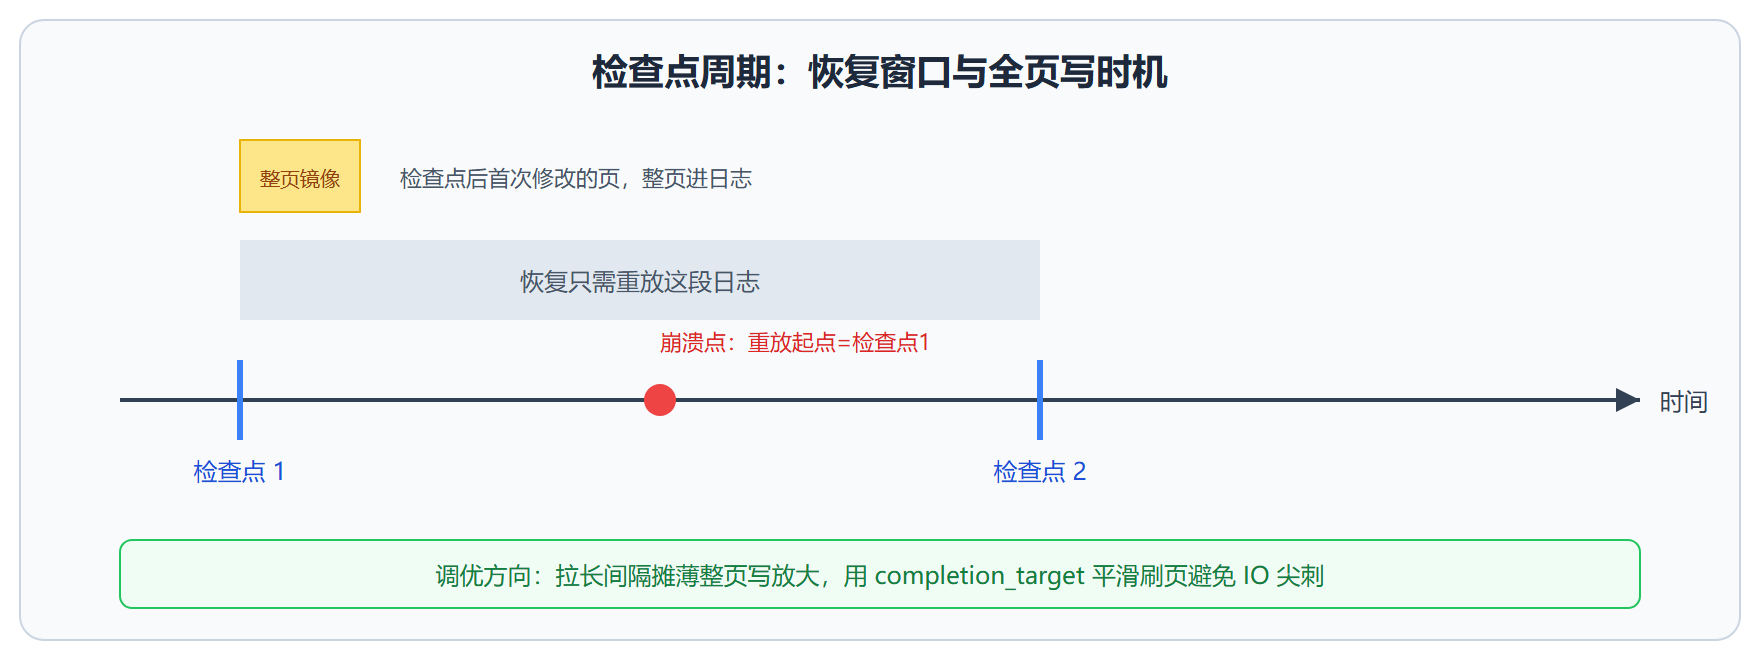
效果:崩溃恢复从这条记录开始重放即可,之前的日志不再需要(除非留着做 PITR)。检查点越频繁,单次崩溃恢复越快,但检查点本身要刷的页也越集中——这就是著名的"检查点抖动"问题。
checkpoint_timeout 默认 5 分钟 max_wal_size 默认 1GB —— 增量超限也会提前触发检查点
I/O 平滑靠 checkpoint_completion_target:把刷页摊到整个间隔的后半段完成,而不是一次性打满磁盘。生产库常见的保守调法是 timeout 拉长到 15 到 30 分钟、max_wal_size 按日志日增量放大,再让 completion target 保持 0.9。
全页写:为"写到一半"买保险
磁盘的原子性单位通常是扇区(512B 或 4KB),而页面是 8KB。断电时一个页面可能只写进去一半——旧数据被覆盖一半、新数据只有一半,页面既不是旧也不是新。
WAL 重放对此无能为力:日志记录里只有"从旧字节改成新字节"的差量,旧字节本身已经损坏,重放等于在错误地基上施工。PostgreSQL 的解法简单粗暴:
检查点之后,某页面第一次被修改时,把整个页面完整镜像写进 WAL。
这样即便磁盘上的页烂了,也能用日志里的整页副本重建。代价是检查点后首批写入的日志显著膨胀——修改越集中在检查点刚结束时,放大越明显。
图:检查点周期与全页写时机
观察检查点行为
-- 需要超级用户;日志里也记录每次检查点的统计 SELECT * FROM pg_stat_bgwriter;
checkpoints_timed | 1180 ← 到点触发的(健康) checkpoints_req | 47 ← 被迫提前触发的(偏多=max_wal_size 太小) buffers_backend_fsync | 0 ← 后端被迫自己刷页(应接近 0)
checkpoints_req 占比高,说明 WAL 消耗速度超过了 max_wal_size 的预算,检查点被频繁提前,抖动加剧——优先放大 max_wal_size,而不是缩短 timeout。
⚠️ 常见坑:把 checkpoint_timeout 调得很短来"缩短恢复时间",结果整页写放大与刷页尖刺反而拖垮写入吞吐。恢复窗口交给 max_wal_size 与备用库去做,别用缩短间隔硬扛。
检查点日志的完整解剖
每次检查点都会在数据库日志里留下一条完整记录,读懂它等于看到这台机器的心电图:
CHECKPOINT: write 1284 buffers (0.8%); 0 WAL file(s) added, 0 removed, 2 recycled; write=11.2 s, sync=0.3 s, total=11.6 s; sync files=9, longest=0.2 s, average=0.03 s; distance=1985 kB, estimate=1985 kB
逐段拆解:write 是刷脏页的耗时、sync 是调用落盘的耗时,两者分开统计是因为它们吃不同的资源(写内存拷贝与磁盘队列);distance 是两次检查点之间产生的日志量,它直接决定崩溃恢复的重放时长——恢复时间约等于"日志量除以重放速度";estimate 是规划器对下次 distance 的预估,检查点会按它提前安排节奏。distance 常年高于 max_wal_size 的设定,就是 checkpoints_req 偏高的日志版证据。
想要更密的观测,把 log_checkpoints 保持开启(新版本默认开)即可,它是免费的体检报告,没有理由关。
实验:人为制造一次检查点风暴
在实验库上可以安全地复现"检查点抖动":
-- 把预算压到极小,强制频繁触发 ALTER SYSTEM SET max_wal_size = '128MB'; SELECT pg_reload_conf(); -- 持续批量写入,观察日志 INSERT INTO customer (name, balance) SELECT 'burst_' || g, 1 FROM generate_series(1, 200000) g;
日志里会看到 checkpoints_req 快速上涨、每条 CHECKPOINT 的 write 耗时变长但 distance 变短——单位时间要刷的页总量没变,只是被切成了密集的小尖刺。把 max_wal_size 恢复到 1GB 再跑,req 回落、timed 占比恢复。这个五分钟实验建立的手感比背参数表牢固得多:max_wal_size 是用磁盘空间换写入平稳性的旋钮。
全页写的边界与传闻
关于 full_page_writes 有两个常见误解值得澄清。其一是"SSD 时代可以关掉它省日志"。SSD 解决的是随机写性能,没有解决断电时"8KB 写到一半"的原子性问题——存储设备对断电时单位的保证各不相同,关掉它等于把数据完整性押在硬件承诺上,没有哪个严肃生产环境值得冒这个险。其二是"它让日志量翻倍"。放大只发生在检查点后每个页的首次修改,之后对该页的修改恢复为差量记录;放大比例取决于"检查点后多久会把老页改一遍",写入越均匀放大越温和。
另一个相关参数是 wal_compression:把整页镜像压缩后再记日志,能在放大明显的场景省下可观空间,代价是 CPU。日志体积吃紧的库可以开起来对比 distance 变化,属于收益可度量的低风险开关。
本节要点回顾
- 检查点三件事:刷全部脏页、写检查点记录、推进恢复起点
- 恢复窗口=两次检查点间的日志量:由 timeout 与 max_wal_size 双闸控制
- completion_target 抹平尖刺:把刷页摊开而不是一次打满
- 全页写防半页:检查点后首改整页进日志,代价是短时日志放大