3.3 PITR 时间点恢复内幕
3.3 PITR 时间点恢复内幕
本节摘要:把一次物理基础备份加上持续归档的 WAL 日志段,就能把数据库恢复到过去的任意时间点(PITR)。原理与崩溃恢复相同——按日志重放——只是重放的终点由你指定。误删表、错误 UPDATE 全表这类事故,PITR 是最后的后悔药。
三个部件:基础备份、归档日志、恢复目标
PITR 的材料清单:
- 基础备份:某个时刻的数据文件全量快照(pg_basebackup 制作,备份期间允许写入)
- 归档 WAL:基础备份之后产生的所有日志段,持续归档到安全位置
- 恢复目标:恢复到哪个时间点或事务号
为什么备份期间可以正常写入?因为 WAL 会把备份开始后的所有变更记下来,恢复时先把备份文件就位,再从备份起点重放日志到目标时刻——中途的变更一并补齐。
-- 主库配置归档(示意参数) -- archive_mode = on -- archive_command = '把日志段拷到归档存储的命令' -- 制作基础备份(专用复制账号) SELECT pg_backup_start('base_backup'); -- 拷贝数据目录 SELECT pg_backup_stop();
恢复到误删前一秒
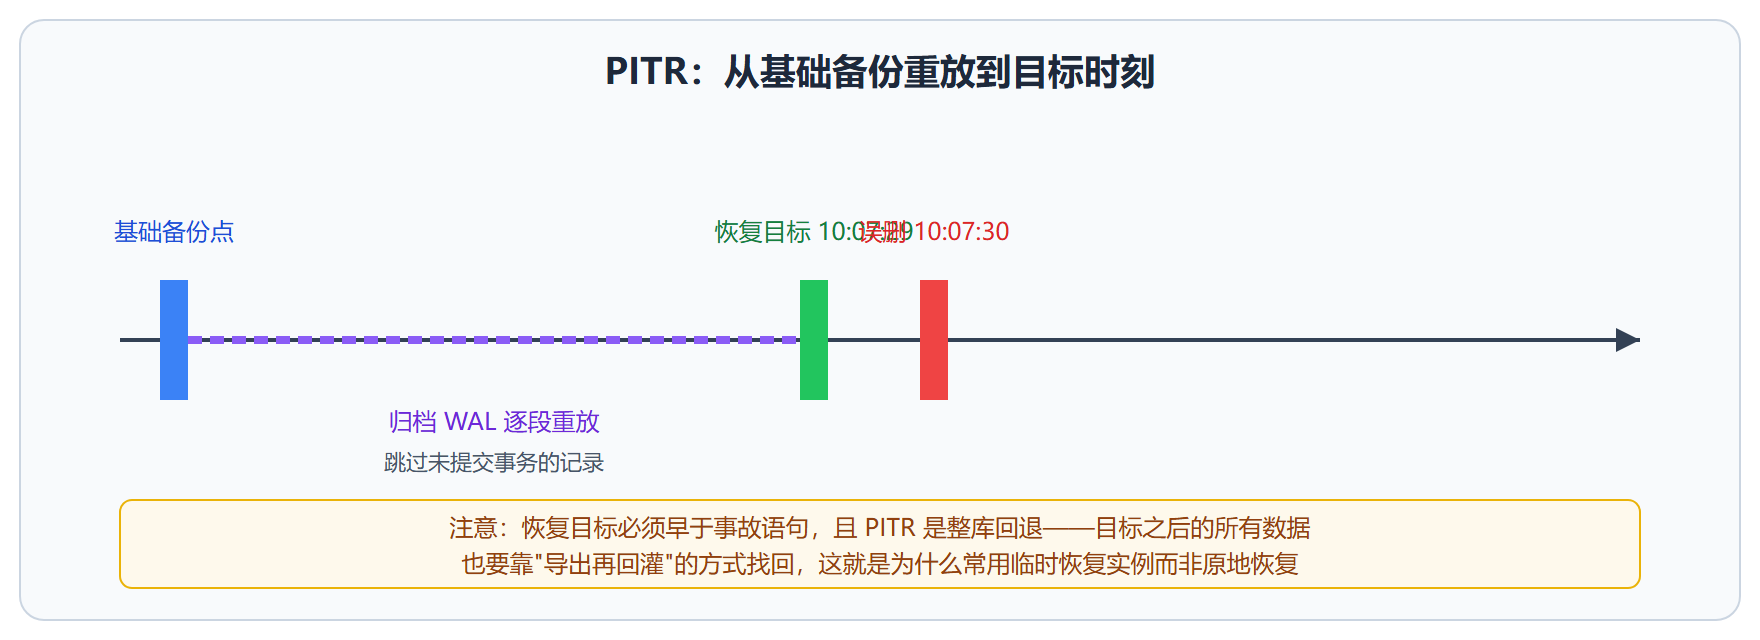
事故现场:上午 10 点 7 分 30 秒,有人执行了 DROP TABLE orders。恢复流程:
1. 停库,把当前数据目录移开保存现场 2. 展开基础备份到数据目录 3. 在数据目录放恢复配置: restore_command 从归档取日志段 recovery_target_time = '2026-08-21 10:07:29' 4. 启动库:进入恢复模式,逐段重放 WAL 5. 到达目标时间自动暂停(recovery_target_action = pause) 6. 确认无误后,导出误删表的数据,再恢复正常运行
图:PITR 重放时间线
工程实践:别在原地恢复
PITR 是整库时间机器:回到 10:07:29,意味着 10:07:29 之后的所有合法业务数据也没了。生产上的标准动作是"旁路恢复":用备份与归档在另一台机器上恢复出一个临时实例,只导出误删的表数据,再灌回主库——主库的正常数据一次都不用回退。
⚠️ 常见坑:归档 command 只是"拷走文件",若目标盘满了它开始失败,而主库会反复重试并打爆日志。归档链路必须有容量监控与失败告警,否则 PITR 会在你最需要它的那天断档。
pg_basebackup 实操与验证
pg_basebackup 把"起备份、拷文件、停备份"三步打包成一条命令,并支持在备份完成后立刻验证:
# 用复制协议做一次基础备份,-X stream 连备份期间的日志一并流走 pg_basebackup -h 127.0.0.1 -U repl -D /backup/base -Fp -Xs -P # -P 会打印进度;结束后目录里多出 backup_label, # 它记录备份起点的日志位置——恢复时从它开始重放
# 快速验证备份可用:展开后直接以单用户模式起一下 ls /backup/base/backup_label
backup_label 是整套机制的钥匙:恢复进程读它拿到"备份时刻的重放起点",配合归档日志逐段补齐。没有归档的裸备份只是"备份开始那一刻的表",加上归档才是"从此刻到任意后续时刻"。这也给出备份策略的验收标准——没做过一次完整恢复演练的备份计划,等于没有备份计划。演练要点:在隔离机器展开、配置 restore_command、指定恢复目标、起库、抽查关键表行数。
恢复目标的四种姿势
| 目标方式 | 写法 | 适用 |
|---|---|---|
| 时间点 | recovery_target_time | 知道事故发生时刻,最常用 |
| 事务号 | recovery_target_xid | 精确到某个具体事务,如"这个事务之前" |
| 命名还原点 | recovery_target_name | 变更前手动 pg_create_restore_point 打的锚 |
| 日志位置 | recovery_target_lsn | 与流复制工具配合的精确停点 |
时间点最直觉但有秒级模糊(同一秒内多个提交的先后要靠日志序解决);命名还原点最稳,重大变更(大批量 UPDATE、结构迁移)前打一个锚,出事直接指名恢复,完全免除"猜时刻"的心智负担。养成这个习惯的成本是一行 SQL:
SELECT pg_create_restore_point('before_big_migration');
排错案例:归档断档的三天
一套库周三误删表,翻归档目录准备 PITR,发现日志段只到周日——归档命令的目标存储周日晚间配额满,归档开始失败,而失败只写在数据库日志里,无人告警。主库侧的表现是 WAL 目录持续膨胀(未归档的段不能删),万幸磁盘告警先响,否则主库会因日志盘满而停止接受写入。
事后补的三道闸:归档目标存储的容量与增长监控;pg_stat_archiver 视图的 failed_count 接入告警(任何一次归档失败都该有人知道);每周自动恢复演练——随机挑一个备份与归档点做恢复到目标时间的冒烟测试。三道闸的成本加起来不到半天,换来的是"PITR 在你需要的那天一定可用"这个承诺。
恢复过程中的两个易踩细节
恢复配置里有两个细节最容易让演练翻车。一是 recovery_target_action 的取值:pause(默认)会停在目标点等你确认,promote 直接转成可写主库,shutdown 停机返回。演练与救援场景应当用 pause——停下来先核对数据,再决定 promote 或继续倒带;直接 promote 意味着从此不能再往回退,这个决定不可逆。二是 recovery_target_inclusive:设为 true 表示"包含目标时刻的那个事务",false 表示停在它之前。误删发生在 10:07:30,恢复目标填 10:07:29 且 inclusive 为 true 时,10:07:29 这一秒内提交的事务会被保留——多数场景正确,但精确事务边界的救援要意识到这层含义。
另一个常被忽略的事实:恢复是"重放到目标点即停",但重放本身也要消耗与写入时同量级的 IO。基础备份越旧、目标点越晚,恢复耗时越长——这直接翻译成备份策略语言:基础备份频率决定了恢复的最坏时长。日增百 GB 日志的库,只留每周一次的基础备份,意味着最坏要重放七天的日志;每两天一次,最坏减半。恢复时间目标(RTO)倒推备份频率,是容量规划里最常被跳过的一步。
本节要点回顾
- 三部件:基础备份、归档 WAL、恢复目标,重放原理与崩溃恢复同源
- 备份期间可写:WAL 保证备份起点之后的变更可补
- 整库回退:PITR 倒带的是全世界,单表救援要靠旁路实例导出
- 归档链路要监控:断档的归档等于没有 PITR