1.3 数据类型与向量:给证据分类编目
1.3 数据类型与向量:给证据分类编目
本节摘要:向量是 R 最小的证据单元,数据类型是证据的编目规则。本节讲清数值、字符、逻辑、因子四种类型与向量、列表、矩阵、数据框四种容器的对应关系,并回答一个问题:鸢尾花的物种名为什么必须是因子。
从一个翻车现场说起
新手最常见的事故长这样:
x <- c(5.1, 4.9, "4.7") # 想放三个测量值 x + 1 # 报错:non-numeric argument
原因:向量内部只能装同一种类型。混进一个带引号的字符,整条向量被"降级"成字符型,算术运算当场失效。这不是 bug,是 R 的编目铁律——证据要么全是数值,要么全是文字,混装必翻车。
class(c(5.1, 4.9)) # numeric class(c(5.1, "4.7")) # character —— 整条被拖下水
四类证据、四种容器
| 类型 | 例子 | 勘验含义 |
|---|---|---|
| numeric | 5.1、4.9 | 测量值,可算 |
| character | "setosa" | 自由文本描述 |
| logical | TRUE / FALSE | 是非判断,筛选证据用 |
| factor | 三水平的 Species | 在册类别,统计建模的正式身份 |
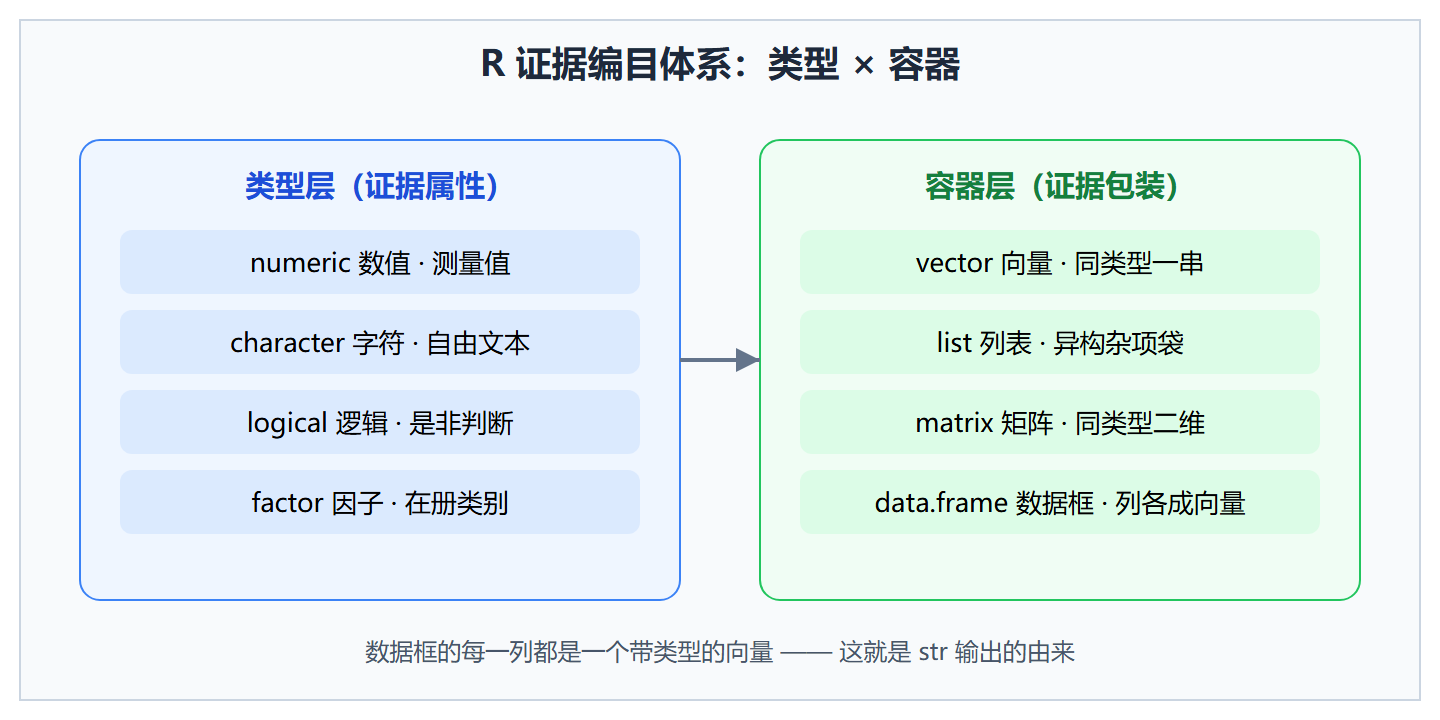
向量之上还有三件容器:列表(list)什么类型都能装,像杂项证物袋;矩阵(matrix)二维但全表同类型,像整页都是数字的测量表;数据框(data.frame)每列各自一个类型,列是向量——这正是现实案卷的形状:既有测量值又有物种名。
# 一个微型案卷:三列三种类型,拼成一个数据框 mini <- data.frame( 株号 = 1:3, 花瓣长 = c(1.4, 4.7, 5.0), 物种 = factor(c("setosa", "versicolor", "virginica")) ) str(mini)
物种名为什么要编成因子
s <- iris$Species class(s) # factor levels(s) # 三个在册水平 as.numeric(s)[1:3] # 底层是 1 1 1 —— setosa 存的是编号
因子在底层存的是整数编号加一张"水平表"。这样设计有两条实际好处:绘图时图例顺序稳定可控;建模时分类变量能被 lm、glm 直接识别成哑变量组。如果物种只是字符,很多统计函数要么报错要么结果不对。
证据编目关系图
向量的基本手法
v <- c(5.1, 4.9, 4.7, 4.6, 5.0) v[1] # 取第 1 条证据(R 从 1 数起) v[c(1, 3)] # 取第 1、3 条 v[v > 4.8] # 条件筛选:只留大于 4.8 的 v * 2 # 向量化运算:整条同算,不用写循环
向量化是 R 的母语:能对整条向量一次操作的,就不要写 for 循环逐个处理。这一点在第 3 章讲编程基础时还会展开。
⚠️ 常见坑:R 的下标从 1 开始,不是 0。从 Python 转过来的侦探尤其要留神,
v[0]不会报错,只会悄悄返回一个空向量——这种"无声错误"比报错更危险。
完整演练:一次类型事故的全程复盘
把类型知识串起来用一遍。案情:实习生把一批花瓣宽度从 Excel 抄进 R,画直方图时报错。复现并修好它:
# 第一步:复现事故 w <- c("0.2", "0.3", "0.5", "0.2", "0.4") hist(w) # 报错:x must be numeric —— 抄录时全带上了引号 # 第二步:验明正身,再转型 class(w) # character w_num <- as.numeric(w) class(w_num) # numeric mean(w_num) # 0.32,恢复正常运算 # 第三步:转型前必须排查无法转的取值 bad <- c("0.2", "0.3", "缺", "0.4") as.numeric(bad) # 警告:NAs introduced by coercion # 输出:0.2 0.3 NA 0.4 —— "缺"被转成 NA,务必数清丢了多少 sum(is.na(as.numeric(bad))) # 1
复盘要点:类型转换永远不是"转完就完",as.numeric 遇到转不动的取值会静默塞 NA,只给一条警告。养成"转换后立刻数 NA"的习惯,能挡住一大批数据丢失事故。
类型判断与转换速查
| 判断函数 | 转换函数 | 一个典型陷阱 |
|---|---|---|
| is.numeric | as.numeric | 字符里混中文,转换变 NA |
| is.character | as.character | 数字被强转文字后再算术就报错 |
| is.logical | as.logical | "TRUE"/"FALSE" 可转,"对/错" 不行 |
| is.factor | as.factor | 水平顺序默认按字典序,绘图前先排好 |
| is.na | —— | NA 会传染:NA + 1 还是 NA |
NA 的传染性值得单独记一笔:任何含 NA 的向量做 mean、sum 都会返回 NA,必须加 na.rm = TRUE 才能跳过缺失继续算——这个参数在第 2 章清洗时会天天用。
因子的进阶操作:排序、重编码、事故现场
# 水平顺序重排:让 setosa 打头(默认按字典序碰巧也是它) s <- factor(iris$Species, levels = c("setosa", "versicolor", "virginica")) levels(s) # 重编码:把三水平并成两水平(原产地 vs 其余) s2 <- iris$Species levels(s2) <- list(setosa = "setosa", other = c("versicolor", "virginica")) table(s2) # setosa other # 50 100 # 事故现场:忘了 drop,图例里挂着没数据的空水平 s3 <- iris$Species[iris$Species == "setosa"] table(s3) # 只剩 50 个 setosa levels(s3) # 但水平表仍是 3 个 droplevels(s3) |> table() # 正式清掉空水平
最后一段是绘图时的高频事故:筛完子集直接画图,图例里出现一个零计数水平。droplevels 是子集化后的标准收尾动作。
💡 概念辨析:字符串做"标签",因子做"分类"。标签只要求写对,分类还要求在册、可排序、可计数。当一列文字要进模型、要控图例顺序、要做频数检验时,就该是因子。
本节要点回顾
- 向量同类型铁律:混装字符会把整条向量拖成 character
- 数据框 = 若干带类型向量的拼合:str 的输出就是逐列报类型
- 因子是在册类别:底层整数编号 + 水平表,建模与绘图的正式身份
- 下标从 1 起:
v[0]静默返回空值,小心无声翻车 - 向量化优先:整条同算是 R 的惯用手法