2.3 动词链侦查:dplyr数据整理五连招
2.3 动词链侦查:dplyr 数据整理五连招
本节摘要:dplyr 把数据整理归纳为少数几个动词:filter 筛行、select 取列、mutate 派生、arrange 排序、group_by 加 summarize 分组汇总。本节用管道操作符把它们串成一条侦查流水线,回答乘客名单案的核心问题:谁更容易生还。
侦查流水线的思想
传统写法是一层套一层的函数嵌套,括号写到第三层就没法读。dplyr 的答案是管道:x %>% f() 读作"把 x 交给 f"。数据从左往右流动,每一步只做一件事,整条链就是一份可朗读的审讯记录。
五个动词各司其职:
library(dplyr) passengers %>% filter(Sex == "female") %>% # 筛行:只看女性乘客 select(Pclass, Age, Survived) %>% # 取列:只留三列证据 mutate(died = 1 - Survived) %>% # 派生:加一列死亡标记 arrange(desc(Age)) %>% # 排序:年长者在前 head(5) # 抽看前五条
结案统计:生还率排查
名单案的核心问题,用 group_by 加 summarize 两招就能给出答案:
passengers %>% group_by(Sex, Pclass) %>% summarize( n = n(), survival_rate = mean(Survived), .groups = "drop" )
典型结果一目了然:头等舱女性生还率超过九成,三等舱男性不到两成——舱位与性别构成生还的两大主因素。再加一招派生,把连续年龄切成波段,还能看到"儿童优先"的痕迹:
passengers %>% mutate(age_band = cut(Age, breaks = c(0, 12, 18, 60, Inf), labels = c("儿童", "青少年", "成人", "老年"))) %>% group_by(age_band) %>% summarize(survival_rate = mean(Survived), .groups = "drop")
一次结案统计的证据流
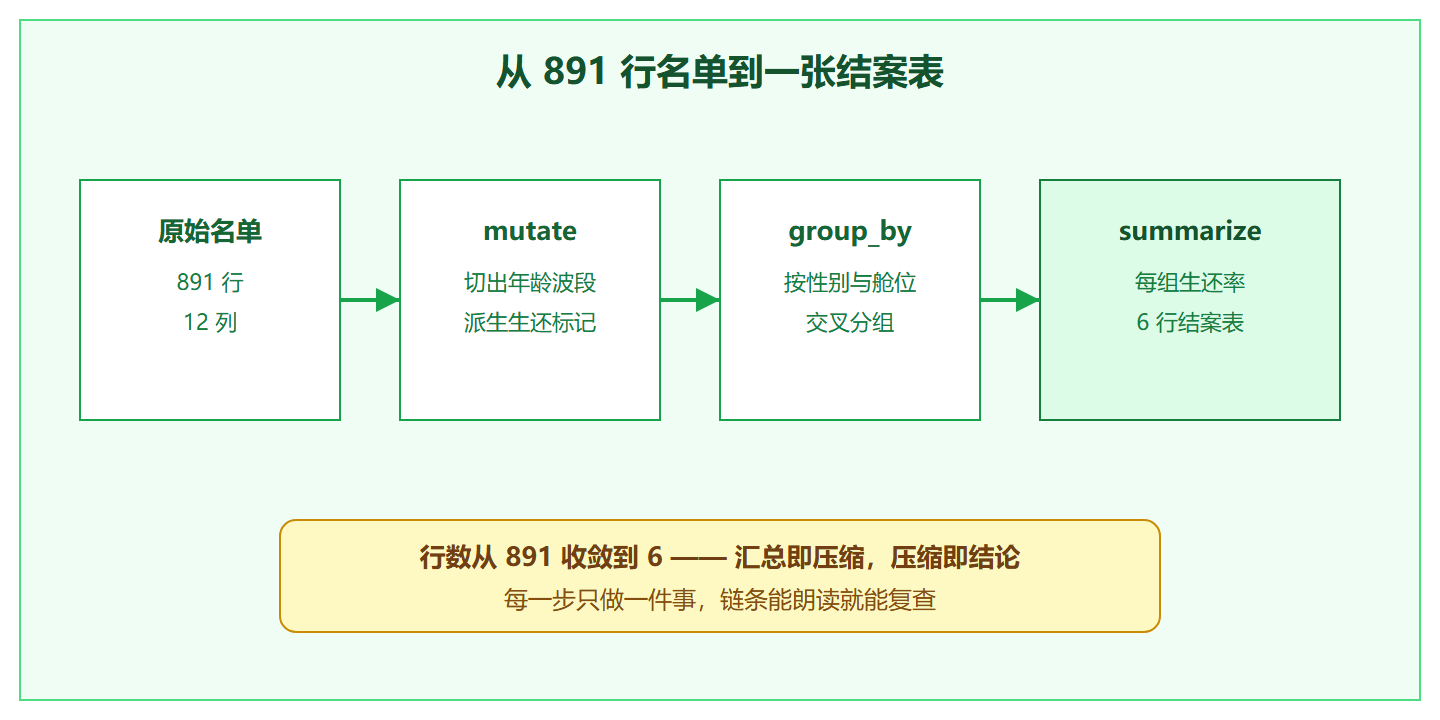
侦查流水线结构
基础包与 dplyr 对照
| 任务 | 基础包写法 | dplyr 写法 |
|---|---|---|
| 筛行 | subset 或中括号条件 | filter |
| 取列 | df 的列名向量 | select |
| 派生 | 直接赋新列 | mutate |
| 分组汇总 | tapply 或 aggregate | group_by 加 summarize |
| 排序 | order 拼中括号 | arrange |
两套都合法。我的建议:新项目一律 dplyr——链式结构在多人协作和复查时优势太明显;读老代码时要认得 subset、tapply,不必重写。
💡 关键直觉:summarize 之后默认还带着分组结构,
.groups = "drop"把它放掉,避免后续操作"每组各来一份"的隐性意外。链尾随手加这一参数,是老手的肌肉记忆。
进阶演练:一题多解与性能对比
同一个问题——各舱位的生还人数、死亡人数与生还率——用三种写法各解一遍,体会 dplyr 的表达力:
# 写法一:summarize 多指标一次出 passengers %>% group_by(Pclass) %>% summarize(生还 = sum(Survived), 死亡 = sum(1 - Survived), 生还率 = mean(Survived), .groups = "drop") # 写法二:count 加比例(更适合快速清点) passengers %>% count(Pclass, Survived) %>% group_by(Pclass) %>% mutate(占比 = n / sum(n)) %>% ungroup() # 写法三:across 批量汇总——对多个数值列一次算均值 passengers %>% group_by(Pclass) %>% summarise(across(c(Age, Fare), \(x) mean(x, na.rm = TRUE)), .groups = "drop")
三段输出各有用途:写法一进报告,写法二做核对,写法三在列多时省力气。\() 是 R 4.1 起的匿名函数简写,读作"定义一个临时的 x 到……"。
条件派生与合成证据
真实排查常需要"多条证据合成一条判断"。case_when 是 dplyr 的分案工具:
passengers <- passengers %>% mutate(优先群体 = case_when( Sex == "female" ~ "妇女", Age < 12 ~ "儿童", Sex == "male" & Pclass == 1 ~ "头等男性", TRUE ~ "其余男性" )) passengers %>% group_by(优先群体) %>% summarize(人数 = n(), 生还率 = mean(Survived), .groups = "drop") %>% arrange(desc(生还率))
典型输出把名单案的结论排成一行判决:妇女最高、儿童次之、头等男性居中、其余男性垫底。case_when 从上往下匹配、TRUE 兜底,相当于一张查表——比层层嵌套的 ifelse 可读得多。
⚠️ 排错实录一:filter 里写单个与符号
Sex == "female" & Pclass == 1合法,但漏写引号成Sex == female会报错 object not found——R 把 female 当变量名去找。字符串比较必须带引号。⚠️ 排错实录二:summarize 里用了 n() 却忘了 group_by,得到整表一行、n 等于总人数——逻辑没错但结论错位。链尾核对行数是廉价的自检。
概念辨析:管道三兄弟
| 操作符 | 读法 | 出现版本 | 备注 |
|---|---|---|---|
| %>% | 交给 | magrittr 引入,dplyr 带出 | 老代码主力,本册通用 |
| > | 交给 | R 4.1 原生 | |
| %<>% | 交回并覆盖 | magrittr | 等价 x 重新赋值,少打一次左值 |
三者可以混用但同一段脚本里保持统一。原生管道在匿名函数占位上尚有局限,涉及 .x 占位的旧代码继续用 %>% 最稳。
本节要点回顾
- 管道是可朗读的笔录:数据从左向右流,一步一动作
- 五连招分工:筛行、取列、派生、排序、分组汇总
- group_by 配 summarize:分类排查的标准组合
- cut 切波段:把连续证据离散化,暴露非线性规律
- .groups 参数:汇总后放掉分组结构,防隐性分组