2.1 拿到名单:数据导入与初步检视
2.1 拿到名单:数据导入与初步检视
本节摘要:外部数据进 R 的标准通道是 read.csv 家族与 readr 包的 read_csv。本节完成乘客名单的导入,处理编码、表头、分隔符等常见导入事故,并用一套固定检视动作列出"问题清单",为清洗立项。
案卷进门的三种通道
R 读数据有两套主流工具:基础包的 read.csv(返回 data.frame)和 readr 包的 read_csv(返回 tibble,打印更友好、速度更快)。以乘客名单为例:
# 基础包通道 passengers <- read.csv("titanic.csv", stringsAsFactors = TRUE) # readr 通道:先装包再借工具 install.packages("readr") library(readr) passengers <- read_csv("titanic.csv")
两套通道的差别值得记一笔:read_csv 不把字符串自动转因子、不改变量名、显示行列规模更清楚。教学与 exploratory 分析我更倾向 readr;但如果下游老代码依赖因子列,基础包通道反而省事——工具选择永远跟着案情走。
导入事故档案
| 症状 | 病因 | 处置 |
|---|---|---|
| 中文列名变乱码 | 文件是 GBK 编码 | 指定 encoding 参数 |
| 首行数据变列名 | 文件没有表头 | 设 header 为 FALSE |
| 整表挤成一列 | 分隔符不是逗号 | 换 read_delim 并指定分隔符 |
| 数字列混入字符 | 千分位逗号或空格 | 导入后清洗,见下一节 |
数据进门的三条通道
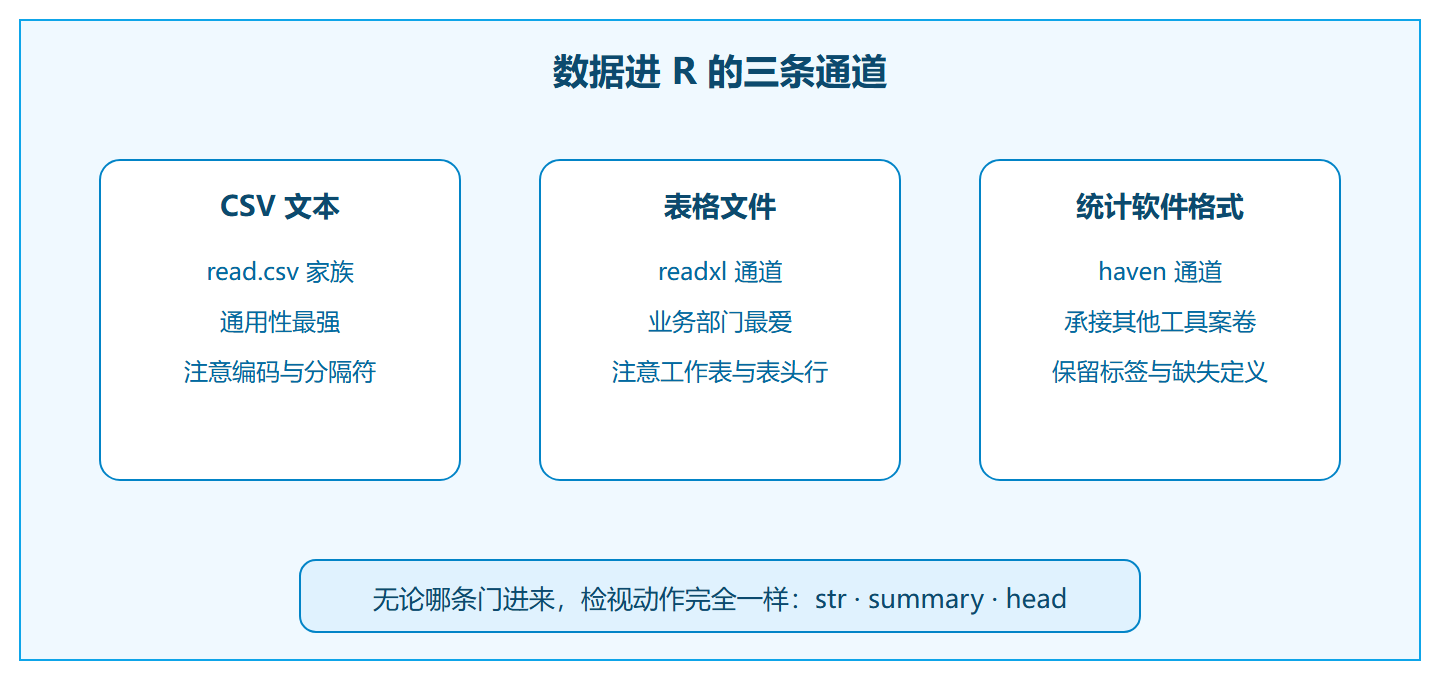
检视动作:列出问题清单
导入只是把案卷搬进门,真正的立案动作是检视。对着乘客名单,标准流程如下:
dim(passengers) # 规模:多少行多少列 str(passengers) # 每列类型——数字列若显示 chr 就有问题 summary(passengers) # 数值列分布 + 因子列计数 head(passengers, 3) # 抽看开头几行 # 缺失清点:每一列各缺多少 colSums(is.na(passengers))
colSums(is.na(...)) 这条组合拳值得背下来:is.na 把整表变成 TRUE/FALSE 矩阵,colSums 按列求和——TRUE 按 1 计,得到的正是每列缺失数。乘客名单跑出来的典型结果是年龄列缺约 177 条、舱位列缺 2 条,这就是下一节的"缺口清单"。
导入到立项的流程
💡 关键直觉:检视时先看"类型对不对",再看"分布正不正"。类型错了(比如票价被读成字符),后面一切统计都是空谈;这类问题必须在立案阶段就地纠正。
复盘演练:一张问题清单的诞生
把检视动作连成一次完整立案。假设 passengers 已导入,下面这段脚本输出立案报告的雏形:
# 1. 类型审计:哪些列的类型和预期不符 sapply(passengers, class) # 2. 缺失审计:总数 + 比例,一次看清 miss <- colSums(is.na(passengers)) cbind(miss, pct = round(miss / nrow(passengers) * 100, 1)) # 3. 类别列取值审计:登船港口有没有拼错 table(passengers$Embarked, useNA = "ifany") # useNA 参数让 NA 也进表,防止"看不见的缺失" # 4. 数值列合理性:票价为 0 的"幽灵票" sum(passengers$Fare == 0, na.rm = TRUE)
第 2 步的输出形如:Age 177 条占 19.9%,Cabin 687 条占 77.1%,其余列为 0。第 4 步通常揪出十几张零票价记录——很可能是船员或补录失误。至此问题清单成型:年龄大量缺失、舱位几乎全缺、港口有零星缺口、票价有幽灵值。每一项都进入下一节的清洗立项。
从 CSV 到其他案卷格式
真实案卷不只是 CSV,通道对照如下:
| 数据形态 | 推荐函数 | 所在包 | 一个注意点 |
|---|---|---|---|
| 逗号分隔 | read_csv | readr | 编码参数处理中文 |
| 制表符/其他分隔 | read_delim | readr | 必须显式指定分隔符 |
| Excel 工作簿 | read_excel | readxl | 指定 sheet 与跳过行 |
| 剪贴板临时数据 | read_clip / 手动 | —— | 只适合临时查看,勿进正式脚本 |
| 网上直读 | read_csv 加网址 | readr | 注意可复现性,建议先下载存档 |
选通道的原则只有一条:留下可复现的笔录。凡是"从剪贴板粘进来"的数据,脚本换台电脑就失效;正式案卷一律走文件路径,且原始文件只读不动。
⚠️ 排错实录:有新手报告 read_csv 报错 could not find function,这几乎总是忘了 library(readr) 或包没装——报错发生在函数名上而不是文件上。先跑
search()看当前挂载的包,再决定是补装还是补加载。
概念辨析:NA、空串与"看起来像缺失"
- NA:R 的正式缺失标记,is.na 能认;数值列的 NA 参与运算会传染。
- 空字符串 "":字符列常见,is.na 认不出,要
x == ""单独查。 - 空格串 " ":Excel 导出的重灾区,
trimws()先扫一遍再查空串。 - 哨兵值:用 -999、0 之类"约定值"占位的缺失,summary 一看极值就能识破,勘验时必须还原成 NA 再统计。
四种"缺失"混在一起是脏数据的常态。立案阶段的目标是把它们全部翻译成同一种语言——NA,后续清洗才有统一接口。
本节要点回顾
- 两套通道各有场景:readr 快而干净,基础包兼容因子与旧代码
- 四大导入事故:编码、表头、分隔符、脏字符,都有对症参数
- colSums 拼配 is.na:一列一数,缺失清点的标准手法
- 检视输出的是问题清单:类型异常、缺失、可疑分布都要记录在案
- 先类型后分布:类型不纠正,分布无从谈起