3.1 长宽数据重塑:把档案摆成可查的形状
3.1 长宽数据重塑:把档案摆成可查的形状
本节摘要:长表是"每个观测一行",宽表是"每个观测一列",tidyr 包的 pivot_longer 与 pivot_wider 负责两者互转。本节用各国历年寿命数据演示变形全过程、变形时的命名与类型陷阱,并给出"何时该长、何时该宽"的判断标准。
证据的两种摆法
先看同一份证据的两种形状。长表像流水账:国家、年份、数值三列,行数等于国家数乘年份数。宽表像报表:每行一个国家,每年占一列。
library(tidyr) long_df <- gapminder_long # 国家 country、年份 year、寿命 lifeExp 三列 # 长转宽:每个年份变成一列 wide_df <- pivot_wider( long_df, names_from = year, # 哪一列的取值变成新列名 values_from = lifeExp # 哪一列的值填进新列 ) # 宽转长:把年份数据收回两列 back_to_long <- pivot_longer( wide_df, cols = `1952`:`2007`, # 要收回的年份列 names_to = "year", # 列名收进哪一列 values_to = "lifeExp" # 数值收进哪一列 )
一去一回,行数应该复原——这是每次变形后的例行验证:nrow(back_to_long) == nrow(long_df)。
变形事故两宗
第一宗:宽表年份列名被读成字符 1952,pivot_longer 时要用反引号引用列区间;若导入时保留了数字列名,类型混乱会尾随到画图阶段。
第二宗:长转宽时如果同一"国家-年份"组合出现两条记录,pivot_wider 会把单元格变成列表列——表面是数据框,实际每格装着一个小向量,后续汇总全线报错。先查重再变形:
long_df %>% count(country, year) %>% filter(n > 1)
长宽形状选择指南
| 场景 | 优选形状 | 理由 |
|---|---|---|
| ggplot2 分组上色 | 长表 | 把"年份"映射给颜色只需一个变量 |
| group_by 分组汇总 | 长表 | 分组变量天然是列 |
| 人眼看横向对比 | 宽表 | 一行一实体,扫一眼可比 |
| 与表格软件互通 | 宽表 | 透视表习惯 |
ggplot2 的图形语法建立在长表之上,这是 R 世界"长表为分析态、宽表为展示态"惯例的根源。
长宽变形示意
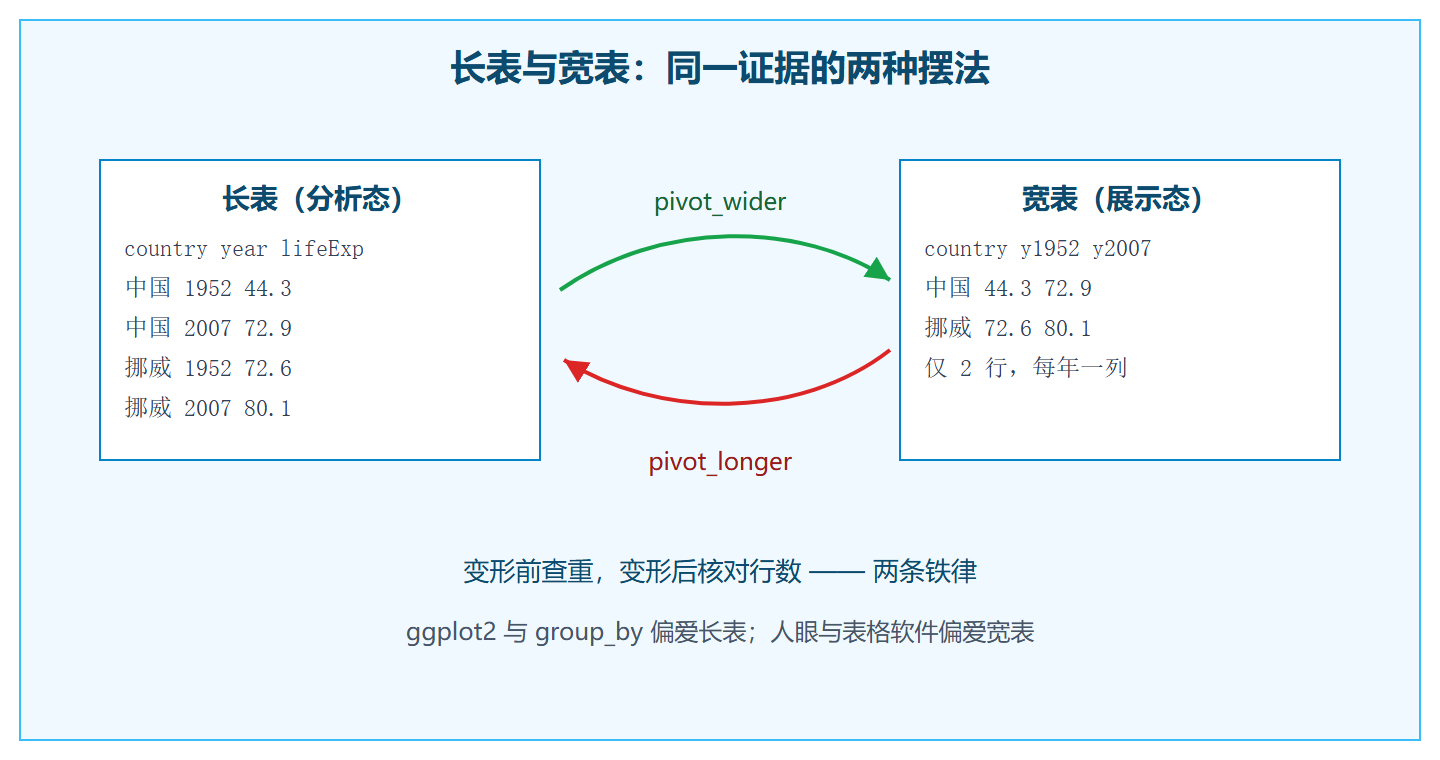
⚠️ 常见坑:pivot 后忘检查,列表列或行数对不上都发现不了。变形三步走——查重、变形、验行数,缺一不可。
完整演练:一份四年小档案的往返变形
用一份只有两个国家、四年的微型档案,把变形每一步的中间结果都看清楚。小样本的好处是能肉眼核对每个单元格:
library(tidyr); library(dplyr) mini <- data.frame( country = c("中国", "中国", "中国", "中国", "挪威", "挪威", "挪威", "挪威"), year = rep(c(1952, 1962, 1972, 1982), 2), lifeExp = c(44, 44.5, 55.5, 65.5, 72.7, 73.4, 74.2, 75.4) ) # 第一步:长转宽,看形状怎么变 mini_wide <- pivot_wider(mini, names_from = year, values_from = lifeExp) # 结果 2 行 5 列:country + 四个年份列,列名是"1952"等字符 # 第二步:计算每国的十年增幅——宽表上做横向对比最直观 mini_wide %>% mutate(增幅1952_1982 = `1982` - `1952`) # 中国 +21.5 岁,挪威 +2.7 岁:起点低的追赶空间更大 # 第三步:宽转回收长,验证可复原 back <- pivot_longer(mini_wide, cols = -country, names_to = "year", values_to = "lifeExp") nrow(back) == nrow(mini) # TRUE —— 往返验证通过
注意第三步用 cols = -country 的写法:声明"除 country 外全部收拢",比逐列点名更抗改动——将来年份列增减,代码一行不用改。还要留意变形后 year 列是字符型,画时间趋势图前需 as.integer 转回数值,否则 x 轴按字典序排布,2007 会排在 1952 前面。
变形参数速查与两个进阶动作
| 参数 | 所在函数 | 作用 | 典型事故 |
|---|---|---|---|
| names_from | pivot_wider | 指定哪列的取值当新列名 | 列名带单位或空格,后续引用要反引号 |
| values_from | pivot_wider | 指定哪列的值填表 | 同组合多值时生成列表列 |
| names_prefix | pivot_longer | 收拢时给新列名去前缀 | 年份列名常带 X 或年份前缀 |
| names_transform | pivot_longer | 收拢同时转换类型 | 顺手 as.integer,省一步后处理 |
| values_drop_na | pivot_longer | 丢掉取值缺失的行 | 适合"结构性缺失"而非登记缺失 |
进阶动作一:多指标同时收拢。当宽表里既有寿命列又有 GDP 列,用 names_to 加 .value 特殊值一次拆两层:
# 宽表列名形如 lifeExp_1952、gdpPercap_1952 的场合 pivot_longer(df, cols = -country, names_to = c(".value", "year"), names_sep = "_") # 结果自动生成 lifeExp、gdpPercap 两列指标 + year 列
进阶动作二:变体——把"宽"画成分面图。有时不需要真变形,ggplot2 的 facet 分面直接吃长表,把每个国家一个小面板;先想清楚"分析要的是新列还是新面板",能少一次无谓的往返。
本节要点回顾
- 长表分析态、宽表展示态:形状跟着用途走
- names_from 与 values_from:长转宽的两个核心参数
- cols 与 names_to、values_to:宽转长的对应三参数
- 组合查重防列表列:count 加 filter 是变形前的安检门
- 往返验证行数:一去一回 nrow 必须复原