2.2 修补缺口:缺失值与异常值清洗
2.2 修补缺口:缺失值与异常值清洗
本节摘要:清洗的两个主战场是缺失值与异常值。本节用 is.na 与 complete.cases 定位缺口,讲清"先问为什么缺,再决定怎么补"的处置原则,演示均值插补、分组插补、单独成类三种策略;再用箱线图规则揪出票价离群值,并处理重复记录。
缺口勘察
上一节清点出年龄列缺约 177 条。动手修补前,先做一个关键的侦查动作——缺失是否与结果有关:
passengers$age_missing <- is.na(passengers$Age) # 对比:缺年龄的人与不缺的人,生还率是否不同 tapply(passengers$Survived, passengers$age_missing, mean)
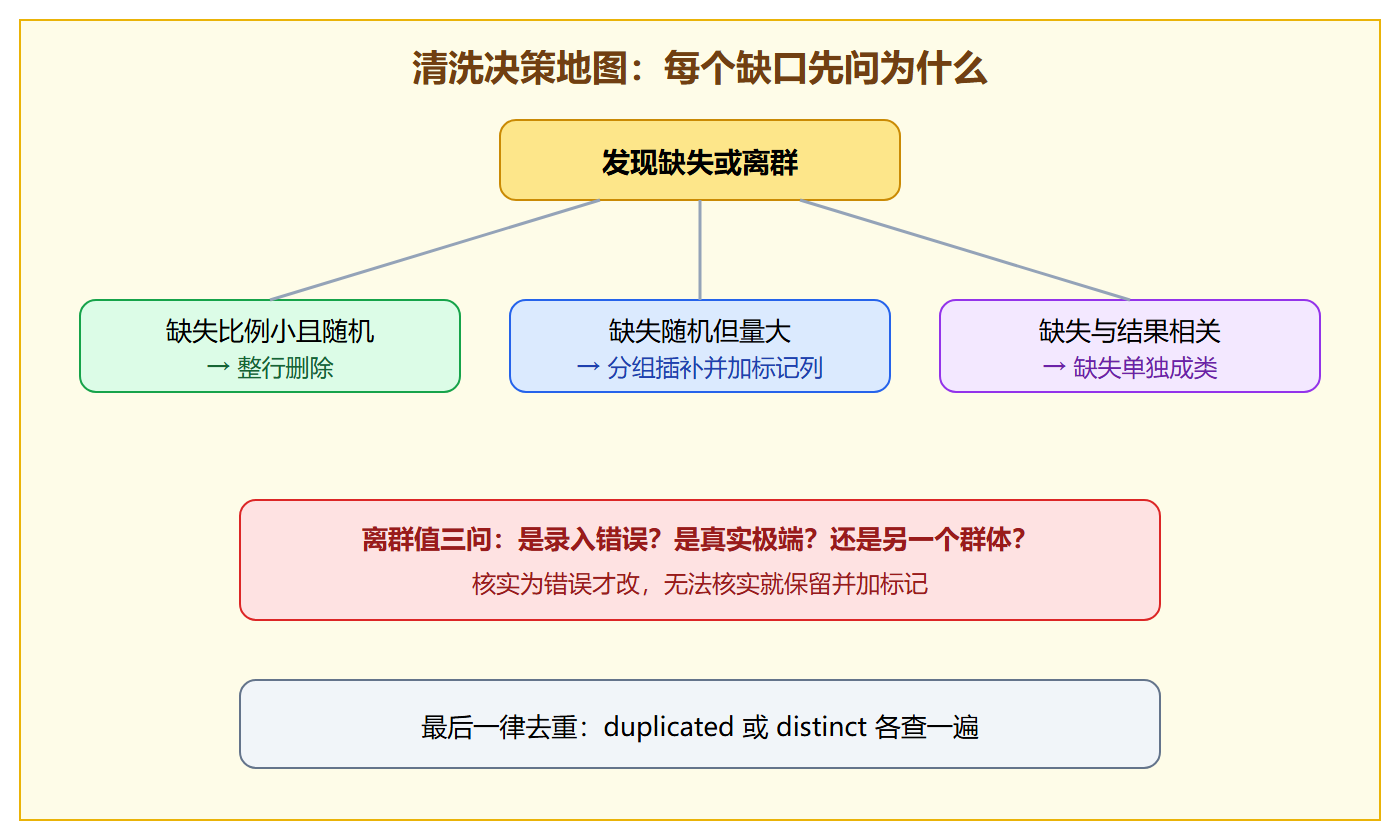
如果两组生还率差异明显,说明"缺失"本身携带信息(比如三等舱乘客登记不全),此时简单删行会把证据链剪断。三种策略对应三种案情:
| 策略 | 适用案情 | 代价 |
|---|---|---|
| 整行删除 complete.cases | 缺失比例很小、且随机 | 损失样本量 |
| 插补(均值/中位数/分组) | 缺失随机、列分布稳定 | 压低方差,扭曲分布 |
| 缺失单独成类 | 缺失有业务含义 | 需转为因子列 |
# 策略二示例:按舱位等级分组,用组内中位数补年龄 library(dplyr) passengers <- passengers %>% group_by(Pclass) %>% mutate(Aage = ifelse(is.na(Age), median(Age, na.rm = TRUE), Age)) %>% ungroup()
na.rm = TRUE 是清洗阶段的高频参数:只要向量里有缺失,mean、median、sum 都会返回 NA,必须显式告诉 R"算的时候把缺失扔掉"。
离群值:票价里的异常信号
boxplot(passengers$Fare, horizontal = TRUE) fare_low <- quantile(passengers$Fare, 0.25, na.rm = TRUE) fare_high <- quantile(passengers$Fare, 0.75, na.rm = TRUE) iqr <- fare_high - fare_low outliers <- passengers$Fare > fare_high + 1.5 * iqr sum(outliers) # 超出箱线图上须的条数
四分位距规则划出的"异常"未必是错误:天价票价可能是头等舱套房的真实记录。清洗的原则是可疑先核实,确认错误才修正,无法核实的保留并加标记列。
清洗决策地图
去重收尾
sum(duplicated(passengers)) # 完全重复的行数 passengers <- distinct(passengers) # dplyr 去重
⚠️ 常见坑:插补前忘加
na.rm = TRUE,median 静默返回 NA,结果整列被 NA 覆盖。R 对缺失的默认态度是"传染"——不明确排除,它就把 NA 传给结果。
三种插补策略的实测对比
光讲原则不过瘾,把三种策略真的各跑一遍,看它们对结论的实际影响。衡量口径:补完后年龄均值与生还率关联的变化:
library(dplyr) # 策略 A:整行删除 df_a <- passengers %>% filter(!is.na(Age)) # 策略 B:全局中位数插补 df_b <- passengers %>% mutate(Age_imp = ifelse(is.na(Age), median(Age, na.rm = TRUE), Age)) # 策略 C:按舱位分组插补(三等舱更年轻,组内中位数更贴近真实) df_c <- passengers %>% group_by(Pclass) %>% mutate(Age_imp = ifelse(is.na(Age), median(Age, na.rm = TRUE), Age)) %>% ungroup() # 三种策略下的年龄均值与"未成年人生还率" sapply(list(删除 = df_a$Age, 全局 = df_b$Age_imp, 分组 = df_c$Age_imp), mean, na.rm = TRUE) tapply(df_c$Survived[df_c$Age_imp < 18], df_c$Pclass[df_c$Age_imp < 18], mean)
典型输出:分组插补的均值比全局插补低一岁多——因为缺失年龄集中在三等舱,而三等舱整体更年轻,全局中位数把它们"补老"了。这就是插补的隐性代价:选错基准,补出来的证据系统性跑偏。三选一的判断依据回到案情:缺失集中在哪、那群人有什么特征。
变式:缺失成列时该怎么办
舱位列缺了七成七,任何插补都是编数据。此时的正确动作是"降维处理":不补,只提取确定性最高的信息派生成新列:
passengers <- passengers %>% mutate(has_cabin = !is.na(Cabin)) # 有没有舱位记录,本身就是线索 tapply(passengers$Survived, passengers$has_cabin, mean) # 典型结果:有舱位记录者生还率约 0.67,无记录者约 0.30
一列七成缺失的"废字段"翻身变成强特征——有舱位记录的多是头等舱、登记规范的人群。这个变式演示了清洗的更高心法:与其抢救数值,不如提炼信息。
离群值处置的三条路线
| 路线 | 动作 | 适用 |
|---|---|---|
| 核实后修正 | 0 票价查证后改 NA | 有旁证(票根、原始档案) |
| 保序变换 | Fare 取对数再建模 | 保数据但压影响,第 6 章会用到 |
| Winsorize 缩尾 | 超过 99 分位的截到 99 分位 | 报表口径统一场景 |
# Winsorize 演示:把最顶端 1% 的票价拉回 99 分位 cap <- quantile(passengers$Fare, 0.99, na.rm = TRUE) passengers$Fare_w <- pmin(passengers$Fare, cap) summary(passengers$Fare); summary(passengers$Fare_w) # 对比 Max 从 512 降到约 250,中位数不动——只削尖不换芯
本节要点回顾
- 先问为什么缺:缺失机制决定处理策略,删行只是三选一
- na.rm 参数:一切汇总函数在脏数据上的安全带
- 四分位距规则:客观划线,但"异常"不等于"错误"
- 修正三原则:核实、修正、标记,顺序不能乱
- 去重收尾:duplicated 检查,distinct 清除