5.1 描述性统计:给证据画像
5.1 描述性统计:给证据画像
本节摘要:描述统计回答"证据长什么样"——中心在哪(均值、中位数)、铺得多开(方差、标准差、四分位距)、形状如何(偏度、峰度)。本节给 sleep 数据集的两组睡眠增量画像,讲清每个指标容易被什么带偏,以及"先画像再检验"的纪律。
案卷与画像动作
data(sleep) str(sleep) # 20 行:extra 睡眠增量、group 药物组、ID 受试者编号 # 分组画像:两组各来一套 library(dplyr) sleep %>% group_by(group) %>% summarize( n = n(), 均值 = mean(extra), 中位数 = median(extra), 标准差 = sd(extra), 最小 = min(extra), 最大 = max(extra), .groups = "drop" )
典型输出:一组的平均增量约 0.75 小时,另一组约 2.33 小时,差 1.58 小时。但只看均值就下结论为时过早——画像要看全三个维度。
画像三问
# 第一问:中心在哪,两个"中心"打架吗 mean(sleep$extra[sleep$group == 1]) median(sleep$extra[sleep$group == 1]) # 均值与中位数差距明显 → 提示偏态或离群,报告中位数更稳 # 第二问:铺得多开 var(sleep$extra[sleep$group == 1]) # 方差 sd(sleep$extra[sleep$group == 1]) # 标准差:与原数据同单位 IQR(sleep$extra[sleep$group == 1]) # 四分位距:中间一半的宽度 # 第三问:形状如何 hist(sleep$extra[sleep$group == 2]) boxplot(extra ~ group, data = sleep)
每个指标的软肋
两套配套画像的分工
| 指标 | 回答的问题 | 软肋 |
|---|---|---|
| 均值 | 中心位置 | 被极端值拉偏 |
| 中位数 | 中心位置(抗扰) | 对分布两端不敏感 |
| 标准差 | 平均离散 | 同样受极端值影响 |
| 四分位距 | 中段离散 | 丢掉两端信息 |
| 直方图与箱线 | 整体形状 | 受分组宽度影响 |
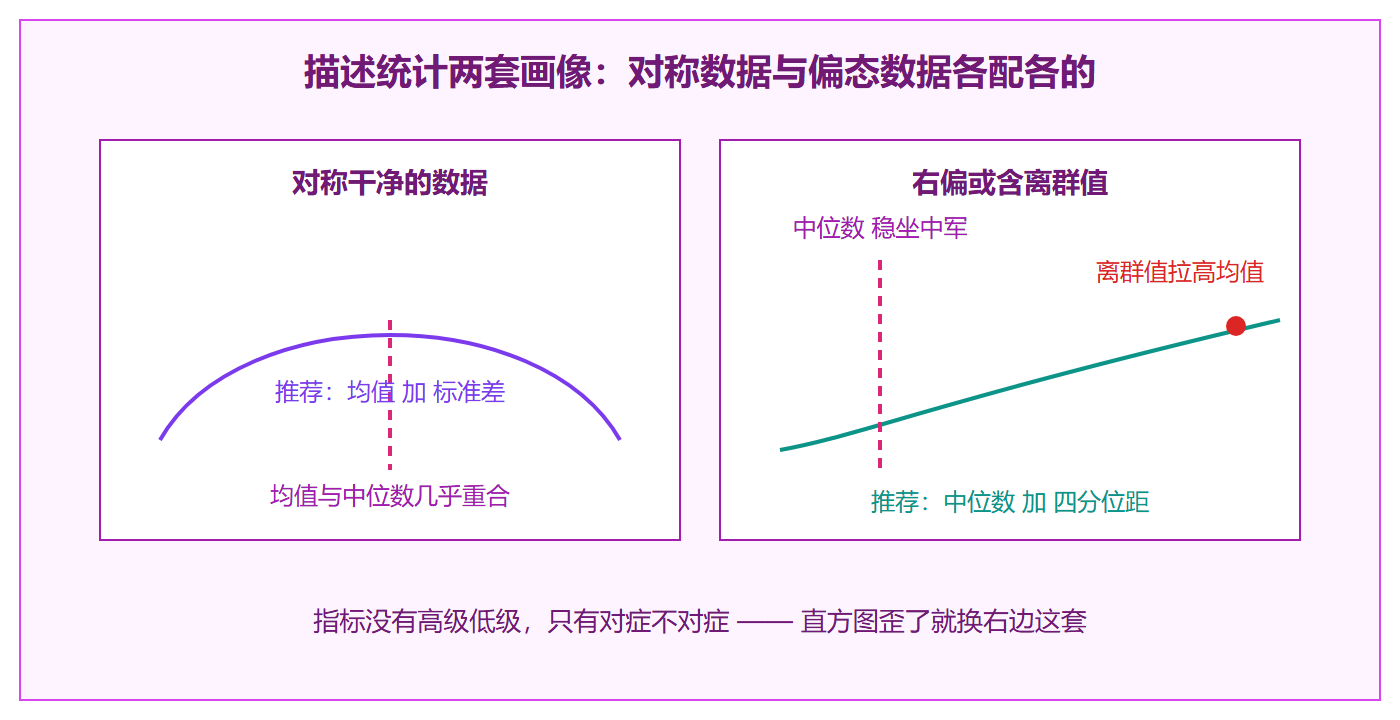
💡 关键直觉:均值配标准差、中位数配四分位距,这是两套"配套画像"。数据对称干净用前一套;一旦直方图歪了或箱线图须子很长,换后一套——指标没有高级低级,只有对症不对症。
# 一条看分布位置的快捷命令 tapply(sleep$extra, sleep$group, summary)
⚠️ 常见坑:跳过画像直接检验。若某组分布严重偏斜、样本又小,t 检验的前提就不稳。规矩是:先 hist 加 boxplot,再决定用什么检验——第 2 节的分岔正由此而来。
复盘演练:一条离群值如何带偏画像
画像指标的抗扰性,造一组数据实测最直观:
set.seed(2024) g1 <- c(sleep$extra[sleep$group == 1], 10) # 塞进一个离群值 # 均值配标准差:全线被带偏 mean(g1); sd(g1) # 中位数配四分位距:几乎不动 median(g1); IQR(g1) # 换算成对比:离群值前后两套指标的变化幅度 c(均值 = mean(g1) - mean(sleep$extra[sleep$group == 1]), 中位数 = median(g1) - median(sleep$extra[sleep$group == 1])) # 典型输出:均值被拉高约 0.9,中位数几乎不变
这一实测把表格里的"软肋"落成了数字:一个离群值能把均值拉动接近一小时,而中位数稳如泰山。所以报告里报哪个中心,取决于分布形态而非习惯——直方图歪了,中位数才是诚实的中心。
分组画像的整洁版本:一步到位出报告表
第 2 章的 dplyr 手法这里升级成"可直接进报告"的画像表:
library(dplyr) sleep %>% group_by(group) %>% summarize( n = n(), 均值 = round(mean(extra), 2), 标准差 = round(sd(extra), 2), 中位数 = median(extra), 四分位距 = IQR(extra), 偏度提示 = ifelse(abs(mean(extra) - median(extra)) > sd(extra) / 2, "疑似偏态", "大致对称"), .groups = "drop" )
最后一列把"均值中位数打架"的判读自动化了:两者差距超过半个标准差即提示偏态。这类小判据写进画像流水线,能防住"扫一眼就过"的漏检。生产中还可以再套一层 skimr 包的 skim 函数,一行代码给全表每个变量出一张标准画像卡。
概念辨析:描述统计的边界
描述统计只对眼前这份样本负责,不做任何外推。三类越界话术要警惕:"两组均值差 1.58,所以药物二更好"——没提抽样波动,越界了;"本组受试者睡眠平均增加 2.33 小时"——只描述样本,合规;"服药后全人群平均可多睡 2.33 小时"——外推到总体,需要推断统计背书。画像回答"样本里发生了什么",检验回答"能推广到哪",两个阶段的话术边界,就是本节与下一节的边界。
一个综合小考:给 mpg 的城市油耗画像
把本节手法迁移到新数据上自测一遍:对油耗案卷的城市油耗列,先出直方图与箱线图各一张,再补一张按车型类别的分组箱线,最后用一行判读收尾——分布是否偏态、组间是否分层、有无离群嫌疑。参考判读:分布右偏且类别间台阶明显,皮卡与运动型两类的中位数明显低于紧凑型,报告应改用中位数配四分位距的口径。能在十分钟内独立完成这套动作并写出三句判读,本节即告通过。
补一个口径提醒:描述统计的每个数字都要能回答"算在谁头上"——n 是多少、缺失怎么处理、单位是什么。同一列带 NA 时 mean 与 mean 加 na.rm 的结果可以差一大截,画像表里写清 n 与缺失处理方式,这张表才算合格的卷宗。
本节要点回顾
- 画像三问:中心、离散、形状,缺一不可
- 两套配套指标:均值标准差一套,中位数四分位距一套
- 均值与中位数打架是偏态的第一信号
- tapply 分组 summary:一行出多组画像
- 先画像后检验:分布形状决定检验方法的选择
- 报数必带口径:n、缺失处理、单位三件套随行