6.1 线性回归:给房价找解释变量
6.1 线性回归:给房价找解释变量
本节摘要:线性回归用 lm 拟合、用 summary 读系数、用 plot 做残差诊断。本节在住房数据上走完整流程:先单变量入门再进多变量,重点讲系数的正确读法、R 方的陷阱,以及残差诊断如何判定"这个模型能不能用"。
起手:一元回归
data(Boston, package = "MASS") # 住房案卷:506 街区 14 列 # 房价中位数 随 低收入家庭比例 变动的回归 fit1 <- lm(medv ~ lstat, data = Boston) summary(fit1)
summary 输出的核心三行:系数表(估计值、标准误、t 值、p 值)、R 方、整体 F 检验。系数读法要抠字眼:lstat 的斜率约 -0.95,含义是"低收入比例每高一个百分点,房价中位数平均低约 0.95(千美元),其他条件不变时"——加粗的这两处限定词,是回归解释的地基。
进阶:多变量与因子
fit2 <- lm(medv ~ lstat + rm + ptratio + chas, data = Boston) summary(fit2)
rm(户均房间数)斜率为正:房间越多房价越高,符合直觉。chas(是否临河)是 0/1 变量,系数读作"临河街区比不临河的平均贵多少"。- 因子变量进入回归会自动拆成哑变量组,基准水平的效应被吸进截距。
R 方的陷阱
R 方衡量"方差被解释的比例",但它只增不减——往模型里塞无关变量,R 方照样微涨。多变量比较请看调整 R 方,它对变量个数施加惩罚。更诚实的做法是留出验证:
train_idx <- sample(nrow(Boston), 0.8 * nrow(Boston)) fit_tr <- lm(medv ~ lstat + rm, data = Boston[train_idx, ]) pred <- predict(fit_tr, Boston[-train_idx, ]) sqrt(mean((pred - Boston$medv[-train_idx])^2)) # 留出集均方根误差
训练集 R 方再漂亮,留出集误差一塌糊涂就是过拟合的铁证。
残差诊断:模型的体检报告
par(mfrow = c(2, 2)) plot(fit2) # 残差图、正态 Q-Q、尺度位置、杠杆图四联诊断 par(mfrow = c(1, 1))
| 图 | 看什么 | 报警信号 |
|---|---|---|
| 残差对拟合值 | 趋势应随机无 Pattern | 弯曲 → 线性假设不成立 |
| 正态 Q-Q | 点应贴对角线 | 尾部甩出 → 残差非正态 |
| 尺度位置 | 红线应水平 | 喇叭口 → 方差不齐 |
| 杠杆与 Cook 距离 | 找异常影响力点 | 个别点高杠杆 → 系数被绑架 |
回归闭环流程
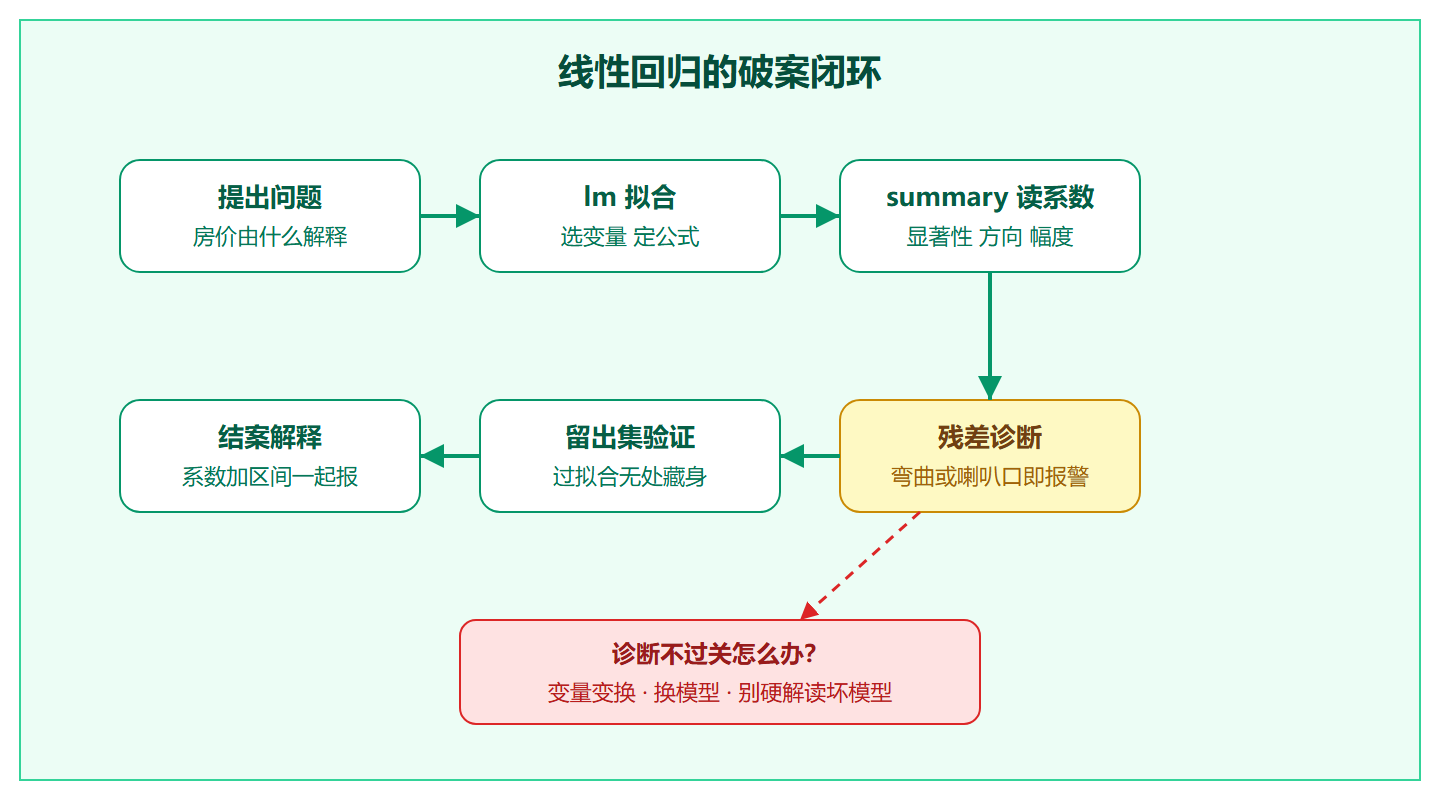
💡 关键直觉:回归系数答的是"关联结构"不是"因果机制"。低收入比例的负系数不等于"降低收入比例就能抬房价"——因果结论需要研究设计,不是 summary 表格能给的。
逐步回归与预测区间
模型变量怎么挑?两条路:按业务逻辑先验定(首选),或让数据辅助筛选。演示后者的经典操作与预测的两种"区间":
# 全模型起步,按 AIC 逐步精简 fit_full <- lm(medv ~ ., data = Boston) fit_step <- step(fit_full, trace = 0) summary(fit_step)$adj.r.squared # 与全模型比:变量少了,调整 R 方未必降 # 预测一个新街区:两种区间含义不同 newb <- data.frame(lstat = 10, rm = 6.5, ptratio = 18, chas = 0) predict(fit2, newb, interval = "confidence") # 均值带:平均房价的区间 predict(fit2, newb, interval = "prediction") # 预测带:单个街区的区间,宽得多
两种区间的区别常被混淆:均值区间回答"这类街区平均房价落在哪",预测区间回答"这一个具体街区落在哪"——个体波动远大于均值波动,预测区间自然宽。给委托人估价时若报的是窄的置信区间,等于把"平均"偷换成了"个案"。
一个真实诊断案例:弯曲的残差
只拟合 lstat 一个变量时,Boston 数据的残差图几乎必然出现弯曲——房价与低收入比例的关系是弯的,不是直的。处置三步:
# 第一步:确诊——残差对拟合值图呈 U 形 fit_lin <- lm(medv ~ lstat, data = Boston) plot(fitted(fit_lin), resid(fit_lin)) # 第二步:处置之一,加二次项 fit_quad <- lm(medv ~ lstat + I(lstat^2), data = Boston) anova(fit_lin, fit_quad) # F 检验:二次项显著改善 # 处置之二,对因变量取对数压右偏 fit_log <- lm(log(medv) ~ lstat, data = Boston) AIC(fit_lin, fit_quad, fit_log) # 信息准则横向比,小者优先
这个案例的教学价值在于:诊断不是走过场,它真的会改判。直线模型的系数解释在弯曲关系下系统性失真;承认弯曲、改造模型之后,"其他条件不变"这句话才重新成立。
⚠️ 排错实录:na.action 的默认是 na.omit,含缺失行被静默丢弃,样本量悄悄缩水。建模前后各查一次 nrow 与 fit$df.residual,缺失多的案卷尤须如此。
本节要点回顾
- 系数读法两限定:"平均"效应、"其他条件不变"
- 调整 R 方做比较:普通 R 方只增不减,会奖励变量堆砌
- 留出集验证:训练表现与泛化表现分开记账
- 四联诊断必做:弯曲、喇叭口、非正态、高杠杆四类报警
- 相关不等于因果:系数是关联结构,因果要靠设计
- 置信区间对均值、预测区间对个案:估价口径别偷换
- 建模前后查自由度:na.omit 静默删行会缩水样本
顺带一个跨章呼应:第 4 章相关矩阵上 lstat 与 rm、ptratio 彼此相关不低,这正是本节留出集验证与第 3 节正则化的伏笔——共线性不毁灭预测力,但会让单个系数的解读失稳,重要变量的系数该看标准化前后与正则化后的稳定性再落笔。