6.2 广义线性模型:预测涨跌归属
6.2 广义线性模型:预测涨跌归属
本节摘要:当结果变量是类别(是否高估价、是否生还),线性回归让位给广义线性模型。本节用 glm 拟合逻辑回归,讲清"对数几率"系数的翻译法、预测概率与分类阈值的设定,以及用混淆矩阵评估分类质量的全套动作。
为什么 lm 干不了这活
用直线拟合"是否"问题会输出 0.32、1.47 这类无意义的"概率"。逻辑回归在外面套一个 S 形压缩函数,把任意取值压回 0 到 1 之间。glm 家族的接口与 lm 几乎一样,多一个 family 参数:
library(dplyr) Boston <- Boston %>% mutate(high = as.factor(medv > 25)) fit_logit <- glm(high ~ lstat + rm + ptratio, data = Boston, family = binomial) summary(fit_logit)
family = binomial 声明"结果是对半类别,用对数几率连接"。
系数翻译术
逻辑回归的系数在对数几率尺度上,直接读没有意义,要翻译:
# 方案一:系数取指数 → 几率比 exp(coef(fit_logit)) # rm 的几率比约 1.8 读作:房间数每多一间, # "高估价"对"不高估价"的几率乘以约 1.8,其他变量不变 # 方案二:直接拿预测概率说话 new_block <- data.frame(lstat = 10, rm = 6.5, ptratio = 18) predict(fit_logit, new_block, type = "response") # 输出 0 到 1 的概率
给委托人汇报用方案二;同行评审用方案一。几率比的"乘法"语感,是逻辑回归系数的正确母语。
分类与评估
prob <- predict(fit_logit, Boston, type = "response") pred <- ifelse(prob > 0.5, 1, 0) # 阈值 0.5 起步,可按代价调整 # 混淆矩阵:四格账本 tab <- table(预测 = pred, 实际 = Boston$high) tab accuracy <- sum(diag(tab)) / sum(tab) # 总准确率 recall <- tab[2, 2] / sum(tab[, 2]) # 查全率:真高新估价中抓到多少
阈值 0.5 不是圣旨:如果漏掉一个高新估价街区的代价远高于误报,把阈值往下调,用召回率换精度——阈值是业务决策,不是数学默认。
分类评估四格账本
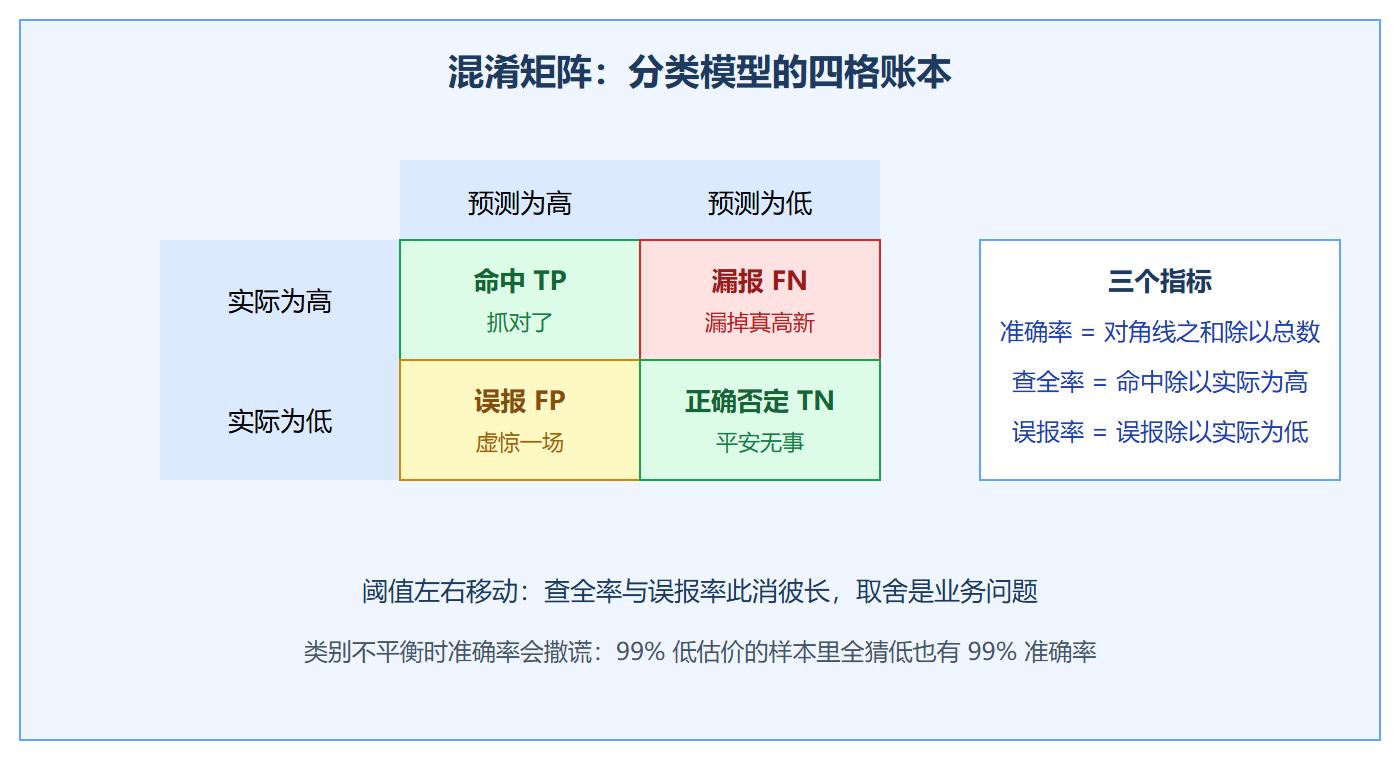
⚠️ 常见坑:类别不平衡时迷信准确率。若高新估价只占 5%,模型"全猜不高"也有 95% 准确率却毫无用处——这时查全率、查准率才是有效证据。回想乘客名单案:生还率约 38%,同样需要盯着混淆矩阵而不是单一准确率。
完整评估演练:分训练测试再算四格账
上面的评估在全部数据上进行,属于"开卷考试"。规范做法是先切分:
set.seed(42) idx <- sample(nrow(Boston), 0.7 * nrow(Boston)) tr <- Boston[idx, ]; te <- Boston[-idx, ] fit_p <- glm(high ~ lstat + rm + ptratio, data = tr, family = binomial) prob <- predict(fit_p, te, type = "response") pred <- ifelse(prob > 0.5, 1, 0) tab <- table(预测 = pred, 实际 = te$high) # 典型输出(列为实际 0/1,行为预测 0/1): # 实际0 实际1 # 预测0 96 18 # 预测1 12 25 round(sum(diag(tab)) / sum(tab), 3) # 准确率约 0.796 round(tab[2, 2] / sum(tab[, 2]), 3) # 查全率约 0.581 round(tab[2, 2] / sum(tab[2, ]), 3) # 查准率约 0.676
查全率 0.58 的含义:十个真高新估价街区只抓到六个。若委托场景是"别漏掉潜力街区",这个模型不合格,须调阈值或加特征——单一准确率 0.80 完全掩盖了这一点,这就是四格账本的价值。
阈值扫描与几率比的正确引用
# 阈值从 0.2 扫到 0.8,看查全率与查准率怎么换手 for (th in seq(0.2, 0.8, 0.2)) { p <- ifelse(prob > th, 1, 0) t <- table(p, te$high) cat("阈值", th, "查全率", round(t[2,2]/sum(t[,2]), 2), "查准率", round(t[2,2]/sum(t[2,]), 2), "\n") } # 几率比引用规范:带置信区间一起报 ci <- exp(confint.default(fit_p)) round(cbind(几率比 = exp(coef(fit_p)), ci), 3) # rm 行典型输出:几率比 1.8,区间不含 1 → 变量有底气的信号
几率比的置信区间不含 1,等价于该系数检验显著——区间和 p 值是同一份证据的两种表述,报告里给区间更直观。扫描段则展示了阈值是连续调节旋钮:0.2 时几乎全召回但精度崩掉,0.8 时反之,落点由漏报与误报的业务代价决定。
概念辨析:概率、几率与对数几率
三个词层层递进:概率 p 是"发生所占的份额"(0 到 1);几率是"发生对不发生的比"(p 除以 1 减 p,0 到无穷);对数几率再取对数(负无穷到正无穷)。逻辑回归的线性部分住在对数几率尺度上,所以系数可加;翻译回几率比是乘法;翻译回概率是 S 曲线。给不同受众汇报,就在这三层之间选楼层:业务层说概率、评审层说几率比、数学层留在对数几率。
本节要点回顾
- glm 加 family 等于 binomial:接口同 lm,结果变量换类别
- 几率比语感:系数取指数,读作"几率乘以多少"
- type 参数取 response:预测输出概率而非对数几率
- 阈值是业务决策:漏报与误报的代价决定 0.5 该不该动
- 不平衡看查全查准:准确率在不平衡场景会撒谎
- 几率比带区间一起报:区间不含 1 才是有底气的信号
- 评估须先切分:全数据上的混淆矩阵是开卷考试
最后一个衔接说明:逻辑回归与线性回归共享"先诊断后采信"的纪律——线性那边看四联残差图,这边看混淆矩阵与阈值扫描,两者都是"模型输出之外必加的复核"。第 3 节的选型档案会把这两套模型放进同一张表里比价。