7.1 面向对象与性能优化:处理大案卷
7.1 面向对象与性能优化:处理大案卷
本节摘要:案卷从五百行涨到五百万行,脚本级的写法开始喘。本节两件事:先建立 S3 面向对象的分派直觉(print、summary 为什么对不同对象各说各话);再给慢代码开处方——向量化、预分配、高性能数据框工具、以及"何时才值得并行"的判断标准。
S3:R 的轻量面向对象
你在前六章早已在用面向对象而不自知:print(fit1) 打印回归结果、print(passengers) 打印数据框,同一个函数两种输出——这就是 S3 泛型分派。机制一句话:对象带一个类标签,泛型函数按标签找对应的"方法"执行。
# 给自己的勘验结果定义一个类 verdict <- list(case = "房价估价案", r2 = 0.74, n = 404) class(verdict) <- "case_verdict" # 按类分派:为它定制打印方法 print.case_verdict <- function(x, ...) { cat("结案:", x$case, "\n样本:", x$n, " R方:", x$r2, "\n") } print(verdict) # 自动命中定制方法
S3 的价值在"接口统一":summary 对 lm 给系数表、对数据框给五数概括,使用者不需要记两套函数名。日常分析用到 S3 的场景大多是"给自建结果对象配 print 与 plot 方法",够用了;更严密的 S4、R6 是包开发者的地界,按需再学。
慢代码处方笺
先诊断,后开药。R 自带的性能计时:
system.time({ result <- numeric(0) for (i in 1:50000) result <- c(result, i * 2) # 反面教材 })
这段代码慢在循环内增长向量:每次 c 拼接都把整个结果复制一遍,五万次复制。三个处方按性价比排序:
# 处方一:预分配容器(第 3 章讲过的"先开房间") system.time({ result <- numeric(50000) for (i in 1:50000) result[i] <- i * 2 }) # 处方二:向量化——直接整算,循环消失 result <- (1:50000) * 2 # 处方三:大数据卷换高性能工具 install.packages("data.table") library(data.table) dt <- as.data.table(big_cases) dt[price > 25, .(mean_area = mean(area)), by = district] # 惯用语法极快
性能诊断决策路径
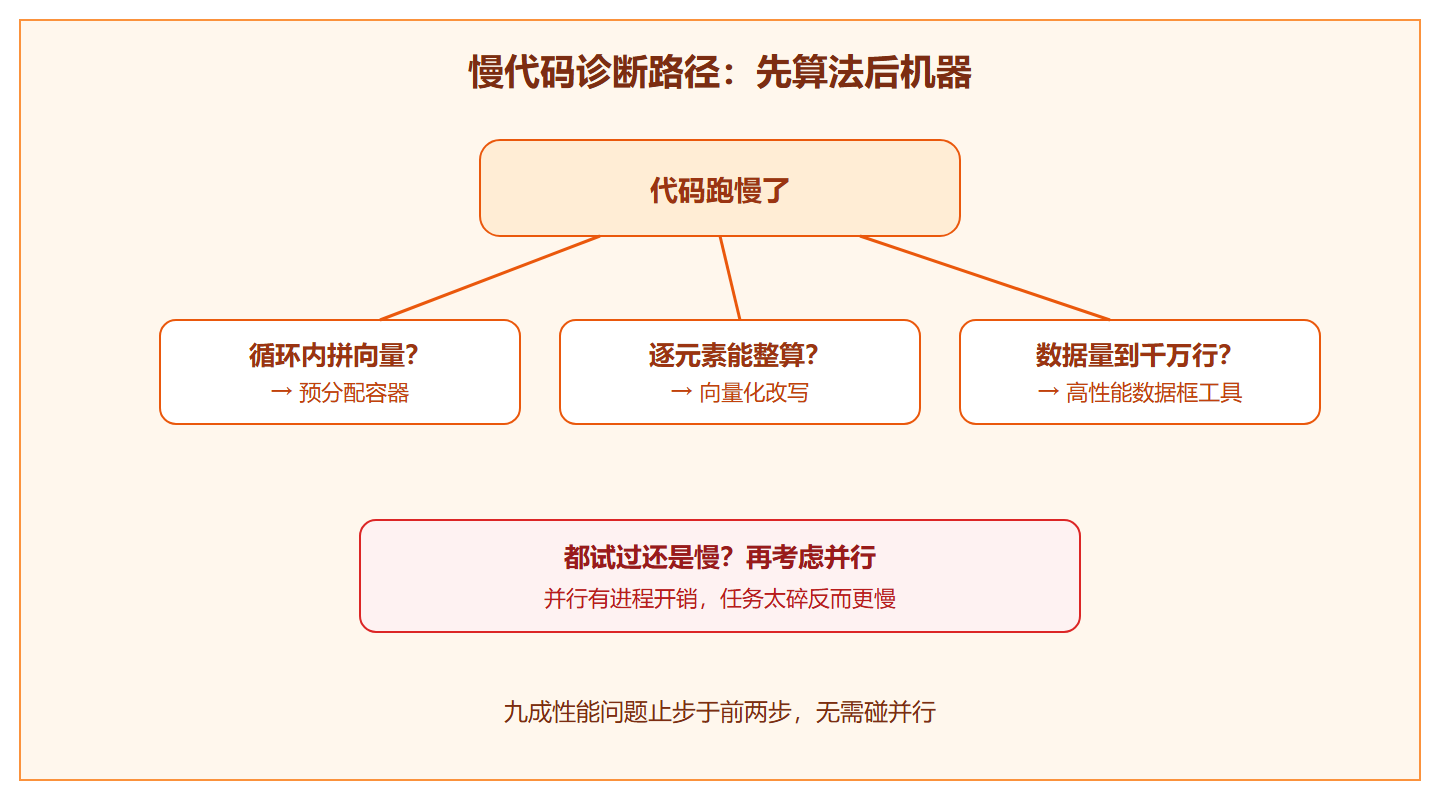
并行的判断标准:单个任务是否足够"肥"。把五百万行分给八个进程,每份都要独立装载数据,进程启动与数据搬运的开销可能吃掉全部收益——任务粒度小于秒级,并行通常得不偿失。
💡 关键直觉:性能优化的顺序是"数据结构、算法、工具、硬件"。多数人卡在第一步:把"循环里长向量"改成"先开好房间",一行代码换一个数量级,这是 R 性能世界的第一条铁律。
性能实测三连:复制陷阱的代价
把三种写法放在同一起跑线上计时,"复制陷阱"的代价看得最清楚:
n <- 100000 # 写法一:循环内增长(反面教材) system.time({ v1 <- numeric(0) for (i in 1:n) v1 <- c(v1, i^2) }) # 典型耗时:数秒级。每次 c() 都全量复制,总复制量约 n 的平方量级 # 写法二:预分配 system.time({ v2 <- numeric(n) for (i in 1:n) v2[i] <- i^2 }) # 快一个数量级以上 # 写法三:向量化 system.time({ v3 <- (1:n)^2 }) # 快到计时器几乎测不出;结果 identical(v2, v3) 为 TRUE
慢的根源不是 for 本身,而是复制语义:R 的对象改值先复制,循环里一次次"长大"的向量把复制成本滚成雪球。诊断性能问题时先找"在循环里变长的对象"——data.frame 逐行 rbind 是它的孪生事故,处方同样是先建容器或改向量化。
data.table 与 dplyr 对照:同题两种语法
同一道分组汇总题(各街区均价),两套工具各写一遍:
library(data.table); library(dplyr) dt <- as.data.table(big_cases) # data.table:条件、汇总、分组一句话写进中括号 dt[price > 25, .(均价 = mean(price)), by = district] # dplyr:链式三步 big_cases %>% filter(price > 25) %>% group_by(district) %>% summarize(均价 = mean(price), .groups = "drop")
语义相同、语感不同:data.table 的三段式(行条件、列操作、分组)紧凑且对大表极快,但学习曲线陡;dplyr 可读性占优,中小数据完全够用。选择建议:团队协作与日常分析用 dplyr,单表上千万行或多表高频聚合再引入 data.table——两套都认得,按案卷规模切换。
并行的开销红线实测
# 模拟"瘦任务"并行:每片只算一小口 system.time({ chunks <- split(1:8000, rep(1:8, 1000)) sapply(chunks, function(k) sum(k)) # 串行 }) system.time({ library(parallel) mclapply(chunks, function(k) sum(k), mc.cores = 8) # 八核并行 }) # 典型结果:并行版反而更慢——进程分叉与汇总的开销超过计算本身
这段反直觉的实测就是"开销红线"的具象化:任务片没有毫秒到秒级的计算量,并行的调度成本就是纯亏。判断口诀:先向量化、再换工具、最后才并行,且并行前用 system.time 证明瓶颈真在 CPU 而不是 IO。
本节要点回顾
- S3 按类分派:泛型函数加方法后缀,print 各说各话的原理
- 循环内拼向量是头号慢因:预分配容器立竿见影
- 向量化是第二处方:能整算就不逐个算
- data.table 级工具管大案卷:语法换了速度换来的
- 并行是最后手段:任务粒度不够肥,开销反噬收益
再强调一次诊断的次序:拿到慢代码先计时定位热点,再对症下药——多数人高估了需要"高级手段"的比例,实测里九成的慢代码倒在预分配与向量化这两招初级处方上,真正要并行或换 data.table 的案子,一个季度遇不上几回。