2.1 函数即服务 FaaS 深入解析
2.1 函数即服务 FaaS 深入解析
本节摘要:FaaS 是 Serverless 的计算核心。本节钻进它的内部:函数从被触发到返回经历什么、无状态为什么是自动伸缩的前提、按需付费到底怎么算、以及它和传统服务器架构差在哪。配上能跑的代码,让概念落地。
学完这节你能做到
阅读完本节,你应当能够:
- 描述 FaaS 函数从触发到返回的完整生命周期
- 解释无状态与自动伸缩的因果关系
- 算出一笔 FaaS 的计费账
- 写一个处理 HTTP 请求和处理对象存储事件的函数
- 说清 FaaS 相对传统架构的取舍
一、函数的一生:从触发到返回
理解 FaaS,最直接的办法是跟着一次请求走一遍它的生命周期。
关键在中间那个分支:有没有热实例。如果有,请求几乎立刻被处理;如果没有,平台要先拉起运行时、加载代码和依赖,这就是第 1 章讲过的冷启动。处理完后,实例如果闲着没事,过一会儿会被回收归零——这是"缩放至零",也是 FaaS 省钱的根源。
💡 关键直觉:你写的函数代码本身是"无状态、可随时拉起丢弃"的,平台才能放心地随时增删实例。一旦你的函数偷偷藏了状态(比如依赖某个内存变量跨请求共享),伸缩就会出问题。无状态不是限制,是伸缩能成立的前提。
二、无状态:自动伸缩的地基
为什么 FaaS 反复强调无状态?因为只有每个实例都互相独立、不依赖彼此,平台才能毫无顾虑地加减实例数量。想象一下,如果函数实例之间共享内存状态,那加一个新实例它得先去同步状态、删一个实例还得先迁移状态——伸缩就慢且复杂。无状态让每个实例都是"克隆体",来一个请求随便丢给哪个实例都能处理,伸缩因此变成简单的加减法。
那应用需要状态怎么办?把状态外置到 BaaS 里——数据库存业务数据、缓存存热数据、对象存储存文件。函数每次执行时从外部读取、处理完写回外部。状态管理从"函数内部"挪到了"BaaS 服务",这是 Serverless 架构和传统架构最大的思维转变之一。
⚠️ 常见坑:在函数里用模块级变量缓存数据,指望下次请求能读到。在低频调用下可能恰好"蒙对"(同一热实例),一旦流量上来平台扩出新实例,缓存就失效甚至各实例数据不一致。要缓存就用外部缓存服务,别用函数内存。
三、自动伸缩:0 到 N 的弹性
FaaS 的伸缩是平台根据并发请求量自动做的。下面这张图示意流量来了实例数怎么涨、流量退了怎么归零。
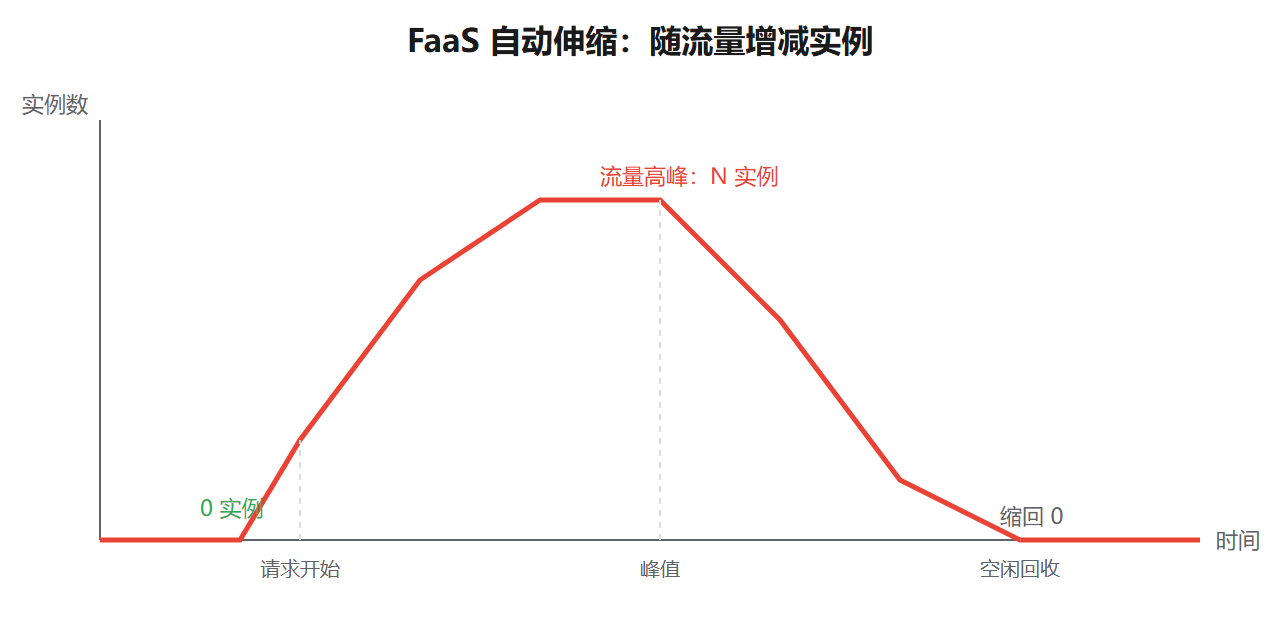
平台看并发请求量动态加减实例:请求一来,从 0 起拉实例(冷启动就发生在这);流量持续高就加到 N 个;流量退了,闲实例逐渐被回收,最终归零。整个过程开发者完全不介手。
伸缩的依据通常是:并发请求数、事件队列长度、资源利用率。各家平台策略不同,但思路一致——跟着负载走。
四、按需付费:算一笔账
FaaS 计费几乎都基于三个量:调用次数 × 执行时长 × 分配内存。
打个比方(数字仅示意):假设某平台计费是"每百万次请求 2 元 + 每 GB·秒 0.03 元"。你有一个函数分配 256MB 内存,平均每次跑 200 毫秒,一天被调用 10 万次。
- 请求费用:0.1 百万次 × 2 元 = 0.2 元
- 计算费用:100000 次 × 0.25 GB × 0.2 秒 = 5000 GB·秒 × 0.03 元 = 150 元 ÷ 1百万 ≈ 很低
换算下来一天可能就几毛到几块钱。如果这个函数一天只被调用几十次(内部小工具),费用几乎可以忽略——这就是"缩放至零 + 按需付费"的威力。
⚠️ 但反过来:如果一个高频大流量接口每天被调用上亿次,按调用次数计费可能远超一台常驻机器的钱。FaaS 的成本优势在低频侧,高频侧要算清。
五、代码:两个典型场景
场景一:处理 HTTP 请求(最常见)。Python 版骨架:
import json def handler(event, context): # event 里有 HTTP 请求的方法、路径、请求体等 name = event.get("queryStringParameters", {}).get("name", "World") return { "statusCode": 200, "body": json.dumps({"message": f"Hello, {name}!"}), }
场景二:处理对象存储事件(如图片上传后生成缩略图)。这种最能体现事件驱动的味道——用户上传图片触发函数,函数处理后把缩略图写回存储:
def handler(event, context): for record in event["Records"]: bucket = record["s3"]["bucket"]["name"] key = record["s3"]["object"]["key"] # 下载原图 → 生成缩略图 → 上传到 thumbnails/ 前缀下 process_image(bucket, key) # 伪代码:用图像库处理
注意两个示例的 event 结构不同:HTTP 触发时 event 里是请求信息,对象存储触发时 event 里是 Records 数组(可能批量)。同一段函数代码,被不同事件源触发时,event 的结构完全不同——这是写 FaaS 函数要适应的地方。
六、FaaS vs 传统架构
| 特性 | 传统服务器(VM/容器) | FaaS |
|---|---|---|
| 服务器管理 | 自己配、自己运维 | 平台全管 |
| 资源分配 | 预先分配,常驻 | 按需拉起,用完回收 |
| 伸缩 | 手动配置策略 | 自动,跟着负载 |
| 计费 | 按实例运行时长 | 按实际执行次数 × 时长 |
| 状态 | 可维护本地状态 | 无状态,状态外置 |
| 启动 | 机器启动慢 | 冷启动偶发延迟 |
这张表浓缩了取舍:你用"控制力和本地状态"换了"免运维和弹性"。哪个更值,取决于你的场景。
七、执行模型的演化:从每请求一实例到更多可能
生命周期那张时序图描述的是 FaaS 的经典模型,但它本身也在演化,值得了解几个方向,它们直接影响你今天的设计决策。
第一个演化是执行环境复用。早期平台严格"一请求一沙箱",用完即毁;后来各家都引入了实例复用——处理完请求的实例保温几分钟,下一个请求直接复用,冷启动摊薄。这带来一个微妙的变化:模块级变量在复用窗口内"看起来能缓存了",于是很多开发者开始把配置、数据库客户端放在模块顶层初始化。这没错,甚至是官方推荐的最佳实践,但要清醒地知道它是优化不是依赖——复用是平台的恩赐,不是承诺,实例随时可能被回收重建。正确的心智模型是:模块级初始化当"免费的加速"用,逻辑正确性不能建立在它之上。判断标准很干净:把变量想象成每次都重新初始化,程序依然正确,那这个用法就是安全的。
第二个演化是并发复用。经典模型里一个实例同时只处理一个请求,吞吐靠实例数堆;新一代平台允许单实例内多线程/多协程并发处理多个请求,Java 等冷启动重的运行时因此受益明显——实例少了,冷启动总量随之下降。对开发者的新要求是:函数代码要线程安全,共享的客户端对象要考虑并发调用。
第三个方向是沙箱技术的替换。从传统容器换到微虚拟机(启动毫秒级、隔离更强),再到 WASM 类轻量运行时的探索,目标都指向同一个靶心:把冷启动的常数项压下去。这条线还没收敛,但方向明确——平台层在持续偿还"缩放至零"欠下的延迟债。
八、给函数新手的四条实操纪律
初始化放模块顶层,不放 handler 里。 依赖加载、SDK 客户端创建放在模块顶层,实例复用时只需执行一次;放在 handler 里则每个请求都重来,白白把延迟叠进 P99。
handler 要快进快出。 别在 handler 里做能异步的事。要发的邮件、要写的日志、要通知的下游,丢给队列就走,让响应路径最短。同步链路每多一环,延迟和失败概率都叠一层。
幂等是必修课。 事件可能重复投递(至少一次语义是主流承诺),函数被同一事件触发两次必须不出错。做法:给每个事件带唯一标识,处理前先查有没有处理过(借外置存储记一笔),或者让操作天然幂等(覆盖写而非累加写)。第 4 章的实践清单里这条会再次出现。
超时和内存别用默认值。 默认内存往往偏低,CPU 配额和内存挂钩,内存给足常常反而更省钱——执行时间缩短的比例超过内存单价的涨幅,这是 FaaS 计费里著名的反直觉优化。超时则要按最坏情况设,宁可设宽也别让函数在半路被掐死。
本节要点回顾
- 函数生命周期:事件到达 → 有热实例则直接调,否则冷启动 → 执行 → 返回 → 空闲后回收归零。
- 无状态是自动伸缩的地基:每个实例独立,平台才能随意加减;状态外置到 BaaS。
- 别在函数内存里缓存跨请求状态,要用外部缓存服务。
- 按需付费 = 调用次数 × 执行时长 × 内存;低频极省,高频要算成本交叉点。
- 同一函数被不同事件源触发,event 结构不同,要按事件源解析。
下一节看 FaaS 依赖的"能力池"——BaaS 提供哪些托管后端服务。
五、冷启动的工程对策全景
冷启动是 FaaS 的标志性代价,工程对策已成体系,给一个全景速览。对策一,预防类:预留实例(付费保活,牺牲成本换延迟)、 provisioned 并发(预热固定并发数,适合已知峰值的场景,如整点活动)。对策二,缓解类:精简依赖包(bundle 优化、裁剪运行时,包体积每减一兆冷启动少几十毫秒)、延迟初始化(非关键资源的初始化挪到首次使用)、选择轻量运行时(解释型语言冷启动普遍优于重型编译链的框架型语言)。对策三,架构类:冷启动敏感的入口用常驻服务兜底(混合架构:常驻网关加函数后端)、高频小请求合并(客户端批量,减少函数唤醒次数)。三类对策的成本与效果各异,选择依据是业务对首字延迟的容忍度——秒级可容忍的内部工具什么都不用做,亚秒要求的线上接口至少要做过缓解类优化,金融与交易类场景直接上预防类。把冷启动当成一个需要持续管理的"技术债指标"(监控它的分位数趋势),而不是一次性解决的问题——平台每代都在改善它,你的对策也要跟着版本重新评估。
补一个执行模型的细节:执行环境的复用是优化机会也是陷阱——平台可能复用温实例处理后续请求(省冷启动),于是"全局变量里的缓存"能工作(初始化的连接可以复用);但复用不保证发生,依赖它的逻辑(每次复用都读到旧值的状态)就是定时炸弹。正确的姿势是"复用当奖励、不依赖当原则":把可复用的资源(数据库连接、配置缓存)放在初始化段,代码逻辑不假设它一定存在——这个心态微调,是 FaaS 开发从入门到可靠的分水岭,也是代码评审里最值得盯的一条。