2.2 后端即服务 BaaS 关键服务
2.2 后端即服务 BaaS 关键服务
本节摘要:FaaS 只解决"计算",而数据库、存储、认证、消息这些后端能力由 BaaS 提供。本节逐类讲清 BaaS 的关键服务、它们各自解决什么问题、怎么和 FaaS 配合,以及选用 BaaS 时的注意事项。
学习目标
阅读完本节,你应当能够:
- 列出 BaaS 的五大类核心服务
- 说出每类服务解决什么问题
- 解释 BaaS 与 FaaS 如何配合
- 知道选用 BaaS 时的取舍(便利 vs 锁定)
一、为什么需要 BaaS
上一节强调过:FaaS 函数是无状态的,所有持久化都得靠外部服务。如果你还得自己搭数据库、自己运维对象存储、自己写认证服务,那 Serverless"免运维"的好处就被抵消了一大半。BaaS 的存在就是为了填这个缺口——把常用的后端能力做成托管的、按需的、和 FaaS 无缝集成的服务,让你既不用运维服务器,也不用运维这些后端组件。
可以说,没有 BaaS,FaaS 就只是个"会跑代码但什么都存不下来"的孤立计算单元;有了 BaaS,才能拼出完整的应用。
二、五大类核心服务
1. Serverless 数据库
最常见的后端需求。分两类:
- NoSQL:DynamoDB、Firestore、CosmosDB。键值或文档型,天然适合弹性、按量计费,和 FaaS 是绝配。
- 关系型(Serverless 模式):Aurora Serverless、SQL Database Serverless。需要事务和复杂查询时用,按使用量自动伸缩。
选型上,FaaS 应用里 NoSQL 更常见,因为它的弹性模型和 FaaS 更契合;需要强一致性事务才上关系型。
2. 对象存储
S3、OSS、COS 这类。存文件、图片、视频、备份、日志。它和 FaaS 有一种天然的协作:用户上传文件到对象存储 → 存储事件触发函数 → 函数处理后再写回存储。上一节的缩略图示例就是这个模式。
3. 认证与授权
Cognito、Firebase Auth、Auth0。管用户注册、登录、Token 签发与校验。认证这种安全敏感、又繁琐、又通用的能力,最适合交给托管服务——自己写认证容易出安全漏洞。
4. 消息队列与事件总线
SQS、Pub/Sub、EventBridge、Event Grid。这是事件驱动架构的血管:
- 消息队列:异步解耦、削峰。函数 A 处理不过来时把任务丢队列,函数 B 按节奏消费。
- 事件总线:跨服务事件分发。一个事件(如"订单创建")可以同时触发多个下游函数。
5. API 网关
API Gateway。把外部的 HTTP 请求路由到对应的 FaaS 函数,兼做鉴权、限流、监控。它是 Serverless 应用对外的门面——客户端只看到一串 HTTP 接口,背后其实是函数。
三、BaaS 与 FaaS 怎么配合
一个典型协作:客户端请求 → API 网关(BaaS)→ 触发函数(FaaS)→ 函数读写数据库/对象存储(BaaS)→ 需要异步就丢消息队列(BaaS)→ 队列触发另一个函数继续处理。
注意:BaaS 服务之间也会互相配合(比如对象存储事件经事件总线分发给函数),不一定都经过函数中转。设计时要画清"谁触发谁、数据怎么流"。
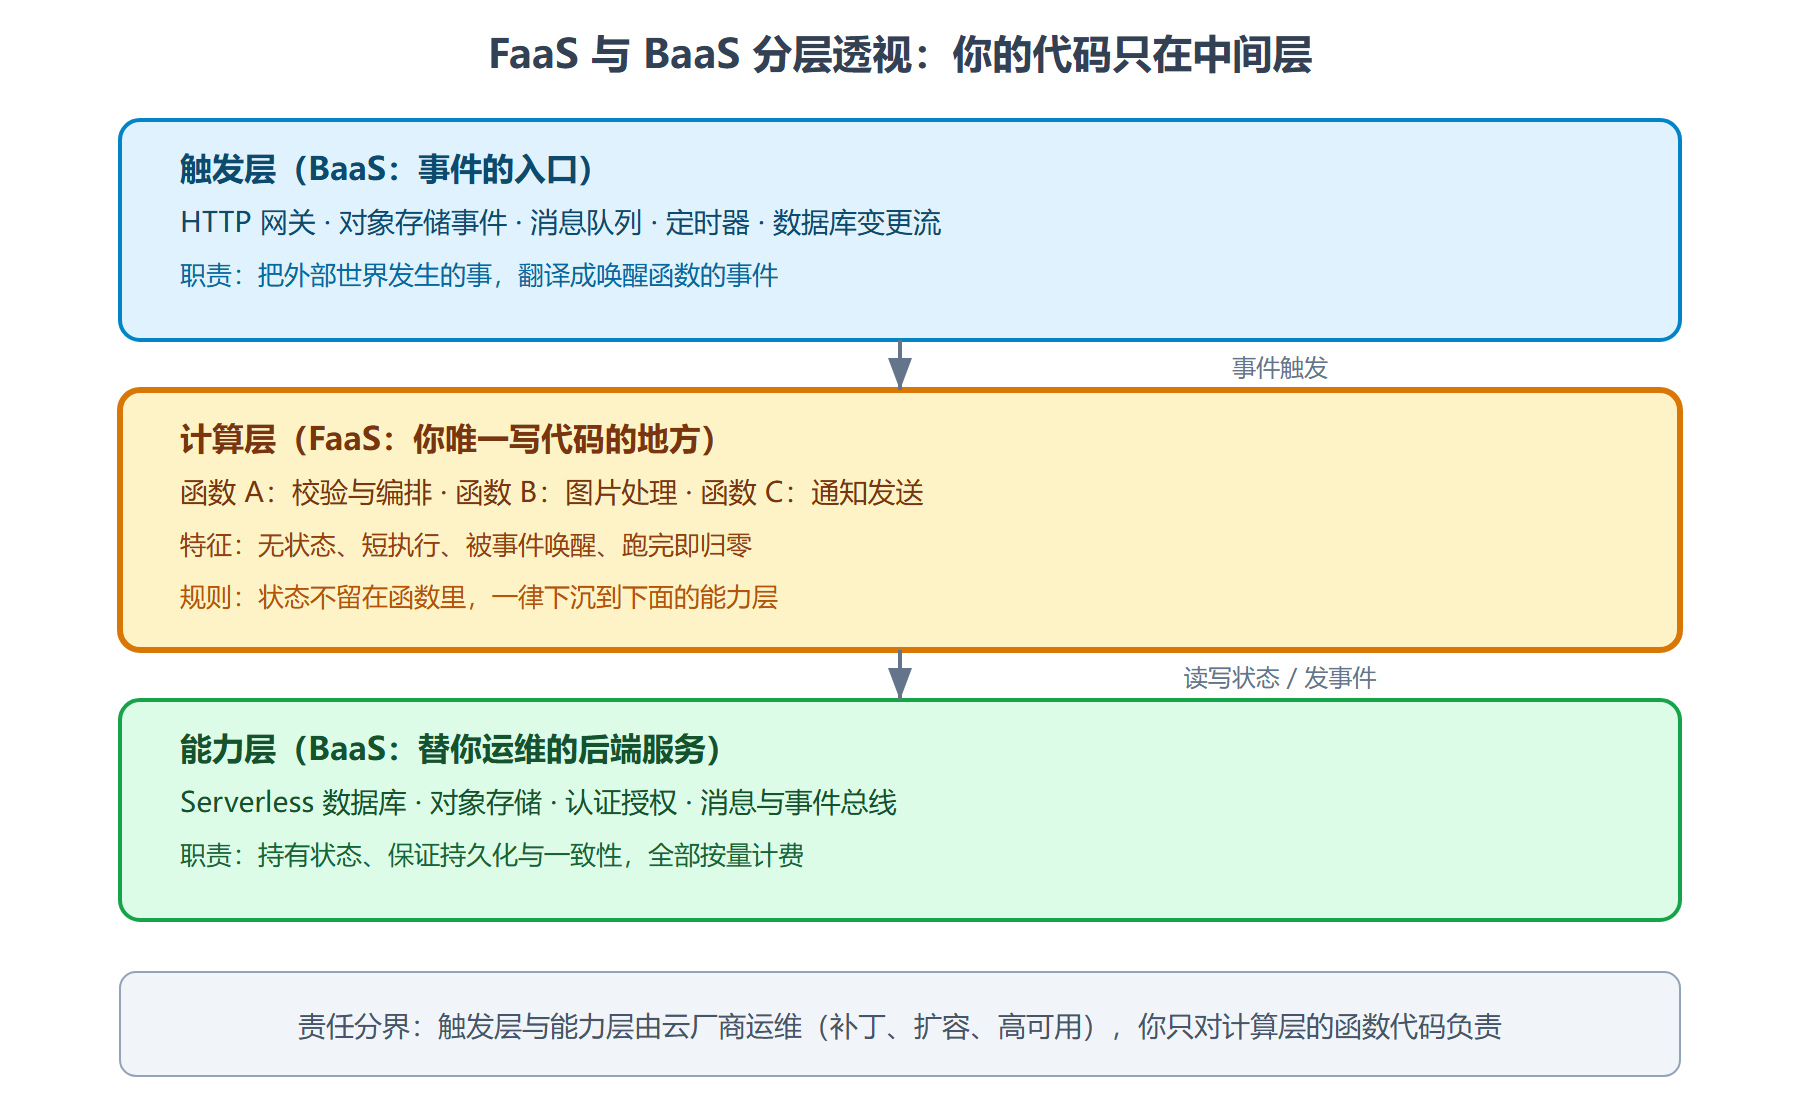
把上面这五类服务放进同一张分层透视图,FaaS 与 BaaS 的分工边界会看得更清楚——你的代码只在中间那一层,上下两层都是买来的:
图:FaaS 与 BaaS 分层透视
四、选用 BaaS 的取舍
BaaS 最大的好处是省心——不用部署、不用备份、不用调优,按量付费。但代价也很明确:
- 厂商锁定加深。每家的 BaaS API 不同,深度用了某家的数据库或认证,迁移时这些调用都要改。FaaS 函数好抽象,BaaS 调用难抽象。
- 可控性降低。数据库的某些高级调优、存储的某些特殊配置,托管服务未必开放。
- 成本拐点。低用量下按量付费很便宜,高用量下可能比自建贵。
💡 实用建议:把 BaaS 调用收敛到一个"数据访问层",而不是散落在函数各处直接调 SDK。这样万一要换厂商或换自建,只改这一个层。代价是多一层封装,但对可维护性和可移植性都值。
⚠️ 别过度依赖专有 BaaS 的独有特性。如果某个功能只有这一家云有,用了就被牢牢绑住。能用通用标准(如兼容 SQL 的数据库、S3 协议的对象存储)就优先通用。
五、一段最小示例:函数读写 BaaS 数据库
感受一下函数怎么调托管的 NoSQL 数据库(伪代码,各家 SDK 不同但模型一致):
def handler(event, context): op = event["operation"] # read 或 write table = get_table("MyTable") # 连接托管数据库 if op == "read": return table.get(id=event["itemId"]) elif op == "write": table.put(id=event["itemId"], data=event["itemData"]) return {"status": "ok"}
函数本身不维护数据库连接池(无状态),每次执行时连一下托管数据库读写——这正是"状态外置"的实践。
六、BaaS 的演化:从"托管旧服务"到"为函数重新设计"
把五大类服务放回时间线,能看到一条清晰的演化轨迹,它解释了为什么"同样是托管数据库,Serverless 数据库不一样"。
第一代托管服务是把现有产品多租户化:你开一个数据库实例,厂商替你运维,但实例是常驻的、按小时计费的——这只是"运维托管",计费模型没变。真正的转折是第二代 Serverless 原生服务:数据库没有"实例"概念了,请求来了平台分配容量,闲时归零,按请求和存储量计费。别小看这个差别,它让整个技术栈的计费模型第一次对齐了——函数零费用时数据库也零费用,"全栈缩放至零"从口号变成现实。演化还在继续:连接管理被前置代理接管(解决函数潮涌建连问题)、数据缓存下沉到服务侧、甚至出现了直接挂在 API 网关边的"数据 API",让简单读写连函数都不用经过。
认证服务的演化同样有戏。它先是作为 SDK 被函数调用,后来升级为网关层的策略——验 Token 发生在函数触发之前,无效请求根本不消耗函数费用。这个"能力从函数下沉到平台"的模式,在限流、缓存、协议转换上一再重演,是判断 BaaS 演化方向的可靠经验法则:凡是标准化程度高的工作,最终都会从你的函数里消失,变成平台配置。
七、选型讨论:三个真实权衡
权衡一:NoSQL 还是关系型? 常见答案是"要事务就关系型",但实践中的判断更细。你的数据访问模式是否基本固定为"按键取值、按键范围查询"?是,NoSQL 便宜且弹性最好,和函数是绝配。查询模式多变、要跨表聚合分析?关系型的灵活查询能省下大量"为适配 NoSQL 而做的数据冗余设计"。一个常被低估的中间态:主数据放关系型,把高频读的热点字段投影成 NoSQL 里的物化视图——多一层同步的复杂度,换来读路径的极致弹性。值不值,取决于读写的比例差距。
权衡二:专有 API 还是兼容标准? 兼容 SQL 或 S3 协议的服务,迁移成本低,但性能和集成度往往不如厂商深度优化的专有服务(专有数据库的事件流、细粒度计费、与函数的零配置集成)。我的建议按业务阶段切:产品验证期用兼容标准的服务保住退路,规模稳定且确认不迁云后,再考虑把性能敏感路径换到专有服务——方向和多数人想的相反,锁定是买来的,不是默认接受的。
权衡三:自建消息系统还是托管队列? 团队若有 Kafka 专家且已有集群在跑,函数直接对接现有集群顺理成成章;从零开始的话,托管队列省下的运维成本几乎总能胜过它的单价溢价。真正的分界线是组织能力而非技术:BaaS 的"贵",买的是你不必拥有那部分专家经验。
⚠️ 一个容易忽略的坑:BaaS 的配额和限流。托管服务都有默认配额(每秒请求数、并发连接数等),函数的弹性伸缩恰恰容易在流量尖峰瞬间撞上这些配额——平时一点事没有,大促时函数扩到几百实例,数据库配额先崩了。上 BaaS 前把它的限流配额抄进设计文档,和函数的并发上限一起规划。
BaaS 要点小结
- 没有 BaaS,FaaS 只是孤立计算;BaaS 提供"能力"让应用完整。
- 五大类:数据库、对象存储、认证、消息队列/事件总线、API 网关。
- 典型协作:网关 → 函数 → 数据库/存储 → 消息队列 → 另一函数。
- BaaS 代价:厂商锁定加深、可控性降低、高用量成本可能更高。
- 把 BaaS 调用收敛到"数据访问层",优先通用标准,缓解锁定。
下一节讲把这些组件粘起来的"胶水"——事件驱动架构。
五、BaaS 选型的四项核查
BaaS 服务把复杂性外包,但外包要核查四件事,缺一件都会在某个深夜兑现。核查一,数据主权:数据的导出能力(格式、完整性)、删除能力(合规删除的真正执行)、迁移路径(换供应商时数据怎么走)——这三条决定你与供应商的关系是"租用"还是"人质"。核查二,配额与限流:每类服务的默认配额、触发限流的行为(拒绝还是排队)、提额的流程与时效——很多"上线即崩"的事故是配额规划缺失,尤其在大促这类自然越限的场景。核查三,一致性语义:托管存储与数据库的一致性模型(强一致还是最终一致、跨区行为的细节文档)——把它与你业务的需求对齐,中间态的模糊选择是最危险的。核查四,可观测接口:服务的指标与日志能否接入你的监控体系、故障时能否拿到足够的诊断信息——黑盒程度直接决定排障时长。四项核查写成选型清单,每引入一个新 BaaS 过一遍——这比任何"十大推荐"文章都更能保护你的项目。BaaS 的自由是"不用自己造",自由的代价是"选之前多看一眼"。
再补一个数据层的专门提醒:函数与数据库的组合里,连接数管理是头号架构问题——函数的弹性扩容会瞬间制造大量并发实例,每个实例都要建数据库连接,传统数据库的连接数上限(几百到几千)很快被击穿。解法是加代理层(连接池收敛:函数短连接进、代理长连接出)或用支持 HTTP 直连的托管数据库服务(无连接数瓶颈);这个问题的存在也解释了为什么"Serverless 友好的数据库"是新硬件品类——它们把连接的弹性做进了服务本身。迁移 Serverless 时数据库侧的这道坎,值得在方案评审里单独立项。
再补一条采购视角:企业级引入 BaaS 时,把四项核查升级为合同附件——数据导出的格式与时限写进 SLA、配额与提额流程写进服务说明、故障时的诊断配合写进支持条款;事前的条款谈判有一周时间窗口,事后的事故协商只有互相埋怨。这条经验的适用范围是所有托管服务——云时代的技术选型,一半是工程,一半是法务。
最后补一个组合使用的陷阱提示:多个 BaaS 组合时,要留意它们的"地域耦合"——函数、存储、消息队列是否同区,跨区组合带来的延迟与流量费会悄悄吃掉架构图上看不出来的预算;组合选型的检查动作是把所有服务的部署区域画在一张图上,跨区的连线每多一条,延迟与账单就多一分——一张图防住一类隐性成本,这是四项核查之外的第五项隐性功课。