8.3 视图:把查询固化成虚拟表
8.3 视图:把查询固化成虚拟表
本节摘要:CREATE VIEW 把一条 SELECT 语句存进数据库,起个名字就成了"虚拟表"——查询时像用普通表一样引用它,每次访问实时执行背后的定义。视图统一口径出口、简化权限、隔离表结构变更;它存的是查询不是数据,代价是每次展开执行。本节讲透视图的边界,再用一个完整案例把"嵌套 → CTE → 视图"的重构走完全程。
一、同一句查询写了二十遍
报表组每天在抄同一段"有效订单"定义:状态是已支付或已完成、金额大于零、创建时间在近一年内。二十处复制粘贴意味着二十处口径漂移——上周有人把"近一年"抄成了"近半年",月报对不上日报。视图把口径收拢成一处:
-- 把有效订单的定义固化成视图 CREATE VIEW v_valid_orders AS SELECT o.id, o.customer_id, o.amount, o.status, o.created_at FROM orders o WHERE o.status IN ('paid', 'shipped', 'completed') AND o.amount > 0 AND o.created_at >= CURDATE() - INTERVAL 1 YEAR;
-- 使用时与普通表无异 SELECT COUNT(*) AS 有效订单数, ROUND(AVG(amount), 2) AS 平均金额 FROM v_valid_orders;
+-----------------+--------------+ | 有效订单数 | 平均金额 | +-----------------+--------------+ | 118 | 156.40 | +-----------------+--------------+
"以后口径要改,只改视图一处"是视图的第一价值。第二个价值是权限隔离:给分析师开 v_valid_orders 的查询权而不开 orders 表,脱敏与过滤由视图定义兜底(配合第 9 章的 GRANT)。第三个价值是接口稳定:底层表重构(拆列、改名)时视图保持外形不变,依赖它的报表与接口不用改。
必须刻在脑子里的边界:视图存查询,不存数据。每次 SELECT v_valid_orders 都实时执行背后的 SELECT,没有任何"快照"。这带来两条推论:其一,视图背后的查询慢,用它就慢——视图不是性能工具(物化视图才是,MySQL 不支持,PostgreSQL 的 MATERIALIZED VIEW 是另一回事);其二,基于视图再建视图的"视图叠视图",层数深了调试与性能双输——团队惯例一般限制两层。
视图能不能更新
简单视图(单表、无聚合、无 DISTINCT、无窗口函数)可以直接 UPDATE/DELETE,改动穿透到基表:
-- 简单视图可更新:改的是基表的数据 UPDATE v_valid_orders SET status = 'completed' WHERE id = 105;
Query OK, 1 row affected -- orders 表 id 105 的 status 已变
带聚合、JOIN、DISTINCT、窗口函数的视图不可更新——"每个分类的平均价"改不成任何一行真实数据,数据库会直接拒绝。工程惯例是不依赖视图写数据:视图定位为读取口径,写入走基表加事务(第 9 章)。
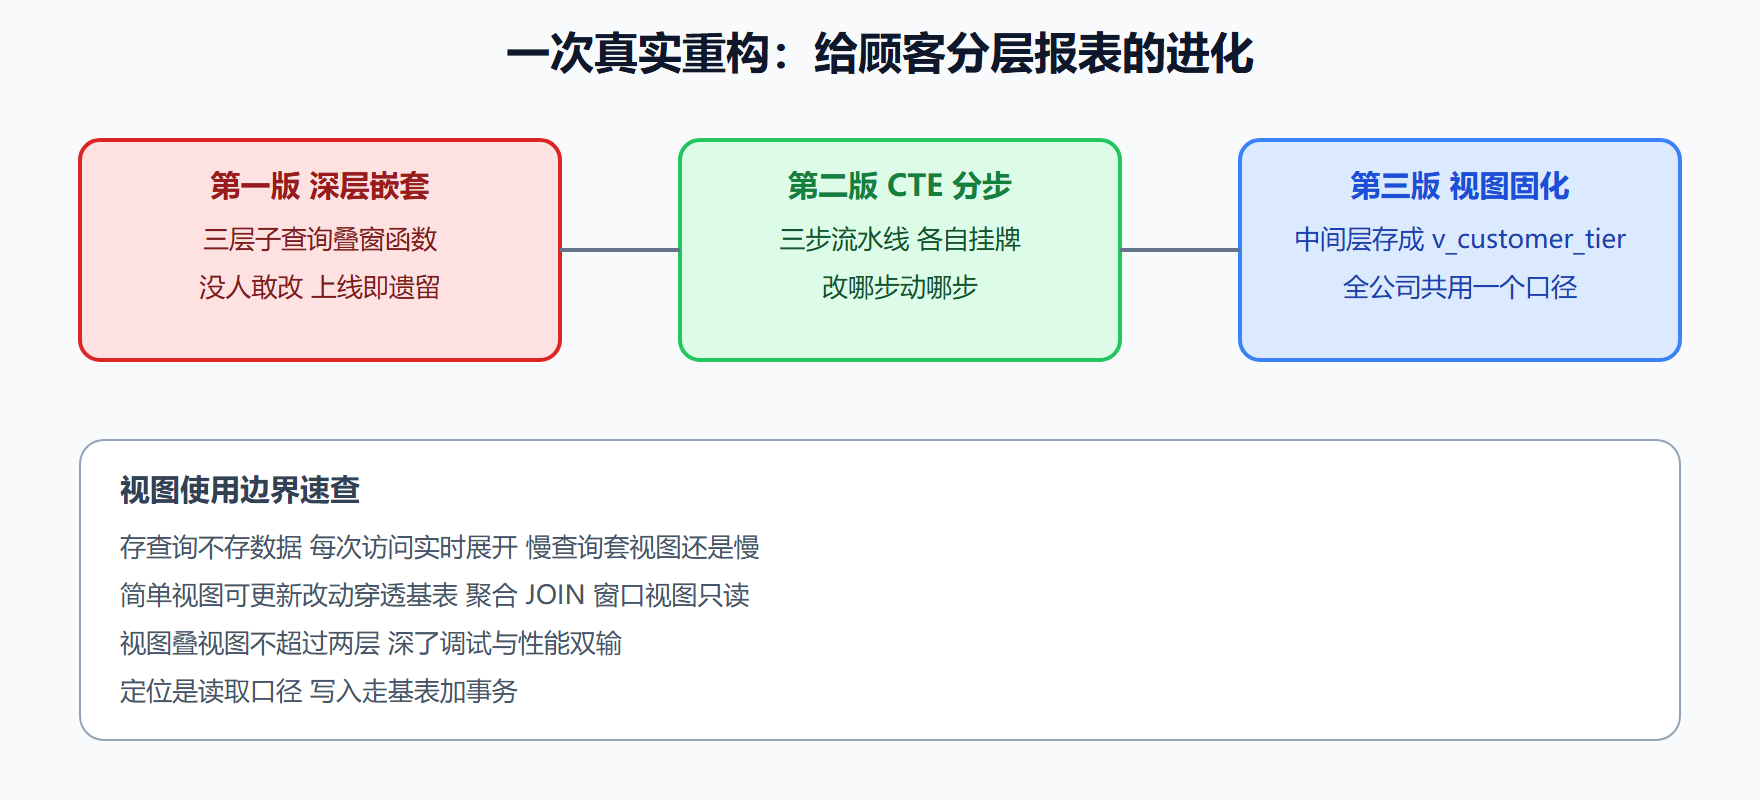
图 8-3 嵌套 → CTE → 视图的重构路线
综合重构实战:顾客分层报表
需求:"给每位顾客算累计消费与订单数,按消费额分四档,只展示前 30% 与后 10%,并标注较上月的名次变化。"第一版(嵌套版)长这样——三层子查询里埋着窗口函数:
-- 第一版节选:窗口函数埋在第三层括号里 SELECT * FROM ( SELECT * FROM ( SELECT customer_id, SUM(amount) AS 消费额, COUNT(*) AS 单数, NTILE(4) OVER (ORDER BY SUM(amount) DESC) AS 分档, RANK() OVER (ORDER BY SUM(amount) DESC) AS 名次 FROM orders GROUP BY customer_id ) t1 WHERE 分档 IN (1, 4) ) t2 WHERE 名次 <= 3 OR 名次 >= 总人数 - 1;
能跑 但三处要改口径时没人愿意接手
第二版用 CTE 拆成三步(第 8.1 节的方法),第三版把最常用的"顾客消费概览"中间层固化为视图:
-- 第三版:中间层固化为视图 一次定义处处复用 CREATE VIEW v_customer_spend AS SELECT customer_id, SUM(amount) AS 消费额, COUNT(*) AS 单数, MIN(created_at) AS 首单时间, MAX(created_at) AS 最近一单 FROM orders GROUP BY customer_id;
-- 报表查询只剩"业务表达":分层与展示 WITH ranked AS ( SELECT c.name, vs.消费额, vs.单数, NTILE(4) OVER (ORDER BY vs.消费额 DESC) AS 消费四档, RANK() OVER (ORDER BY vs.消费额 DESC) AS 名次 FROM v_customer_spend vs JOIN customers c ON c.id = vs.customer_id ) SELECT name, 消费额, 单数, 消费四档, 名次 FROM ranked WHERE 消费四档 = 1 OR 名次 = ( SELECT MAX(名次) FROM ranked );
+--------+--------------+--------+--------------+--------+ | name | 消费额 | 单数 | 消费四档 | 名次 | +--------+--------------+--------+--------------+--------+ | 陈晓 | 866.00 | 3 | 1 | 1 | | 吴岚 | 88.00 | 1 | 4 | 4 | +--------+--------------+--------+--------------+--------+
重构后的分工:视图管"顾客消费概览"这个稳定口径(别的报表也能用),CTE 管"本次报表的临时分层",主查询只剩业务表达。NTILE(4) 顺手认识一下:把行切成四份编号,分档专用;名次变化标注则需要 7.3 节的 LAG——把本月名次与上月名次(每月各算一次 RANK 存档后 LAG)相减,全部武器都是已学的。
⚠️ 常见坑:把视图当性能优化——"建个视图是不是就快了"是最常见的误会,视图零缓存零加速,慢查询套上视图依然慢,提速要靠第 10 章的索引与执行计划。另一个坑是视图改名后依赖它的报表集体报错,改名前先查依赖(多数库提供依赖视图清单),分批切换。
💡 关键直觉:视图是"给口径立法"——一个定义、一个名字、处处引用。当代码里第二次出现同一段子查询时,就该考虑把它升格成 CTE;当第二个同事要抄这段查询时,就该升格成视图。
本节要点回顾
- 视图存查询不存数据:每次访问实时展开,性能取决于背后那条 SELECT;
- 三大价值:口径统一(改一处全局生效)、权限隔离(开视图不开表)、接口稳定(底层重构视图保形);
- 可更新性有边界:单表简单视图可更新且穿透基表,聚合、JOIN、窗口视图只读,写入走基表;
- 视图叠视图限两层,深嵌套调试与性能双输;
- 重构三步走:嵌套拆成 CTE 分步,稳定中间层固化为视图,主查询只留业务表达;
- NTILE 切档、LAG 算名次变化:与第 7 章武器组合,报表需求逐个击破。
查询主线登顶完毕。第 9 章转入守护篇:事务让一批改动同生共死,权限管住每双手,存储过程把规则搬进数据库。