8.2 递归 CTE:分类树与祖先链一次查完
8.2 递归 CTE:分类树与祖先链一次查完
本节摘要:递归 CTE 由"锚(起点)+ 递归项(引用自己)+ 终止条件(递归项不再产出新行)"三段构成,专门处理自指结构——分类树、组织架构、评论楼层。它能向下展开整棵子树,也能向上追溯祖先链,还能生成连续日期序列补齐报表空档。环状数据会让递归失控,加深度上限是最便宜的自保。
一、分类树怎么一次查完
第 5 章的自连接只能展开一层父子:"数据库"的父分类是"计算机",到此为止。想问"计算机大类的所有后代分类(含孙子辈、重孙辈)",一层的连接无能为力——层数未知,写多少层 JOIN 都赌不住。递归 CTE 让查询"自己调用自己":
-- 递归 CTE:从 计算机 出发 找出全部后代 WITH RECURSIVE subtree AS ( -- 锚:起点行 SELECT id, name, parent_id, 0 AS depth FROM categories WHERE name = '计算机' UNION ALL -- 递归项:引用 subtree 自己 沿 parent_id 往下找一层 SELECT c.id, c.name, c.parent_id, s.depth + 1 FROM categories c JOIN subtree s ON c.parent_id = s.id ) SELECT * FROM subtree ORDER BY depth, id;
+------+--------------+-----------+-------+ | id | name | parent_id | depth | +------+--------------+-----------+-------+ | 1 | 计算机 | NULL | 0 | | 2 | 数据库 | 1 | 1 | | 3 | 算法 | 1 | 1 | | 6 | MySQL | 2 | 2 | | 7 | 索引技术 | 2 | 2 | +------+--------------+-----------+-------+
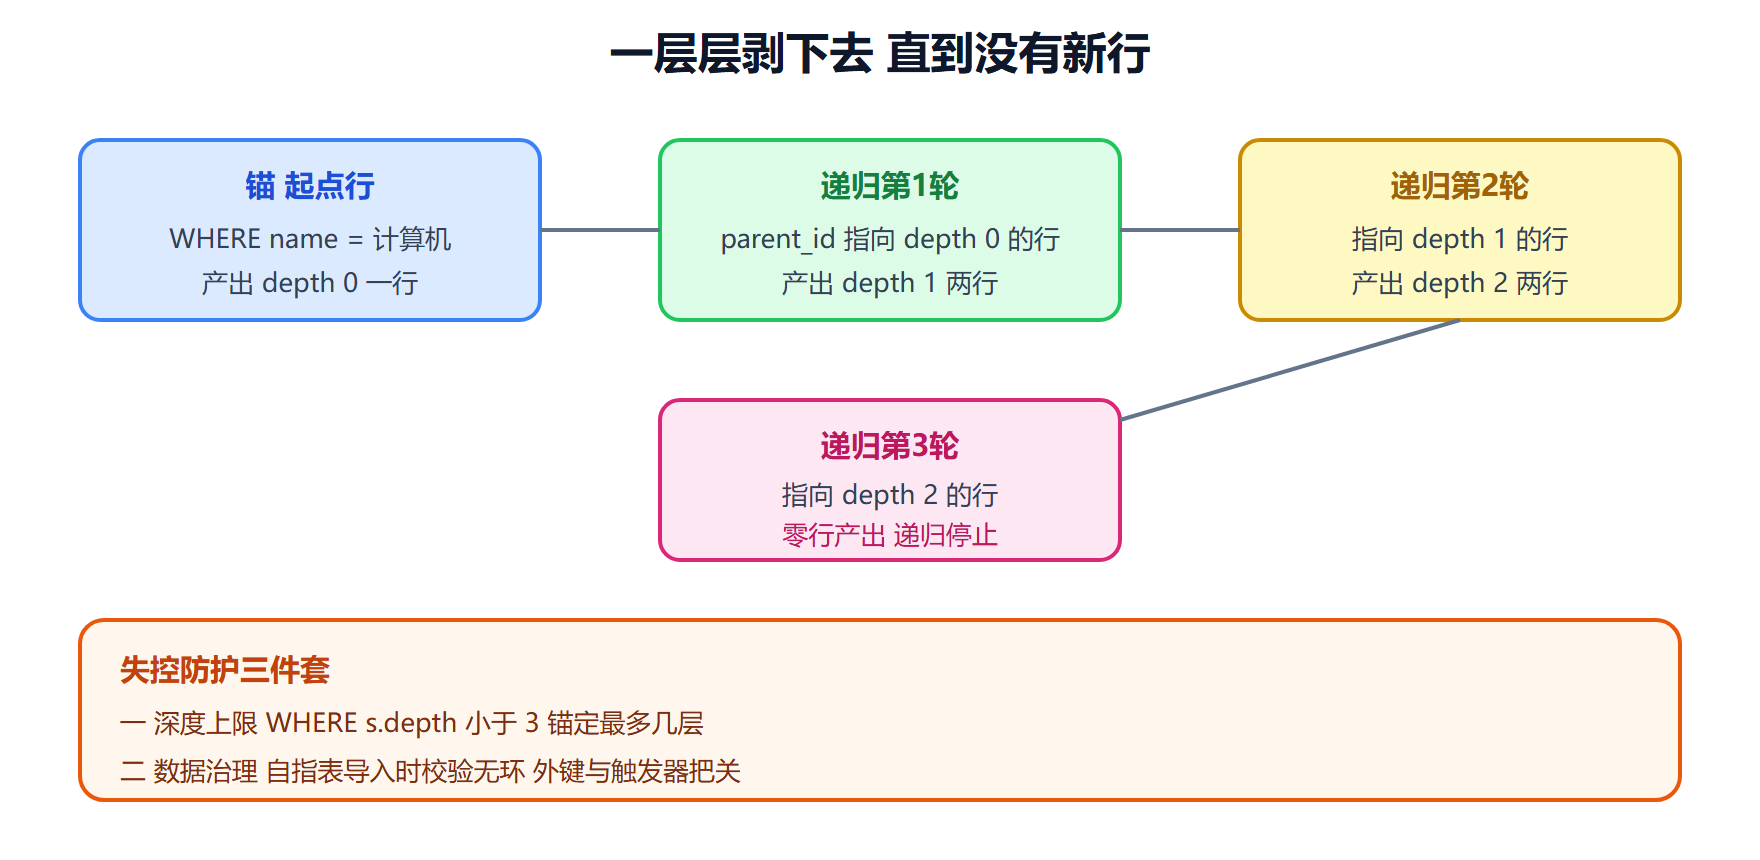
执行机制像剥洋葱:锚先跑,得到第 0 层("计算机"自己);递归项跑第一轮,拿锚的结果去 categories 里找 parent_id 指向它们的行,得到第 1 层;再跑一轮,拿第 1 层的结果找第 2 层……直到某一轮不再产出新行,递归自然停止。depth 列是手工维护的层级计数器,递归项里 s.depth + 1,输出的排序与可视化全靠它。
三个结构要点。其一,MySQL 写 WITH RECURSIVE,PostgreSQL 同样(标准 SQL 的 RECURSIVE 关键字);其二,两段之间是 UNION ALL——逐层追加不去重,效率高;其三,"终止条件"不是显式写的,而是"递归项产出空集"这个自然事实——正因如此才有失控风险,下文细说。
方向反转:从叶子向上追祖先链
把连接条件反过来就是"向上爬":从"MySQL"出发,parents 是谁、祖父是谁、直到顶层。顺手的实战包装——面包屑导航(首页 / 计算机 / 数据库 / MySQL):
-- 反向递归:从当前分类向上追到根 WITH RECURSIVE breadcrumb AS ( SELECT id, name, parent_id, 0 AS depth FROM categories WHERE name = 'MySQL' UNION ALL SELECT c.id, c.name, c.parent_id, b.depth + 1 FROM categories c JOIN breadcrumb b ON c.id = b.parent_id -- 反过来:找我的父 ) SELECT GROUP_CONCAT(name ORDER BY depth DESC SEPARATOR ' / ') AS 面包屑 FROM breadcrumb;
+-----------------------------+ | 面包屑 | +-----------------------------+ | 计算机 / 数据库 / MySQL | +-----------------------------+
GROUP_CONCAT(PostgreSQL 用 STRING_AGG)把几行名字按层级倒序拼成一个字符串——电商与内容系统的导航栏就这样一条查询出炉。向上递归还有一个妙用:按叶子汇总到祖先。把订单金额沿着 parent_id 逐层上卷,每个大类目都能看到自己的间接销售贡献,星型模型的"上卷"本质就是这pattern。
图 8-2 递归 CTE 的执行画面
两个扩展场景:日期序列与逐层上卷
场景一:生成连续日期序列补零。 报表的经典尴尬:销售表只有下单日期,6 月 3 日没单,那天就从图上消失——趋势图出现"断崖",其实是数据缺席不是销量归零。递归 CTE 生成连续日期,再 LEFT JOIN 事实表:
-- 生成 6 月 1 到 30 日的连续日期 并补零 WITH RECURSIVE days AS ( SELECT DATE '2026-06-01' AS day -- 锚:第一天 UNION ALL SELECT day + INTERVAL 1 DAY FROM days -- 递归:加一天 WHERE day < DATE '2026-06-30' -- 终止护栏:到月底为止 ) SELECT d.day, COALESCE(SUM(o.amount), 0) AS 当日销售额 FROM days d LEFT JOIN orders o ON DATE(o.created_at) = d.day GROUP BY d.day ORDER BY d.day;
+------------+-----------------+ | day | 当日销售额 | +------------+-----------------+ | 2026-06-01 | 280.00 | | 2026-06-02 | 0.00 | ← 补出来的零 断崖消失 | 2026-06-03 | 415.00 | +------------+-----------------+ (后续日期类推)
注意这个递归项不 JOIN 任何表——它从自己身上生成新行(day 加一天),WHERE 充当终止护栏。这是递归 CTE 的第二种形态:数据生成器。COALESCE 把没单的 NULL 补成 0,第 3 章的工具在此收口。
场景二:失控与防护。 若脏数据造成环——A 的父是 B、B 的父是 A——向下递归每一轮都"有新行"(其实是一对行无限循环),数据库会递归到超过上限(MySQL 默认 1000 层)后报错。两道防线:数据侧,导入自指数据时校验无环(应用层做一次祖先检测);查询侧,递归项加深度条件 WHERE s.depth < 10,宁可截断也不失控。生产环境写递归查询,深度护栏应当像第 2 章 UPDATE 前的 SELECT 预演一样成为肌肉记忆。
⚠️ 常见坑:递归项里误用 UNION(带去重)——每一轮都要排序去重,性能塌方且语义混乱;以及锚里忘了 WHERE 过滤(比如忘了限定起点),把全表当 depth 0,输出成倍膨胀。递归查询写完先 LIMIT 20 看一眼前几轮的产出,再放全量。
💡 关键直觉:递归 CTE 是"队列式广度优先":锚是首批入队元素,每轮把"它们的孩子"排进队尾,直到某轮队伍不再增长。写之前在纸上画前两轮的产出,绝大多数错误都会在纸上现形。
本节要点回顾
- 三段结构:锚定起点、递归项引用自己、空产出即终止,depth 列记录层级;
- UNION ALL 是标配:逐层追加不去重,UNION 的去重既慢又常错语义;
- 向下展开换连接方向即向上追祖先:面包屑导航一条查询出炉;
- 数据生成器形态:不 JOIN 表、自增日期,配 LEFT JOIN 与 COALESCE 补零报表;
- 失控两道防线:导入校验无环,递归项加深度上限护栏;
- 调试习惯:LIMIT 看前几轮产出,画前两轮再写 SQL。