8.1 CTE 基础:WITH 子句给子查询起名字
8.1 CTE 基础:WITH 子句给子查询起名字
本节摘要:WITH 子句把子查询定义为命名的临时结果集(CTE),主查询按名字引用。多个 CTE 逗号分隔、链式引用,复杂逻辑拆成分步流水线;作用域仅限当前语句,跑完即散。CTE 与派生表能力等价,赢在可读、可复用、可测试——它换来的是组织能力,不是新功能。
一、四层嵌套的查询没人敢改
先看一段"能跑但没人敢动"的查询:算"每个分类的销售额占全店比重,只看高于全店平均分类额的分类"。用第 6 章的派生表写法:
-- 派生表版:三层嵌套 括号配平靠运气 SELECT t.category_id, t.销售额, ROUND(t.销售额 / grand.total * 100, 1) AS 占比 FROM ( SELECT category_id, SUM(amount) AS 销售额 FROM order_items oi JOIN books b ON b.id = oi.book_id GROUP BY category_id ) t JOIN ( SELECT SUM(销售额) AS total FROM ( SELECT SUM(amount) AS 销售额 FROM order_items oi JOIN books b ON b.id = oi.book_id GROUP BY category_id ) x ) grand ON 1 = 1 WHERE t.销售额 > (SELECT AVG(销售额) FROM ( SELECT SUM(amount) AS 销售额 FROM order_items oi JOIN books b ON b.id = oi.book_id GROUP BY category_id ) y);
能执行 但同一段子查询抄了三遍 读到 WHERE 时栈已经深了 半年后没人敢改 口径一动三处要同步漏一处就错
痛点清单:同一段逻辑重复三遍;括号层级四位深;每层都要起临时别名。CTE 版把每一步命名挂牌:
-- CTE 版:三步流水线 每步有名字 WITH cat_sales AS ( -- 第一步:每分类销售额 SELECT b.category_id, SUM(oi.amount) AS 销售额 FROM order_items oi JOIN books b ON b.id = oi.book_id GROUP BY b.category_id ), grand_total AS ( -- 第二步:引用上一步 算全店总额与均值 SELECT SUM(销售额) AS total, AVG(销售额) AS avg_cat FROM cat_sales ) SELECT -- 第三步:主查询 只管组装 cs.category_id, cs.销售额, ROUND(cs.销售额 / gt.total * 100, 1) AS 占比百分比 FROM cat_sales cs CROSS JOIN grand_total gt WHERE cs.销售额 > gt.avg_cat;
+-------------+--------------+-----------------+ | category_id | 销售额 | 占比百分比 | +-------------+--------------+-----------------+ | 3 | 362.00 | 55.7 | | 2 | 211.00 | 32.5 | +-------------+--------------+-----------------+
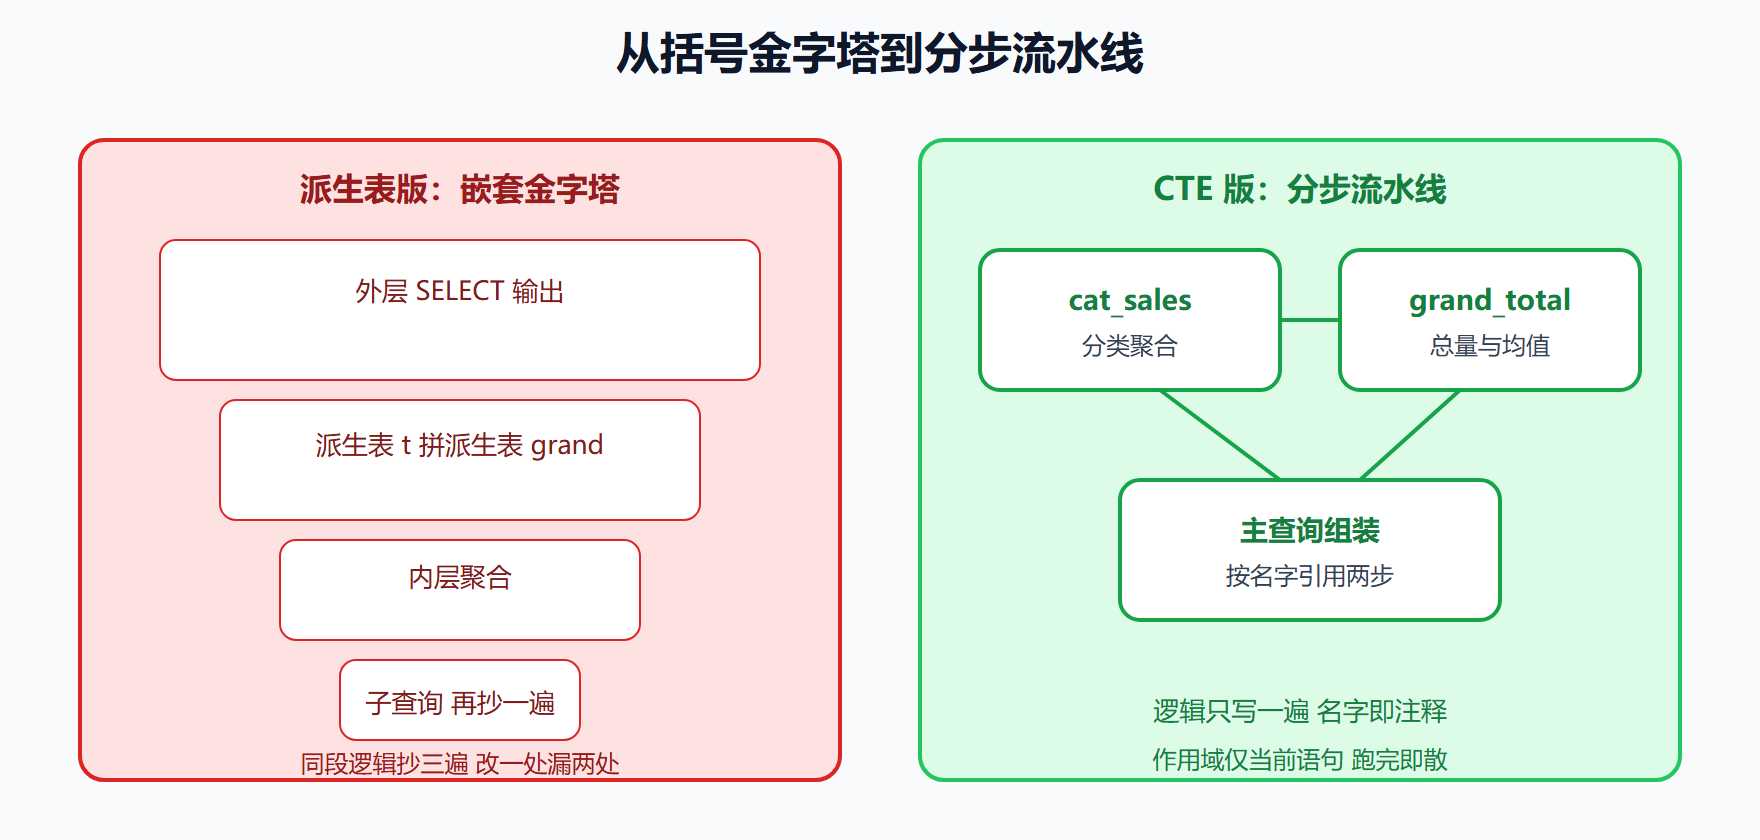
结构一眼见底:cat_sales 算分类销售额,grand_total 基于它算总量与均值,主查询组装输出。三个可维护性收益落地:重复消除(分类聚合只写一遍);自文档(名字即注释,cat_sales 不需要额外解释);依赖显式(grand_total FROM cat_sales,数据流向写在明面上)。
语法规则与作用域
三个规则配三个实验。规则一,多个 CTE 逗号分隔,写在 WITH 后、主查询前,后定义的可以引用先定义的(链式),反之报错。规则二,CTE 作用域仅限当前语句——WITH 定义的 cat_sales 在下一条语句里不存在,跑完即散,这既是限制也是优点(不污染会话)。规则三,一次定义多处引用,派生表做不到这一点(要用就得再抄一遍):
-- 一次定义 两处引用:WHERE 与 SELECT 各用一次 avg_cat WITH order_stats AS ( SELECT customer_id, COUNT(*) AS 单数, SUM(amount) AS 消费额 FROM orders GROUP BY customer_id ) SELECT c.name, os.单数, ROUND(os.消费额 / (SELECT AVG(消费额) FROM order_stats), 2) AS 相对均值 FROM customers c JOIN order_stats os ON os.customer_id = c.id;
+--------+--------+--------------+ | name | 单数 | 相对均值 | +--------+--------+--------------+ | 陈晓 | 3 | 1.42 | | 林川 | 2 | 0.79 | +--------+--------+--------------+
图 8-1 嵌套版与 CTE 版的结构对照
CTE、派生表、视图:三个容器的分工
三种"命名一段查询"的手段放在一张表里,边界立刻清楚:
| 维度 | 派生表 | CTE | 视图 |
|---|---|---|---|
| 定义位置 | FROM 里内联 | 语句开头 WITH | 数据库对象,独立保存 |
| 作用域 | 当前的这一处 | 当前整条语句 | 永久,直到 DROP |
| 复用 | 不能,要抄 | 语句内多次引用 | 任何语句随时引用 |
| 适合 | 一步即弃的小加工 | 多步流水线 | 高频复用的口径 |
选择口诀:一次性的小活儿派生表,一条语句内的流水线 CTE,跨语句跨系统共用的口径上视图。三者可以组合——视图里写 CTE,CTE 引用视图,都是合法且常见的。
再补一个性能认知:MySQL 8.0 早期版本对"CTE 只引用一次"的场景会直接内联展开(与派生表同计划),引用多次时可能物化一次复用——写法的选择主要看可读性,性能差异交给第 10 章的执行计划去核实,而不是凭感觉优化。PostgreSQL 12 起同样智能内联。先把查询写清楚,再谈快——这也是全书的一贯立场。
⚠️ 常见坑:CTE 名字与真实表重名——语句内 CTE 会遮蔽同名的表,查出来的数据"看起来不对"实则查错了源;以及 WITH 后面的逗号漏写(每个 CTE 之间必须逗号,最后一个不带),报语法错还不好定位。命名上加领域前缀(cat_sales 而非 sales)能同时避开两个坑。
💡 关键直觉:把 CTE 当白板上的演算步骤——先算分类额、再算总盘、最后拼结论,每步挂牌。代码评审时别人读的是你挂牌的顺序,而不是替你数括号。
本节要点回顾
- WITH 给子查询起名:主查询按名字引用,重复消除、自文档、依赖显式三个收益立现;
- 多 CTE 逗号分隔、链式引用:后定义可用先定义,顺序即数据流;
- 作用域仅当前语句:一次定义多处引用是它对派生表的独有优势;
- 三容器分工:内联派生表、语句级 CTE、永久视图,按复用半径选型;
- 性能交给执行计划核实:CTE 与派生表在多数库中等价内联,别凭感觉优化;
- 命名避开真实表名:加领域前缀,防遮蔽、防混淆。
命名的问题解决了,自指的结构还没法处理——分类树要一层层往下找,普通 CTE 力不从心。下一节让 CTE 引用它自己:递归登场。