5.1 为什么拆表:范式与 ER 模型
5.1 为什么拆表:范式与 ER 模型
本节摘要:把所有信息塞进一张大宽表,会带来更新异常、插入异常与删除异常三类维护灾难。范式理论给出拆表的路线图:第一范式原子化,第二范式消除部分依赖,第三范式消除传递依赖。ER 模型则是设计期的通用语言,实体、属性、联系三要素直接映射到表、列、外键。本节从一张事故宽表出发走完这条设计路线。
一、一张越来越宽的订单表
假设图省事,把书店所有信息塞进一张表 orders_flat:订单号、下单时间、顾客昵称、顾客城市、书名、分类名、单价、数量。跑起来"也能用",直到三件事接连发生。
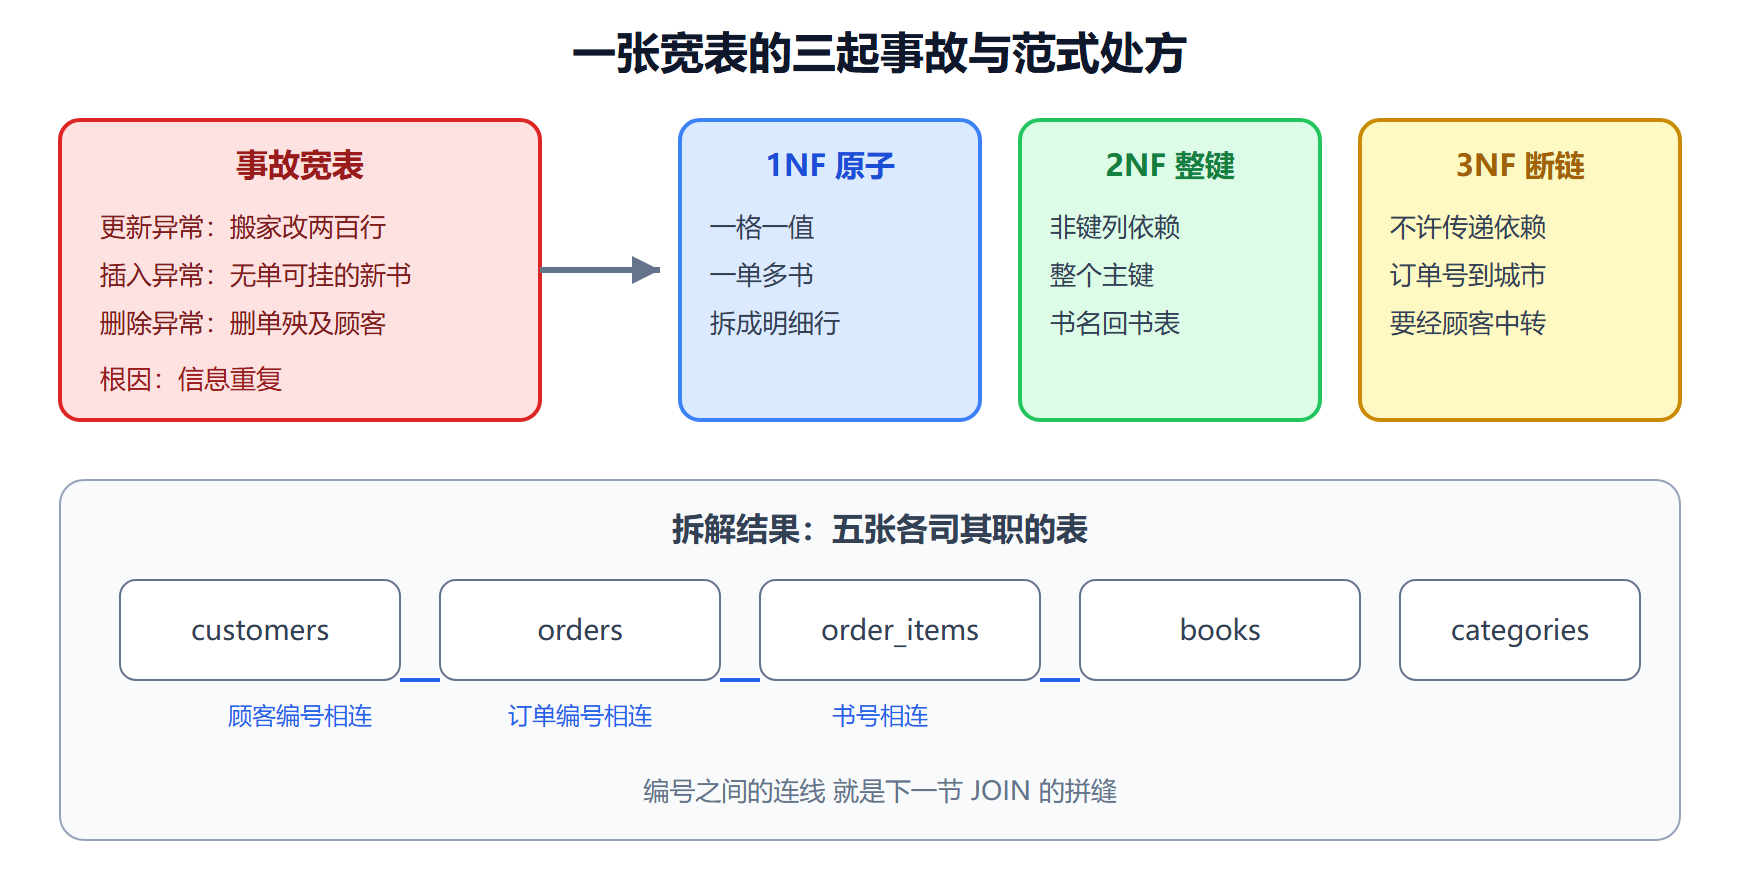
事故一(更新异常):顾客"陈晓"搬家了。她在历史上有两百个订单,两百行的顾客城市列全要改——漏改一行,数据库里同一个顾客就有了两个城市,哪个是真的?
事故二(插入异常):新书《编译原理》还没卖出过一单。没有订单号、没有顾客,这本书的信息在 orders_flat 里无处安放——主键订单号还不存在,书的信息跟着挂不上。
事故三(删除异常):一位顾客要求清除全部订单。删完最后一行,这位顾客的昵称、城市、会员等级也随之蒸发——我们只是不想留订单,从没想销毁顾客。
三类异常的共同根源是信息重复:顾客信息按订单次数重复,图书信息按成交次数重复。重复不仅浪费空间,更要命的是制造了"多份副本不一致"的机会。拆表的处方:一个实体一张表,重复的信息只存一份,别处用编号引用——顾客进 customers,书进 books,订单只留订单号、顾客编号、下单时间。拆完之后:搬家改一行;新书插 books 与订单无关;删订单动不了顾客。三类异常一次根除。
范式:拆表的度量衡
范式是"拆得多干净"的等级标准。日常工程到第三范式(3NF)足够,三级递进如下。
第一范式(1NF):列不可再分。 每个格子只放一个原子值。"买了三本书"若挤在一个 orders 列里写成"算法导论,2,计算机网络,1",SQL 就失去了按书统计的能力——要么拆列,要么拆行。反例与正解:
-- 反 1NF:一列塞多本书,无法按书聚合 CREATE TABLE bad_orders ( order_no INT, customer VARCHAR(50), books VARCHAR(500) -- '算法导论x2,计算机网络x1' 挤在一起 ); -- 合 1NF:一单多书拆成多行,进入明细表 CREATE TABLE order_items ( order_id INT UNSIGNED, book_id INT UNSIGNED, quantity INT UNSIGNED );
两条 DDL 都能建表成功;差别在查询能力: bad_orders 永远答不出"算法导论卖了几本"(除非字符串拆列) order_items 一句 GROUP BY 就能回答
第二范式(2NF):消除部分依赖。 在"订单号 + 书号"做复合主键的明细表里,若存了书名列,则书名只依赖书号(主键的一半)——主键变动一半,书名就得跟着重复。解法:书名回 books,明细表只留两个外键加数量。
第三范式(3NF):消除传递依赖。 orders 里存了顾客城市?城市依赖顾客,顾客依赖订单号——传递链"订单号 → 顾客 → 城市"成立。城市应随顾客进 customers,orders 只留顾客编号。
三级范式的口诀:1NF 原子、2NF 看主键整体、3NF 断传递链。也要知道反面:范式不是越高越好。报表查询常常需要"适度的宽",把常用维度冗余进汇总层(数仓的宽表实践)是性能与规范的折中——存储层守范式、查询层造宽表,是工程上的标准分工。
图 5-1 从宽表事故到范式拆解
ER 模型:设计期的通用语言
范式告诉你"拆到什么程度",ER 模型告诉你"拿什么拆、怎么画"。三要素与数据库概念的映射:实体(顾客、图书)映射为表;属性(昵称、价格)映射为列;联系(顾客下单、图书归类)映射为外键。
联系的"基数"决定外键方向,规则只有一条:外键永远放在"多"的一方。一个顾客有多个订单,"多"的是订单,所以 orders 表里放 customer_id。反过来想给 customers 塞一列订单号根本塞不下——一对多的"一"容纳不了多个引用。三条示例库的业务描述翻译如下:
-- 联系一:顾客 1 对多 订单 → 外键在订单 ALTER TABLE orders ADD CONSTRAINT fk_order_customer FOREIGN KEY (customer_id) REFERENCES customers(id); -- 联系二:订单 1 对多 明细 → 外键在明细 ALTER TABLE order_items ADD CONSTRAINT fk_item_order FOREIGN KEY (order_id) REFERENCES orders(id); -- 联系三:分类 1 对多 图书 → 外键在图书 ALTER TABLE books ADD CONSTRAINT fk_book_cat2 FOREIGN KEY (category_id) REFERENCES categories(id);
三条约束创建成功;此后 orders 里插一个不存在的顾客编号、 books 里插一个不存在的分类号,都会被数据库以 1452 错误当场拒绝
两个特殊的联系形态顺带记下。多对多(订单与图书:一个订单含多本书,一本书出现在多个订单)不能直接放外键,解法是插入联结表 order_items,把多对多拆成两个一对多——这正是它存在于示例库里的原因。自指联系(分类的父分类还是分类、员工的上级还是员工)外键指向本表,categories.parent_id 指回 categories.id;自指联系是第 8 章递归 CTE 的主演。
设计流程收拢成四步:列出业务陈述里的名词当实体候选、动词当联系候选;按基数决定外键方向;按范式检查每张表有没有异常苗头;用 ER 图评审后再落 DDL。图画在白板上,坑就留在纸面上。
⚠️ 常见坑:把"一对多"的外键放反,或者为了省一次 JOIN 把高频维度冗余进订单表。前者结构错误,后者是刻意的反范式——反范式可以是性能优化,但必须是有意识的、可回滚的决定,而不是没学过范式的随缘。
💡 关键直觉:范式是"每件事只在唯一的地方说一遍"。违反它的代价不是空间,而是"同一件事的多份说法彼此打架"——那时你修的不是数据,是信任。
本节要点回顾
- 三类异常定罪宽表:更新异常、插入异常、删除异常,根因都是信息重复;
- 三级范式递进:1NF 列原子化、2NF 非键列依赖完整主键、3NF 消除传递依赖,工程到 3NF 足够;
- 存储层守范式,查询层造宽表:反范式冗余是有意识的性能取舍,不是偷懒的借口;
- ER 三要素映射表、列、外键;外键永远放"多"的一方;
- 多对多拆联结表(order_items),自指联系(分类树、汇报线)外键指向本表;
- 拆出来的编号连线就是 JOIN 的拼缝——下一节正式学拼。