5.2 四类 JOIN:内连接、外连接与选型
5.2 四类 JOIN:内连接、外连接与选型
本节摘要:JOIN 按"保留哪些行"分为四类——INNER 只留两边都匹配的行,LEFT 保住左表全部,RIGHT 保住右表全部,FULL 两边都保。无匹配的一侧填 NULL,这个 NULL 是判断"漏了什么"的信号弹。选型的唯一准绳是业务问题问的是"交集"还是"全集",本节用一张文氏图与三组会话把四类连接一次配齐。
用两张小表还原一张大表
拆表之后,"每个分类有哪些书"这类问题要先拼表。拼图的卡口是键:books.category_id 与 categories.id。最小可用的连接是 INNER JOIN:
-- 内连接:只保留两边都能配上对的行 SELECT c.name AS 分类, b.title AS 书名, b.price AS 价格 FROM books b INNER JOIN categories c ON b.category_id = c.id;
+--------------+-----------------------+--------+ | 分类 | 书名 | 价格 | +--------------+-----------------------+--------+ | 数据库 | 数据库系统概念 | 89.00 | | 数据库 | SQL必知必会 | 52.00 | | 算法 | 算法导论 | 128.00 | | 算法 | 计算机网络 | 79.00 | +--------------+-----------------------+--------+ 4 rows in set (0.01 sec)
读这条语句的三个要点。第一,别名:books 起名 b、categories 起名 c,此后列名都要带前缀(b.title、c.name)——两表一旦有同名列(都有 id),不带前缀会直接报"列不唯一"。第二,ON 是卡口:b.category_id = c.id 声明"这一列相等才算配上对",连接条件几乎总是主外键相等,但不限于它。第三,驱动顺序:FROM 后面先写的表可读性上当"主线",实际执行顺序由优化器决定(第 10 章展开)。
输出里没有"文学"分类——示例库里它是空分类,没有任何书指向它。内连接把它静默丢弃,而"找出没人买的分类"恰恰是运营常问的问题。这就轮到外连接登场。
外连接:保住一边的全集
LEFT JOIN 把左表的行全部保留,右表配不上的列填 NULL:
-- 左外连接:分类全保留,没书的分类列显示 NULL SELECT c.name AS 分类, b.title AS 书名 FROM categories c LEFT JOIN books b ON b.category_id = c.id;
+--------------+-----------------------+ | 分类 | 书名 | +--------------+-----------------------+ | 数据库 | 数据库系统概念 | | 数据库 | SQL必知必会 | | 算法 | 算法导论 | | 算法 | 计算机网络 | | 文学 | NULL | +--------------+-----------------------+
"文学"一行出现了,书名为 NULL。这个 NULL 不是数据里的空值,而是连接动作亲手填上的"无匹配"标记。于是有一个高频到几乎成为套路的模式——用 LEFT JOIN 加 IS NULL 找"落单者":
-- 反连接套路:找没有书的分类(同样套路可找"没下过单的顾客") SELECT c.name AS 分类 FROM categories c LEFT JOIN books b ON b.category_id = c.id WHERE b.id IS NULL; -- 右表键为空 = 一个都没配上
+--------------+ | 分类 | +--------------+ | 文学 | +--------------+
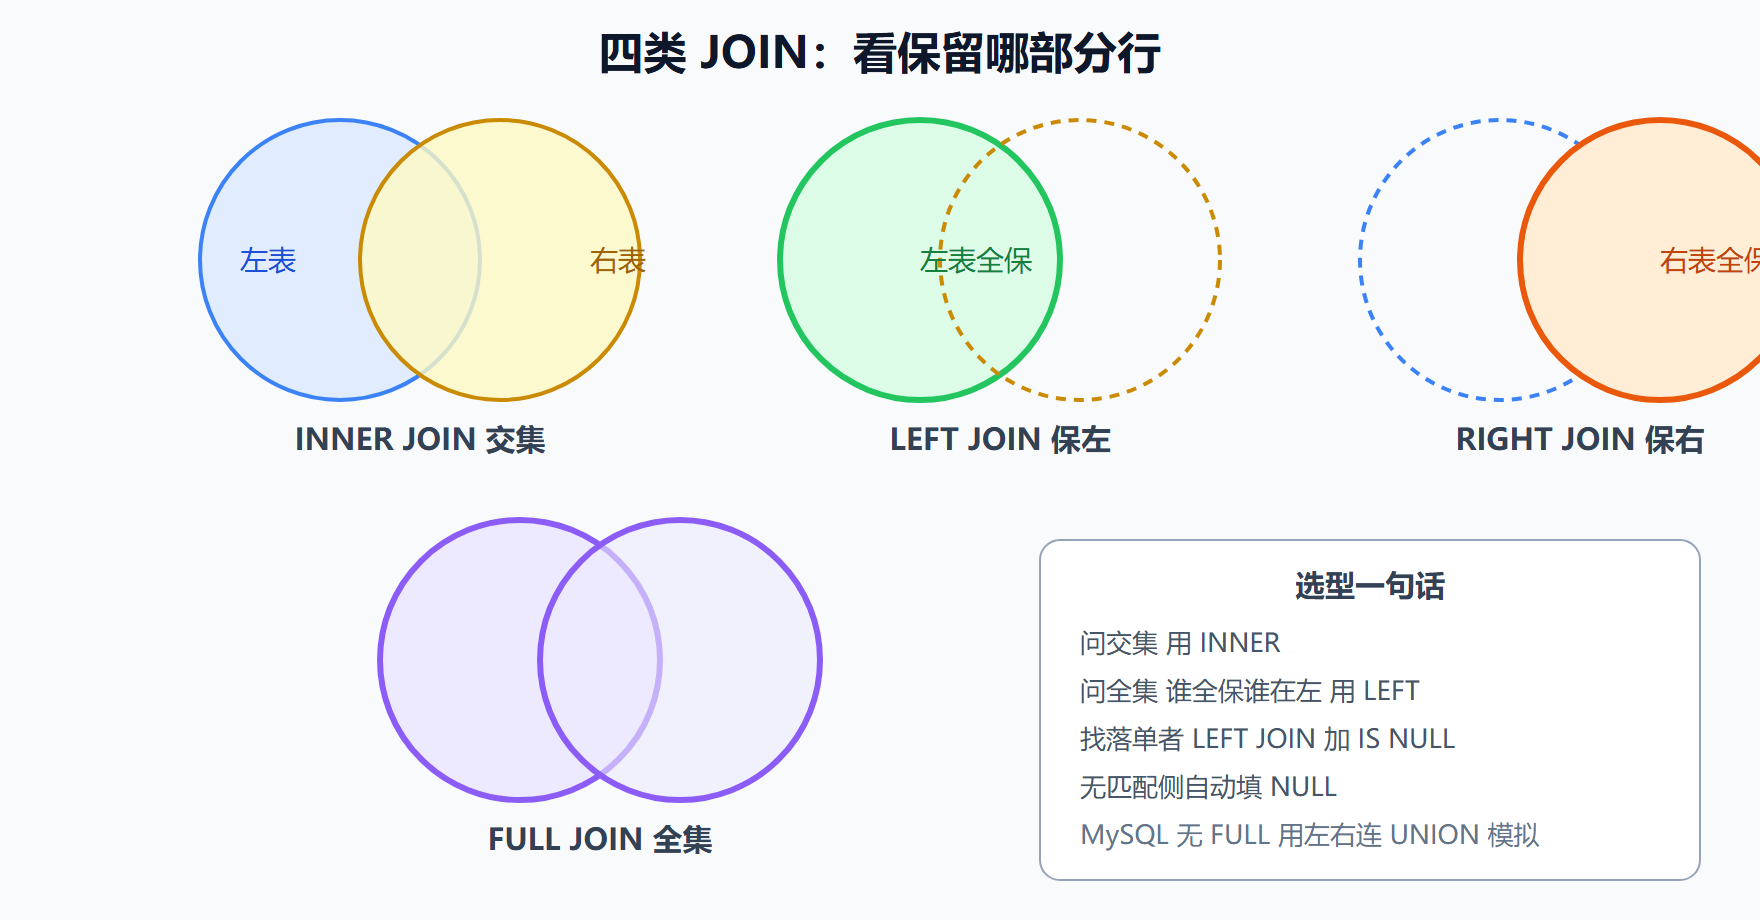
RIGHT JOIN 与 LEFT JOIN 完全对称(保右表全部),实践中只需掌握 LEFT 一种——把要保全的表写在左边即可,RIGHT JOIN 多数团队直接禁用以降低阅读负担。FULL OUTER JOIN 两边都保,MySQL 不支持(需用 LEFT JOIN UNION RIGHT JOIN 模拟),PostgreSQL 与标准 SQL 支持。
图 5-2 四类 JOIN 行为对照
用业务问题反推 JOIN 类型
四类连接不必死记,拿四个真实问题各配一次就长在身上了。
问题一:"有库存的书各属什么分类?"——问的是书与分类的交集,INNER。
问题二:"每个分类各有多少书(包括零本的)?"——全集在分类侧,分类放左,LEFT + COUNT:
-- 注意 COUNT(b.id) 而非 COUNT(*):左连接后空分类有一行 NULL SELECT c.name AS 分类, COUNT(b.id) AS 书目数 FROM categories c LEFT JOIN books b ON b.category_id = c.id GROUP BY c.name ORDER BY 书目数 DESC;
+-----------+-----------+ | 分类 | 书目数 | +-----------+-----------+ | 算法 | 2 | | 数据库 | 2 | | 文学 | 0 | +-----------+-----------+
这里埋着全章最重要的细节之一:COUNT(*) 会把"文学"数成 1——左连接确实给它生成了一行(全 NULL 的行),COUNT(*) 数行不问内容。要数"配上的行数"必须 COUNT(右表的主键)。第 4 章 COUNT 三种数法在此刻发挥威力,知识阶梯就是这样的环环相扣。
问题三:"哪些书还没被任何订单买过?"——落单者在书侧,LEFT + IS NULL 反连接(与上一节"没书的分类"完全同构,换到书的视角)。
问题四:"顾客与订单两边的孤儿都列出来。"——双边全集,FULL JOIN 的主场;MySQL 环境用 LEFT JOIN UNION RIGHT JOIN 模拟,代价是写两遍连接条件。
⚠️ 常见坑:把 RIGHT JOIN 当 LEFT JOIN 的"另一种写法"随手混用,同事 review 时要在脑子里镜像翻转两次才能读懂。团队惯例统一用 LEFT,谁全保谁在左,可读性的收益远大于多敲一次表名交换。
💡 关键直觉:JOIN 类型决定的不是"怎么拼",而是"拼不上时谁留下来"。写连接前先问自己:拼不上的行,业务上要不要看见?答案直接选出四者之一。
本节要点回顾
- INNER 是交集:两边都匹配才保留,落单的行被静默丢弃,统计前先确认业务是否允许丢;
- LEFT 保左全集:右表无匹配填 NULL,该 NULL 是连接动作的标记而非数据空值;
- 反连接套路:LEFT JOIN + 右表键 IS NULL,专找落单者(空分类、无单顾客、未采购书);
- 计数陷阱:LEFT JOIN 后数右表用 COUNT(右表主键),COUNT(*) 会把全 NULL 行数进去;
- FULL 两边全保,MySQL 需左右连接 UNION 模拟;团队惯例统一 LEFT,降低阅读成本;
- 选型一句话:拼不上的行要不要看见、要看见的是哪一边,答案即 JOIN 类型。