1.1 从第一个程序看对象诞生
1.1 从第一个程序看对象诞生
本节摘要:Hello World 只用六行代码,但它启动的那一刻,操作系统已经为程序划好了五个内存区域;
main尚未执行,全局对象已经构造完毕。本节带你放大程序启动的瞬间,看清"对象诞生"发生在内存的哪个角落,这是全册内存模型推理的第一步。
学习目标
阅读完本节,你应当能够:
- 写出并编译运行第一个 C++ 程序;
- 说出进程地址空间五大分区的名称与职责;
- 解释全局对象为何在
main之前构造、在main之后析构; - 区分"声明""定义""初始化"三个常被混用的词。
一、第一个程序与它的运行现场
每本教程都从这六行开始,我们也不例外,但要看的东西不一样:
#include <iostream> int main() { std::cout << "Hello, C++!" << std::endl; return 0; }
#include <iostream> 是预处理指令,在编译的最前期把输入输出库的声明文本搬进本文件。int main() 是程序入口——更准确地说,是"被运行时库调用的函数":真正第一个执行的代码属于 C++ 运行时,它先初始化全局环境,然后才调用你的 main。std::cout 是标准输出流对象,<< 把字符串塞进输出缓冲区,std::endl 换行并刷新缓冲。return 0 把 0 作为退出状态交还操作系统,0 惯例上表示一切正常。
这些解释任何教材都有。本教程多问一句:执行到 << 那一行时,内存里已经有哪些东西了?
图:一个运行中 C++ 程序的内存分区
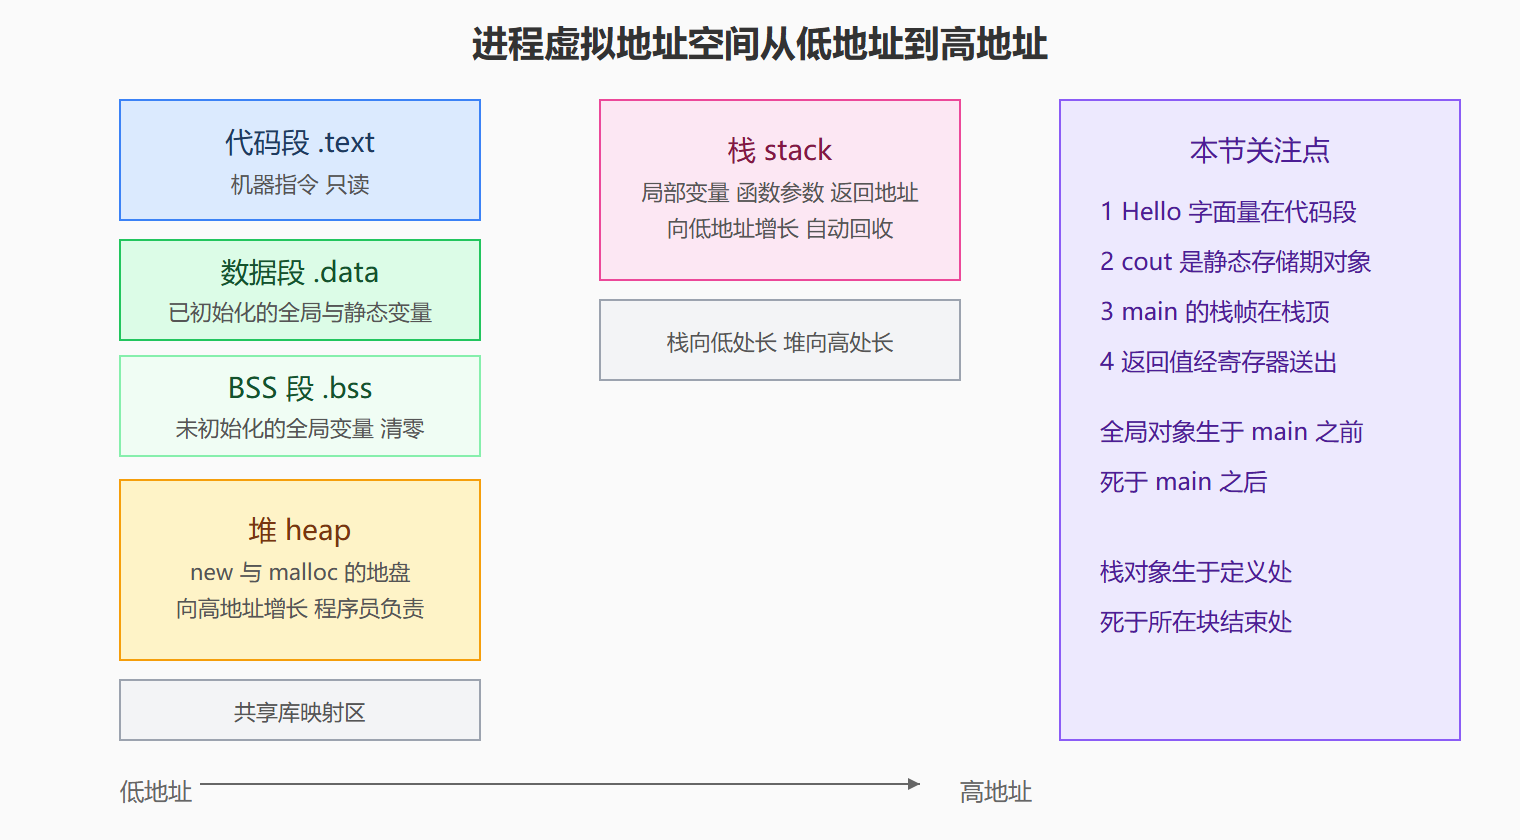
图中最关键的对比是堆与栈:**栈由编译器自动管理,函数返回即回收;堆由程序员手动管理,new 出来的东西必须 delete。**这句朴素的话,后面整册教程都在展开它的后果。
二、对象在 main 之前诞生
来看一段能"证明"全局对象先于 main 存在的代码:
#include <iostream> struct Logger { Logger() { std::cout << "全局对象构造\n"; } ~Logger() { std::cout << "全局对象析构\n"; } }; Logger g_logger; // 静态存储期:main 之前构造 int main() { std::cout << "main 执行中\n"; return 0; } // 输出顺序: // 全局对象构造 // main 执行中 // 全局对象析构
输出顺序揭示了三件事:第一,g_logger 住在数据段(准确说是 BSS 或 .data,取决于是否带初值),它的构造由运行时库在调用 main 前完成;第二,main 返回后进程并未立刻消失,运行时还要依次析构所有全局对象;第三,"对象诞生"和"进入 main"是两个不同的事件。
同一个原理还能解释一个经典陷阱——静态初始化顺序问题:两个编译单元里的全局对象,谁先构造是没有规定的。如果全局对象 A 的构造函数用了另一个文件里的全局对象 B,而 B 还没构造,程序就在起点处崩了。工程上的对策是"构造首次使用"惯用法:把全局对象藏进函数内的静态局部变量,第一次调用时才构造,C++11 还保证这个过程线程安全:
Config& config() { static Config instance; // 首次调用时构造 线程安全 return instance; }
⚠️ 常见坑:全局对象里持有需要复杂初始化的资源(数据库连接、互斥锁)时,优先用上面的函数内静态变量,别裸放全局。
三、声明、定义与初始化:三个不同的动作
初学者常把这三个词混着用,但它们对应的内存动作完全不同。声明是向编译器介绍名字:"存在一个叫 x 的 int"。定义是真正安排内存:"给 x 划四个字节"。初始化是在那块内存里写入初值。看代码:
extern int g_count; // 声明:不分配内存 别处定义 int g_count = 0; // 定义加初始化:数据段里四个字节写 0 int main() { int a; // 定义:栈上四个字节 值是不确定的垃圾 int b{}; // 定义加值初始化:C++11 起推荐写法 确定为 0 int c = 5; // 定义加拷贝初始化 std::cout << b << ' ' << c << '\n'; // 读 a 是未定义行为:垃圾值可能恰好是 0 也可能是任意图案 }
int a; 与 int b{}; 只差两个花括号,语义天差地别。前者在栈帧里划了内存但没写值——那块内存上次被谁用过、留下什么图案,没人知道;读它是未定义行为。后者是 C++11 引入的列表初始化,基本类型会被清零,类类型会调用合适的构造函数。本教程一律推荐花括号初始化,它还禁止窄化转换(int x{3.14}; 直接编译报错),帮你把一类隐式截断错误挡在编译期。
三种存储位置对应的默认行为也不同:全局变量与静态变量即使不写初值也会被清零(BSS 段的特性);局部变量不写初值就是垃圾;堆内存用 new 得到的类对象会构造,但 new int 不加 {} 同样是垃圾值。
四、动手实验:观察地址
理解内存分区最直接的办法是打印地址:
#include <iostream> int g_val = 1; // 数据段 int main() { int stack_val = 2; // 栈 static int static_val = 3; // 静态局部变量仍在数据段 int* heap_val = new int{4}; // 指针在栈 指向的内存在堆 std::cout << "全局 " << &g_val << '\n' << "静态 " << &static_val << '\n' << "栈 " << &stack_val << '\n' << "堆 " << heap_val << '\n'; delete heap_val; }
在我的机器上一次典型输出(地址因系统而异):全局与静态的地址非常接近(同为数据段);栈地址明显大得多(栈通常在地址空间高端,向下生长);堆地址介于两者之间。把这个程序跑一遍,对照上一节的分区图,五个区域就从教科书名词变成了你机器上真实存在的地址区间。
💡 关键直觉:C++ 没有垃圾回收,也没有虚拟机替你兜底——正因如此,"这个对象在哪、谁负责它"不是性能优化问题,而是正确性问题。从第一行代码起就带着这个问题写程序,是 C++ 程序员与多数语言使用者最大的思维差异。
本节要点回顾
- 分区全景:代码段存指令、数据段与 BSS 存全局/静态变量、堆向高长、栈向低长,各有主人。
- 先于 main:全局对象在
main之前构造、之后析构,跨文件初始化顺序不确定,用函数内静态变量规避。 - 三动作之分:声明给名字、定义给内存、初始化给值;栈上未初始化的内存是垃圾,读取即未定义行为。
- 花括号初始化:
int b{};清零且禁止窄化,是现代 C++ 的默认选择。 - 地址即证据:打印地址是验证内存分区假设的最低成本实验,值得亲手做一次。
下一节我们把镜头对准"宽度":每个类型占几个字节、为什么结构体的大小常常大于成员大小之和。