1.2 数据类型即内存布局
1.2 数据类型即内存布局
本节摘要:C++ 的每个类型都是一份内存契约——占用多少字节、按什么格式解释这些字节、要求什么对齐。
sizeof量宽度,补齐规则决定排列,浮点编码决定精度边界。本节教你手工推算任何struct的大小与成员偏移,这是读懂后续对象布局、序列化与缓存优化的基本功。
你将学会
阅读完本节,你应当能够:
- 说出常用基本类型的典型宽度并解释"典型"二字的含义;
- 手工推算含填充的
struct大小与每个成员的字节偏移; - 解释浮点数为什么不能用
==直接比较; - 使用
alignof与位域控制布局。
先看一个反直觉的实验
不用往下翻答案,先自己算:一个结构体装了一个 char、一个 int、再一个 char,它多大?
#include <iostream> struct Bad { char c; int i; char d; }; struct Good { int i; char c; char d; }; int main() { std::cout << sizeof(Bad) << '\n'; // 12 std::cout << sizeof(Good) << '\n'; // 8 }
成员一模一样,只是换了声明顺序,大小差了百分之五十。原因藏在 CPU 的取数方式里:现代 CPU 访问内存喜欢"对齐"的地址——4 字节的 int 最好落在 4 的倍数地址上,否则处理器要么拆成两次访问再拼接,要么直接拒绝。编译器为了满足这个偏好,会在成员之间塞入无名的填充字节。
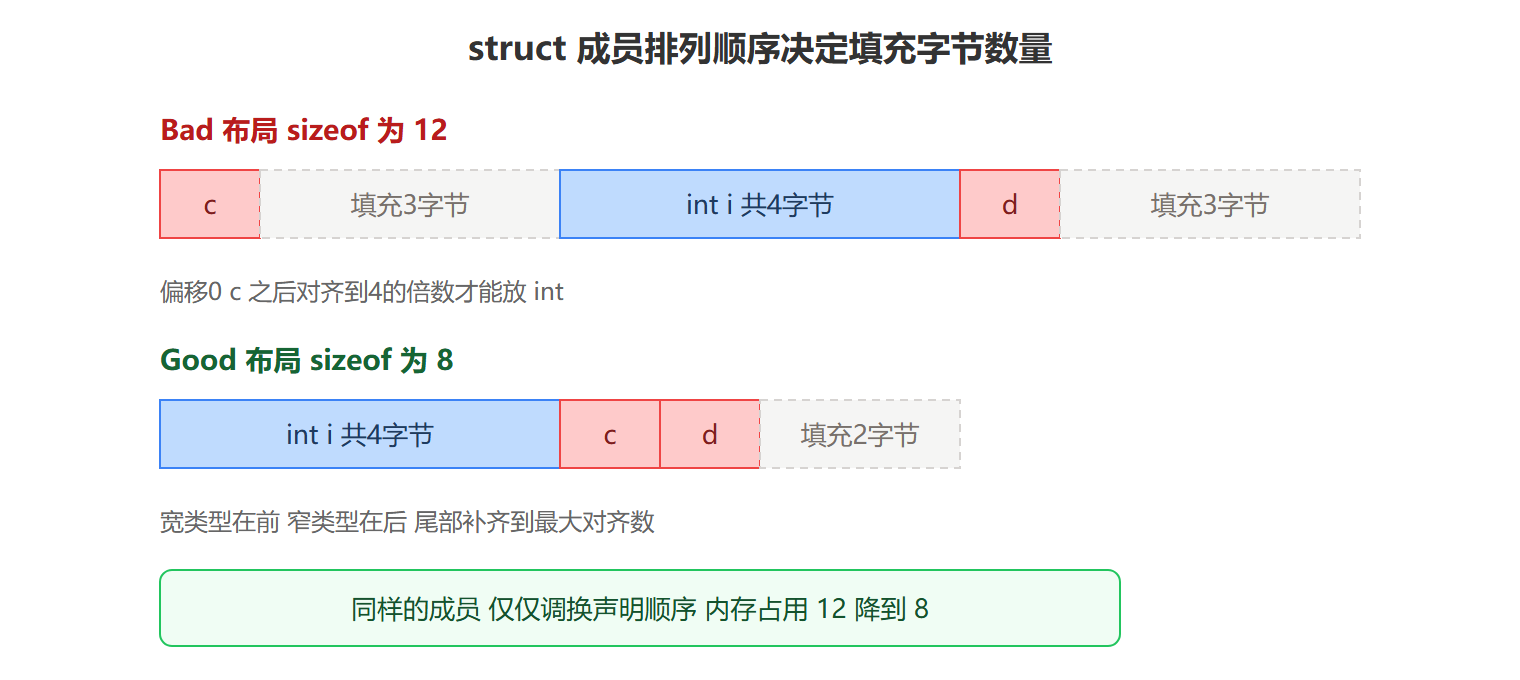
Bad 的实际布局是:c 占第 0 字节,第 1–3 字节填充,i 占第 4–7 字节,d 占第 8 字节——但整个结构体大小还要凑成自身最大对齐数 4 的倍数,于是第 9–11 字节又是填充,总计 12。Good 则是 i 在前、两个 char 紧随,只补 2 个尾巴字节,共 8。成员按对齐需求从大到小排列,是最便宜的优化——一分钱不花,省三分之一内存。
图:Bad 与 Good 两种排列的字节级布局
二、基本类型:宽度是"契约精神"的底线
C++ 标准对类型宽度只给出下限关系(sizeof(char) <= sizeof(short) <= sizeof(int) <= sizeof(long),且 char 恒为 1 字节),不写死具体数字,所以下表叫"典型值"——在主流 64 位平台如此,51 单片机上 int 就只有 2 字节。
| 类型 | 典型宽度 | 值域要点 | 内存视角 |
|---|---|---|---|
char |
1 | -128~127 或 0~255 | 最小可寻址单元,一切宽度的计量单位 |
short |
2 | ±3.2 万 | 常见于音频采样、协议字段 |
int |
4 | ±21.4 亿 | 与寄存器宽度匹配的"默认整数" |
long long |
8 | ±9.2×10¹⁸ | 时间戳、大计数 |
float |
4 | 约 7 位有效数字 | IEEE 754 单精度:1 符号 + 8 指数 + 23 尾数 |
double |
8 | 约 15 位有效数字 | 1 符号 + 11 指数 + 52 尾数 |
bool |
1 | true / false | 理论 1 比特足够,但最小可寻址是字节 |
| 指针 | 8(64 位) | 地址空间 | 宽度只取决于平台位数 |
两个值得单独说的成员:
unsigned 是同一块内存的另一种解释。int 与 unsigned int 都占 4 字节,差别只在最高位被当作符号位还是数值位。这带来一个臭名昭著的坑——有符号与无符号混用时,有符号操作数会被悄悄转换成无符号:
unsigned int u = 1; int i = -2; std::cout << (i < u); // 输出 0!-2 被转成 4294967294 再比较
循环里 for (unsigned i = v.size() - 1; i >= 0; --i) 因此变成死循环——i >= 0 对无符号数永远成立。我的习惯是:表示数量、下标用无符号或专门的有符号索引类型,做算术用有符号,两者绝不混在一个表达式。
浮点是编码出来的数。double 的 8 字节不是一整个整数,而是按"符号位、指数、尾数"切开的编码。十进制的 0.1 在二进制里是无限循环小数,存进 double 只能截断,所以 0.1 + 0.2 == 0.3 是 false。比较浮点要用差值与容差:
#include <cmath> bool nearly_equal(double a, double b, double eps = 1e-9) { return std::fabs(a - b) <= eps * std::max({1.0, std::fabs(a), std::fabs(b)}); }
三、手工推算 struct:一套三步法
给你任意一个结构体,按这三步推算,结果与 sizeof 输出完全一致:
- 每个成员对齐到自身对齐数的整数倍偏移处,中间补填充;
- 总大小凑成最大成员对齐数的整数倍(尾部填充);
alignof(结构体)等于成员中最大的对齐数。
实践一遍:
struct Demo { char a; // 偏移0 double b; // 对齐8:偏移1补7个填充 偏移8起占8字节 short c; // 偏移16 占2字节 int d; // 对齐4:偏移18补2 偏移20起占4字节 }; // 最大对齐8 尾部22补到24 static_assert(sizeof(Demo) == 24);
static_assert 让编译器替你验证推算,算错直接编译失败——把布局知识变成可执行的测试,比人肉核对可靠得多。
需要极致紧凑时(网络协议、百万级数组),可以显式压缩:
#pragma pack(push, 1) // 按1字节对齐 struct WireHeader { uint32_t magic; // 偏移0 uint8_t version; // 偏移4 紧贴 uint32_t length; // 偏移5 不错位但未对齐 }; #pragma pack(pop) static_assert(sizeof(WireHeader) == 9);
省了内存,代价是未对齐访问——x86 上只是慢一点,某些 ARM 平台会直接硬件异常。紧凑布局用于"传输与存储",对齐布局用于"计算",两头都要时就在边界处显式转换。
另一件武器是位域,把标志位压进一个字:
struct TcpFlags { unsigned fin : 1; unsigned syn : 1; unsigned rst : 1; unsigned ack : 1; unsigned reserved : 28; }; static_assert(sizeof(TcpFlags) == 4);
位域的具体排布(从高位还是低位开始)由实现定义,跨平台协议解析别依赖它,用移位与掩码更稳。
四、类型转换的内存后果
同一块字节用不同类型去读,会得到完全不同的值——这是"类型即解释方式"最直接的体现:
double d = 3.14; int* p = reinterpret_cast<int*>(&d); // 指向同一地址 换一种解释 std::cout << *p << '\n'; // 1078523331 一串编码位图案
合法但有风险的操作集中在 reinterpret_cast、static_cast 跨层级与联合体类型双关。C++20 给出过更安全的替代(std::bit_cast),它按位重新解释并返回新对象,绕开了严格别名规则(通过不兼容类型的引用读写对象是未定义行为)。日常编码记住一条底线:想看字节,拷贝出来看(memcpy 到字节数组或 bit_cast),别原地改解释方式。
⚠️ 常见坑:把派生类对象按基类 slice 拷贝、把
char*当int*用、跨平台直接fwrite整个结构体——三者本质上都是"布局假设"错误。凡依赖内存布局的代码,都要加static_assert(sizeof(...) == ...)站岗。
本节要点回顾
- 类型即契约:宽度、编码、对齐三要素定义了一个类型;宽度只是"典型值",跨平台代码用
int32_t这类定宽别名。 - 填充规则三步法:成员各自对齐、尾部补齐、结构体对齐取最大成员值;宽成员在前是最简优化。
- 无符号混算:有符号与无符号同表达式,前者被静默转换,
-1 < 1u为 false 是必修课。 - 浮点非精确:二进制编码决定 0.1 无法精确表示,比较用容差。
- 布局要 static_assert 站岗:紧凑布局、序列化、位域都依赖布局假设,把假设写成编译期断言。
下一节让内存"动"起来:函数调用时栈帧如何压入弹出,对象如何随之生灭。