3.2 依赖注入:对比全局变量与手写单例
3.2 依赖注入:对比全局变量与手写单例
FastAPI 的依赖注入把"接口需要什么资源"写进函数签名:一个普通函数(或类)声明为依赖,框架在每次请求前执行它,把返回值作为参数传入路由。认证令牌解析、数据库会话、分页参数解析这些横切关注点从此离开业务函数体,变成可声明、可嵌套、可测试中替换的一等公民。本节从 Flask 的全局对象方案讲起,对照两种范式的维护成本差异。
本节能力目标
阅读完本节,你应当能够:
- 写出函数依赖、类依赖与 Annotated 别名三种形态;
- 用带 yield 的依赖管理资源生命周期,说明清理代码的执行时机;
- 组织依赖的嵌套,并用缓存机制避免重复执行;
- 区分参数级、路由级、全局依赖三种挂载粒度;
- 在测试里用依赖覆盖替换真实资源。
没有依赖注入的世界长什么样
Flask 生态的惯用手法是全局对象与请求上下文钩子:
from flask import g, request @app.before_request def before(): token = request.headers.get("Authorization", "") g.user = decode_user_or_none(token) @app.route("/me") def me(): if not g.user: abort(401) return jsonify(name=g.user.name)
这套方案能用,但有三处慢性病。隐式依赖:me 函数的运行前提(g 上必须挂了 user)不体现在签名上,读代码要追到 before_request 才知道;换个上下文(脚本、测试、新的钩子顺序)前提就破。全局可变状态:g 是个谁都往上挂属性的袋子,项目大了以后"谁设置了它、何时设置"成为考古题。测试困难:想测 me 的 401 分支,得构造完整请求上下文并按顺序跑钩子,单测被迫升格为集成测试。
Django 的中间件把 user 挂上 request、Express 的中间件往 req 上赋值,本质同构:横切资源靠"先运行的人往共享对象上放"。依赖注入的思路相反——资源不放进共享对象,而是作为参数被递进来,谁要谁声明。
声明式依赖的三种形态
函数依赖,最小形态:
from fastapi import Header, HTTPException, Depends def verify_token(authorization: str = Header()): if not authorization.startswith("Bearer "): raise HTTPException(status_code=401, detail="无效令牌") return authorization.removeprefix("Bearer ") @app.get("/me") def me(token: str = Depends(verify_token)): return {"token": token}
verify_token 自己也是一个带签名校验的函数——依赖可以拥有参数,框架对它做与路由完全相同的解析。这意味着 Header 的存在性检查、422 错误结构,在依赖里免费获得。
类依赖,适合携带配置与状态:
class Pagination: def __init__(self, skip: int = 0, limit: int = 100): self.skip = skip self.limit = limit @app.get("/items") def list_items(page: Pagination = Depends()): ...
Depends() 不带参数时默认使用注解的类型本身,进一步省掉重复。
Annotated 别名,消除重复的现代写法:
from typing import Annotated PageParams = Annotated[Pagination, Depends()] @app.get("/orders") def list_orders(page: PageParams): ...
二十个接口共享同一个分页依赖时,别名写法的收益一目了然,而且类型检查器对它的理解比对默认值写法更好。
对照手写单例方案统计代码分布:单例方案里"获取资源、判空、报错"三步样板在每个视图开头重复;依赖方案里这些代码物理上只存在于依赖函数一处,视图里只剩一个签名声明。重复不是被消除了,而是被搬进了声明——声明可被工具消费(文档、类型检查),复制粘贴的样板不能。
带 yield 的依赖:资源生命周期的精确控制
数据库会话这类"用完必须归还"的资源,依赖注入用 yield 语法给出标准解:
def get_session(): session = SessionLocal() try: yield session finally: session.close() @app.get("/users/{uid}") def get_user(uid: int, session=Depends(get_session)): return session.get(User, uid)
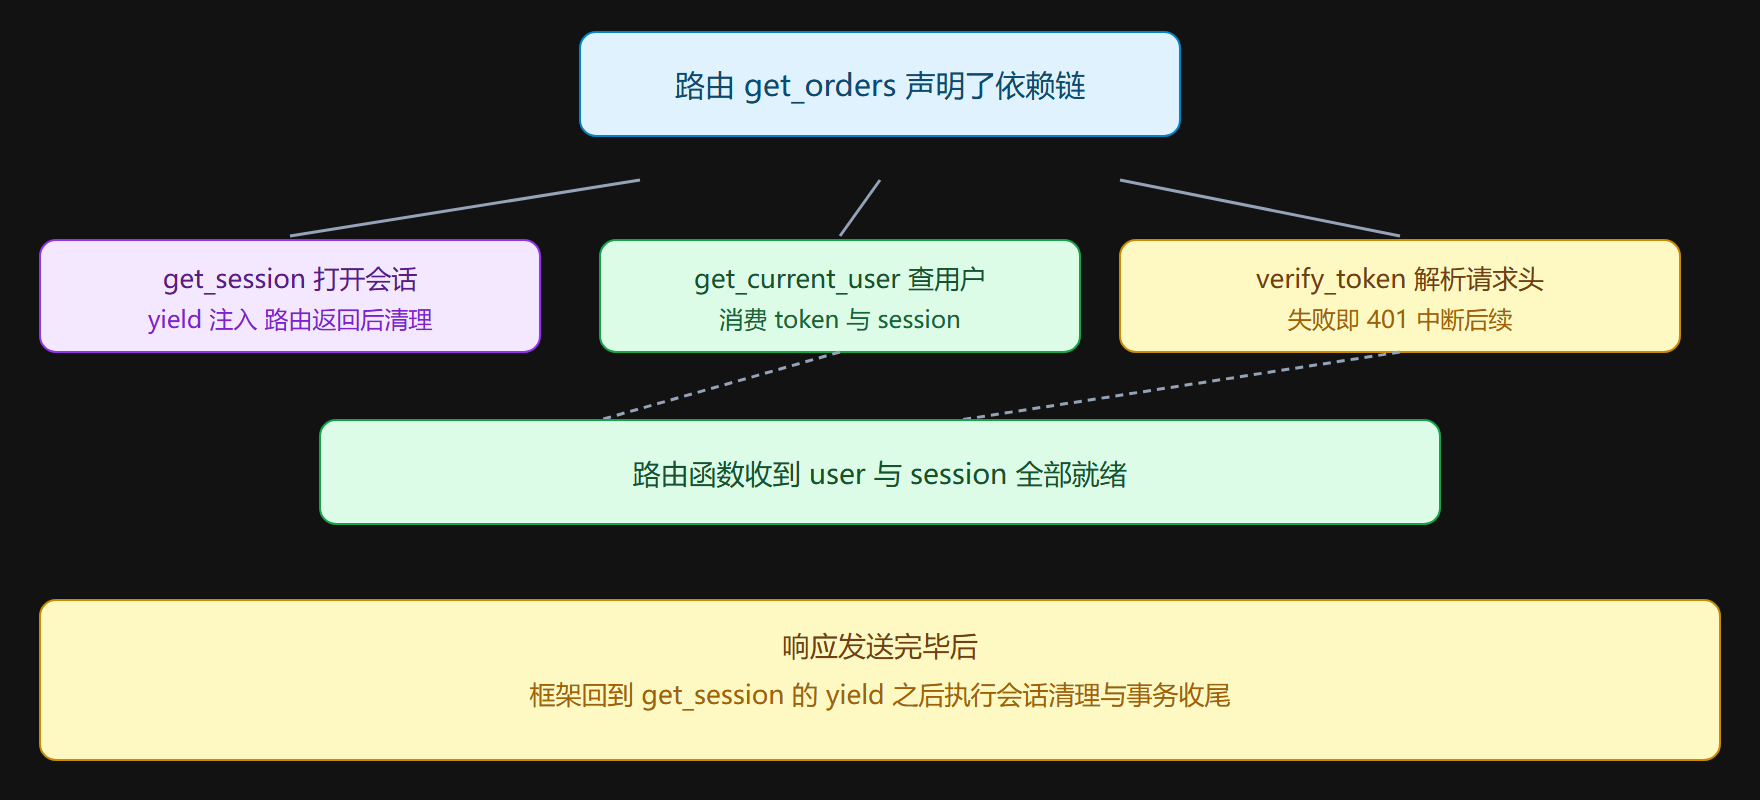
执行时序是理解的关键:请求进来先执行到 yield,产出会话注入路由;路由返回、响应发送完毕后,框架回到 yield 之后执行清理。会话的存在期恰好覆盖整个请求处理,不早不晚——比 Flask 里 before_request 创建、teardown_request 销毁的钩子对更直观,因为创建与销毁写在同一个函数的上下两段,一屏可见。
异常传播也有明确规则:路由里抛出的异常会穿透 yield 点向上冒泡,可以在 yield 后用 try 捕获做事务回滚之类的补偿——第 6 章数据库集成会展示这个模式处理提交与回滚的完整写法。
嵌套与缓存:依赖的依赖
依赖可以依赖别的依赖,这让横切关注点可以按语义分层:
def get_current_user(token: str = Depends(verify_token), session=Depends(get_session)): user = session.query(User).filter_by(token=token).first() if not user: raise HTTPException(status_code=401, detail="用户不存在") return user def get_admin_user(user=Depends(get_current_user)): if not user.is_admin: raise HTTPException(status_code=403, detail="需要管理员权限") return user
权限链条 verify_token → get_current_user → get_admin_user 逐层收紧,每个接口声明自己需要的层级即可。对比钩子方案:Flask 里这通常是"在 before_request 里查权限表"或者装饰器堆叠,权限逻辑与视图注册分离两处。
同一请求内依赖默认缓存:get_current_user 被 get_admin_user 和路由同时声明时只执行一次。这个默认几乎总是对的(查一次用户够了),需要每次执行时在 Depends 里关掉 cache。
挂载粒度上三档可选:参数级(写在签名里,仅该接口)、路由级(装饰器的 dependencies 列表,不取返回值,用于"必须过校验但不需要结果"的场景,如审计日志)、全局级(应用的 dependencies,全部接口生效)。从细到粗,按影响面选择——全局依赖会让每个请求都付出成本,慎放重逻辑。
测试中的依赖覆盖
依赖注入对可测试性的提升是结构性的。真实项目里 get_session 连着数据库,测试时一行覆盖:
app.dependency_overrides[get_session] = override_session
路由代码零改动,测试里拿到的就是内存会话。对比 Flask 方案:测试要么起完整应用上下文连测试库,要么 mock 全局 g 对象——前者慢,后者脆。覆盖机制让"路由逻辑的单测"与"数据库的集成测"真正分离,第 5 章测试一节会把它纳入完整的测试分层。
图示:一次请求中的依赖解析树
工程判断:什么时候不该用依赖注入
依赖注入是手段不是目的。三类场景我会选择更朴素的方案:纯常量配置(直接读配置对象,包装成依赖徒增一层间接);请求内只用到一次且无验证语义的简单计算(写在函数体里更直观);跨请求的真全局单例如连接池工厂(模块级初始化加惰性获取,用依赖包装仅在需要按请求分发时才有意义)。判断标准始终是:这个抽象是否消除了真实的重复或耦合。为每个函数参数都造一个依赖,是另一种形式的面子工程。
一组进阶用法:把依赖用到深处
基础形态之外,依赖系统还有三个进阶用法,出现在中大型项目里。
**用法一:依赖做参数预处理。**分页参数规范化——客户端传的 page 与 size 各式各样,统一在依赖里转换成 offset 加 limit:
def pagination(page: int = Query(ge=1, default=1), size: int = Query(ge=1, le=100, default=20)) -> tuple[int, int]: return (page - 1) * size, size @app.get("/articles") def list_articles(pager: tuple[int, int] = Depends(pagination)): offset, limit = pager ...
对照把这段逻辑复制到每个列表接口的写法,依赖版本的规范化规则只存在一处——page 从 1 起还是从 0 起这类约定之争,也只需要赢一次。
**用法二:类依赖按请求携带状态。**分页只是元组时够用;需要"当前用户能看到的范围"这种带身份的筛选时,类依赖的价值就出来了——类的初始化参数是签名声明的查询参数,实例属性是派生状态,业务函数拿到的是完成上下文装配的对象。数据库的多租户行级过滤是典型场景:依赖里读出租户 id,会话查询自动带上过滤条件,业务代码完全不出现"租户"这个词——横切的安全约束被藏进基础设施层。
**用法三:依赖的层级配置。**同一套权限链,多数接口要登录、少数要管理员、个别还要特定 scope。三级挂载(参数、路由、全局)配合依赖嵌套,让"权限矩阵"以声明组合的方式表达,而不是以 if 树的方式散落。这为第 5 章的安全体系准备好了全部积木。
三个用法共通的心法:依赖是"从请求到业务函数之间的变换管线"——凡是可以描述为"拿请求的某些部分,算出业务需要的某个东西"的逻辑,都是依赖的合法居民。用这个定义去审视自己的接口,能搬进管线的就搬,业务函数会瘦得只剩业务。
常见问题速答
**问题:依赖抛出的异常怎么变成响应?**与路由异常同一条通道——依赖里抛 HTTPException 或自定义异常,处理器(第 4 章)统一翻译。这正是认证依赖能直接返回 401 的原理:依赖在路由执行之前运行,它的失败让请求根本到不了业务函数。失败语义也因此在链上有层次:验证类失败(422)在签名解析层、认证类(401)在依赖层、业务类(409 等)在路由层。
**问题:依赖能拿到请求的其他部分吗?**能。依赖的签名可以声明 Request 对象、Header、Cookie,与路由签名的表达能力完全一致——因为框架对两者用的是同一套解析器。想做按请求头灰度开关的依赖,声明 Header 参数即可,无需任何全局状态。
**问题:依赖执行顺序可控吗?**同一请求内按需解析、结果缓存——先被引用的先执行,被多次引用只执行一次。想让某个依赖一定最先跑(如请求 id 生成),把它放进最外层的依赖链或改用中间件(第 4 章的顺序规则)。顺序需求极端复杂的场景,通常说明该用中间件而非依赖。
**问题:同步依赖和异步依赖能混用吗?**能,规则与路由相同:async def 依赖跑在事件循环(内部不能阻塞),def 依赖进线程池。一个 async 路由挂着 def 依赖很常见(依赖里有同步数据库调用),框架会把 def 依赖在线程池里执行后再回到循环——这套混合规则让渐进迁移比想象中平滑。
本节要点回顾
- 范式反转:资源从"先运行者挂到共享对象上"变成"谁需要谁在签名里声明",隐式前提变成显式契约。
- 三种形态:函数依赖自带参数校验、类依赖携带配置、Annotated 别名消除重复,按场景选形。
- yield 生命周期:创建与清理同函数上下两段,存在期精确覆盖请求;异常穿透 yield 点可用于回滚补偿。
- 嵌套与缓存:权限链逐层收紧,同请求内依赖默认只执行一次;挂载粒度三档,全局依赖慎放重逻辑。
- 测试红利:dependency_overrides 一行替换真实资源,路由单测与资源集成测彻底分层。
- 反面清单:常量、一次性无验证计算、真全局单例,三类场景不值得引入依赖抽象。
资源的"来路"解决了,第 4 章看"去路":响应如何序列化、错误如何统一、中间件如何在两层之间横切。
延伸与边界
依赖注入的边界感同样重要:它管理"请求作用域"的资源与逻辑,不管理更长生命周期的事物。应用级单例(启动时创建、全进程共享的连接池)属于 lifespan 的领地,模块级常量属于配置的领地,跨请求的可变状态属于缓存与数据库的领地。把不属于请求作用域的东西硬塞进依赖(比如在依赖里做进程级缓存初始化),会得到生命周期错位的怪异行为。分清四种作用域——请求、应用、模块、外部存储——是依赖注入用得干净的最后一课,也是向第 6 章数据库集成过渡的必要准备。
- 签名即文档:接口需要什么资源、通过什么校验,签名一览无余——新人读代码不必追钩子、搜全局,这本身就是协作效率。
值得留在手边的还有那张依赖解析树的图——排错时沿着树从根到叶走一遍,问题必在某个节点上现形。