3.1 同步与异步路由:执行模型与性能对比
3.1 同步与异步路由:执行模型与性能对比
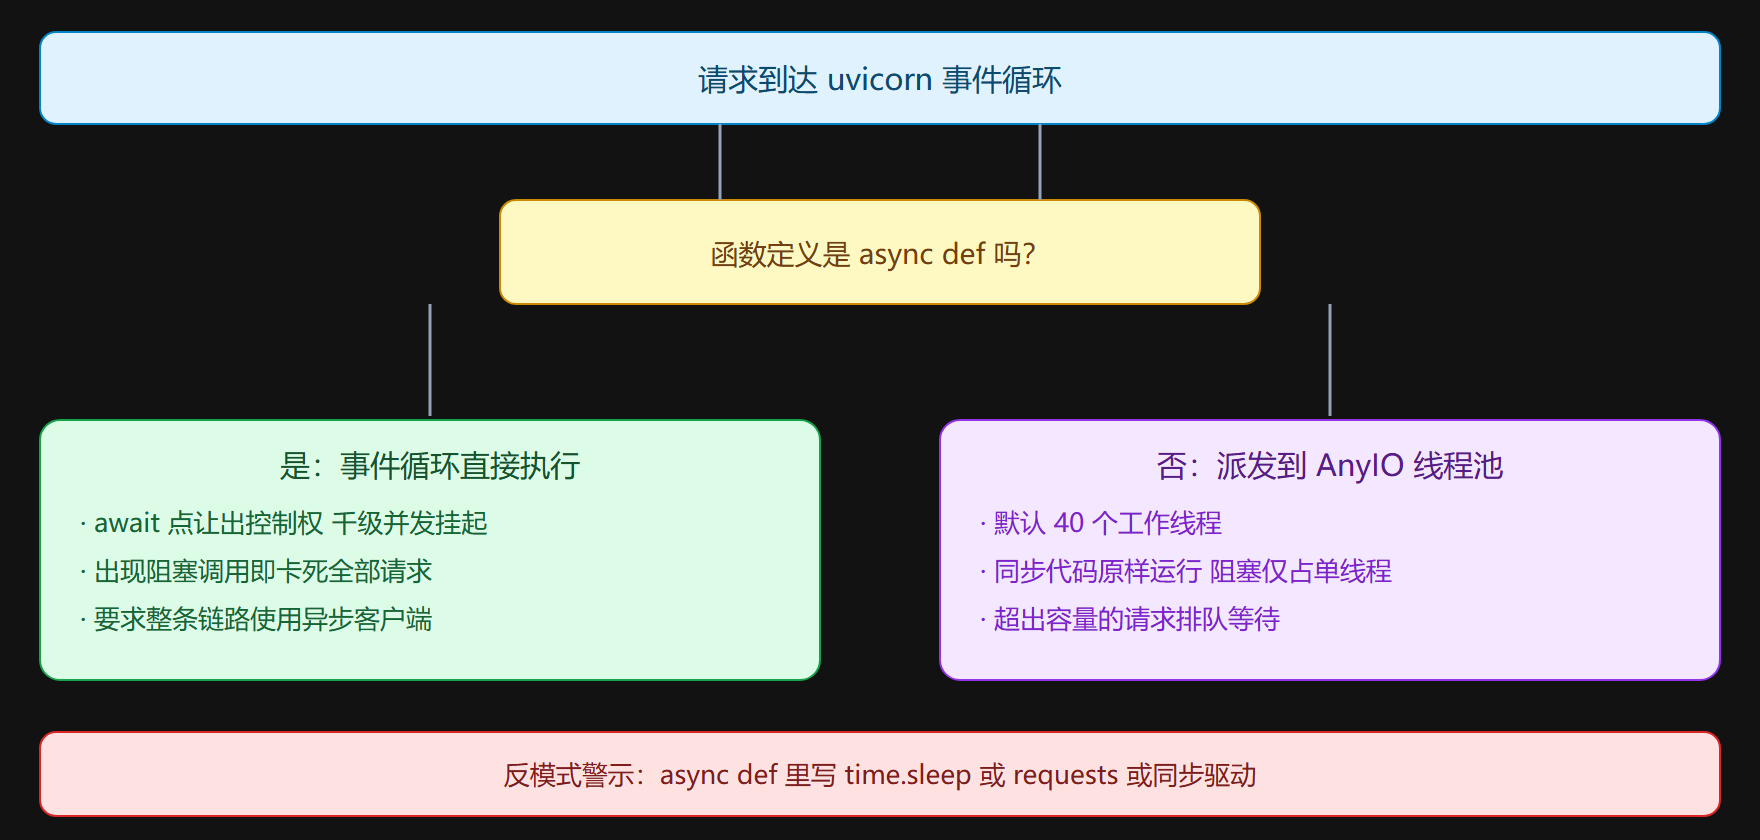
FastAPI 按函数定义的关键字分派执行环境:async def 路由直接跑在事件循环上,def 路由被放进线程池执行。这条分派规则解释了所有关于"FastAPI 快不快"的争论——用对了执行模型(等待时让出)吞吐可上一个数量级,用错了(async 里跑阻塞调用)比纯同步栈更糟。本节用可运行的实验拆开这套机制。
学习目标
阅读完本节,你应当能够:
- 说出 def 与 async def 路由各自的执行环境与阻塞影响范围;
- 亲手复现"async 里 time.sleep 卡死事件循环"的实验并解释原理;
- 说明线程池兜底的默认容量、超载行为与调优参数;
- 判断一段存量代码该用同步路由过渡还是直接异步化;
- 用连接池等指标评估"整条链路异步"是否成立。
先做实验,再谈原理
四段路由,覆盖两种函数定义与两种等待方式的组合:
import asyncio import time from fastapi import FastAPI app = FastAPI() @app.get("/a") async def a(): asyncio.sleep(1) # 忘了 await:什么都不会发生 return {"case": "a"} @app.get("/b") async def b(): time.sleep(1) # 阻塞调用进了事件循环 return {"case": "b"} @app.get("/c") async def c(): await asyncio.sleep(1) # 正确:等待时让出 return {"case": "c"} @app.get("/d") def d(): time.sleep(1) # 同步函数,进线程池 return {"case": "d"}
用并发工具(比如一次发 20 个请求)逐个测试:接口 c 全部并发完成,总耗时约 1 秒——二十个请求同时挂起、同时醒来;接口 d 同样约 1 秒完成——二十个请求摊到线程池的各个线程里各自阻塞;接口 b 的总耗时约 20 秒——time.sleep 把事件循环整个按住,所有请求排队串行;接口 a 立刻返回——没有 await 的协程调用只创建了协程对象,根本没执行。
这四个结果值得贴在显示器上。async def 不是性能开关,让出才是;忘 await 的静默跳过是最危险的合成谬误——接口看起来正常工作,耗时逻辑全部蒸发,上线后才发现数据没写进去。
事件循环的让出机制:一个座位一个演讲者
把事件循环想象成一场只有一个座位的圆桌会议:演讲者(任务)说到需要等待外部回应的地方(await),主动把话筒交回主持人(循环),主持人把话筒给下一个准备好的演讲者。会议的吞吐取决于"等待的时间被别人利用了多少"。同步模型里演讲者说"等我一下"就抱着话筒发呆;异步模型里等待的每一毫秒都在为别的请求服务。
这解释了第 1 章留下的伏笔——为什么"等待 IO 而非计算"是异步收益的前提。计算型任务没有可让出的等待点,事件循环的单线程反而把多核全浪费了;而一次 100 毫秒的数据库往返,足够循环处理几百个别的请求的分发与响应。CPU 密集负载的正确去处是独立进程或任务队列(第 5 章后台任务与第 7 章部署会给出方案),不是更聪明的路由写法。
线程池兜底:def 路由的安全网与其边界
FastAPI(经由 Starlette 与 AnyIO)把 def 路由放进线程池,这让存量同步代码无需重写就能跑起来——迁移期的救命设计。但安全网有明确的承重极限:
AnyIO 默认线程数是 40。第 41 个并发的 def 请求会排队等空闲线程。若每个请求耗时 1 秒,40 线程的稳态吞吐就是每秒 40 个;超过的部分在队列里堆积,客户端观感是延迟雪崩。判断方法很简单:看监控里 def 路由的并发数与平均耗时,乘积接近 40 就到边界了。调整容量有两种方式——启动环境变量层面设置 AnyIO 的 tokens 数量,或者更根本地:把热点路由异步化,让它们离开线程池回到事件循环。
对比一下就明白兜底的定位:Flask 加 gunicorn 的经典部署是 N 个 worker 进程、每进程一个线程(或配线程数),并发上限等于 worker 数乘线程数,扩容靠加进程;FastAPI 的 def 路由是单进程内 40 个线程起步、async 路由理论上千级并发,扩容靠改执行模型。迁移 Flask 项目时,直接把视图函数原样搬进 def 路由,性能至少不低于原部署(线程池对多 worker),这给了你从容异步化的缓冲期——先跑起来,再按热点逐个改。
整条链路异步:木桶的每一块板
async 路由的收益条件是整条调用链无阻塞。常见的"半吊子异步"翻车现场:
@app.get("/report") async def report(): rows = sync_db.execute("...") # 同步数据库驱动 r = requests.get("http://internal/stats") # 同步 HTTP 客户端 return {"rows": len(rows), "stats": r.status_code}
两行阻塞调用都发生在事件循环上,并发 20 个请求时它们逐个执行——这就是"用了 async 反而更慢"的标准案例。修复有两种方向:换异步客户端(SQLAlchemy 的 async 引擎加 asyncpg、httpx 的 AsyncClient),或者退回 def 路由让线程池兜底。选哪条取决于改造成本与调用频率:高频热点值得异步化,低频后台接口用 def 路由完全够格。工程上诚实的做法是把这条判断写成 review 清单:async 函数里禁止出现 requests、time.sleep、同步 ORM 会话——配一个静态检查规则就能自动化。
连接池是链路异步化的隐形短板。异步驱动把等待让出去了,但如果数据库连接池只有 5 个连接,第 6 个并发请求在池上排队——表面上接口是 async 的,吞吐被池容量卡住。评估异步化的收尾动作永远是盘点整条链路的资源上限:数据库连接池、下游服务连接数、文件句柄,木桶最短的那块板决定实际吞吐。
迁移路线:三步走
存量 Flask 同步服务的推荐迁移顺序:
第一步,原样搬迁。视图函数改成 def 路由,阻塞代码不动,靠线程池运行。此阶段验证功能等价性,性能持平即是胜利。第二步,定位热点。用访问日志与耗时统计找出 20% 的高频接口,评估其依赖(数据库客户端、外部调用)有无异步版本。第三步,逐段替换。热点接口改 async def、换异步客户端、核对连接池容量,每改一段用并发压测对比前后。三步之间可以相隔数周,不存在"一次性全异步化"的死线——这套节奏本身就是 FastAPI 双执行模型给迁移者的礼物。
图示:请求分派全景
常见疑问三则
async 路由里必须全程 async 吗? 不必须,但阻塞调用必须离开事件循环。小段 CPU 计算(微秒级)无伤大雅;毫秒级以上的同步操作要么换异步库,要么用线程池工具包把它包起来再 await。
并发上不去,先查什么? 按顺序:路由是不是意外写成了 def(线程池 40 上限);异步驱动连接池是不是太小;下游服务是不是瓶颈;最后才怀疑框架。绝大多数"FastAPI 慢"的案例在前三项里就结案了。
测试环境要不要模拟并发? 单元测试不必,但每个异步化改动都该配一个并发回归:固定并发数打一段时间,断言 P99 延迟。没有度量的异步化等于没有做。
一个完整的实战样本:读接口异步化全过程
把前面所有结论串成一次真实改造。起点是一个 Flask 迁来的 def 路由:读数据库、调一个内部统计服务、返回聚合结果。压测基线:50 并发下 P95 为 1.8 秒,线程池排队明显(并发稍高就抖动)。
第一步,盘点依赖:数据库客户端是同步的 psycopg2,统计服务调用用的 requests。两者都有异步替代——asyncpg 生态与 httpx。第二步,改写热点路由:async def、异步会话工厂、AsyncClient 复用(客户端实例要挂在应用生命周期上而非每次请求新建,新建连接的开销会吞掉异步收益)。第三步,改后回归:同样的 50 并发,P95 降到 600 毫秒左右——剩下的耗时主要是统计服务本身的响应时间。第四步,踩坑记录:改完首测不升反降,排查发现统计服务的 AsyncClient 忘了复用,每个请求都在做 TCP 握手;修正后收益才显现。
这个样本的每个数字都印证一条前文结论:收益来自"让出"(等待统计服务时循环服务其他请求);隐形短板在连接资源(AsyncClient 复用与否,差一个数量级);度量贯穿全程(没有基线就不知道 600 毫秒算不算成功)。第 7 章性能优化一节会把这套流程升级为带瓶颈指纹分类的排查手册。
事件循环之外:uvloop 与生产参数一瞥
进生产前还有一组参数值得知道。uvloop 是 asyncio 事件循环的 C 实现替代,uvicorn 默认在支持的平台上启用它,性能比原生循环好一截——通常不需要干预,但知道它的存在有助于读懂基准测试的差距来源(有的框架对比测试悄悄关掉了它)。workers 参数在多核机器上启动多个进程各持一个循环,是第 7 章部署话题的入口——单进程 asyncio 的并发是"一个循环里的千级挂起",多进程是"数个循环各管各的请求",两层机制叠加构成完整的容量模型。此处留个钩子:并发的垂直提升靠让出,水平扩展靠进程,两个维度不要混淆。
三条被反复验证的经验
第一条,把本章的四个实验接口保留在项目里(路径加个下划线前缀避开文档),新成员入职第一天的练习就是跑这四个接口——比任何口头讲解都快地建立执行模型的直觉。第二条,review 异步代码时只盯一件事:await 链上有没有断裂(调了同步阻塞函数等于断裂),其他问题都可以后置。第三条,永远给自己的判断留数字证据——我觉得变快了在异步优化里尤其不可信,因为并发场景的直觉失准率极高,并发工具跑三十秒胜过拍脑袋三十分钟。
本节要点回顾
- 分派规则:async def 上事件循环、def 进线程池,一字之差两条路径;忘 await 的协程调用静默蒸发是最危险的错误。
- 让出即吞吐:等待 IO 时让出座位是异步收益的全部前提,计算型任务没有让出点,属于任务队列的领地。
- 线程池边界:默认 40 线程是 def 路由的并发天花板,超限排队表现为延迟雪崩;扩容靠异步化而非加线程。
- 链路原则:一处阻塞满盘皆输,async 函数里禁用 requests、time.sleep 与同步会话;连接池容量是隐形短板。
- 迁移节奏:先 def 原样搬迁、再定位热点、逐段异步化,三步可跨数周,双执行模型提供了从容过渡的可能。
执行模型定了上下文,下一节解决"上下文里的资源怎么来":依赖注入系统如何把认证、会话、公共参数从函数体里抽走。
延伸与边界
执行模型的知识有明确的失效边界:它解释 IO 并发,不解释计算性能。当瓶颈是排序百万行数据或图像编码时,async 与否毫无差别,那是算法与进程模型的领地。另一个边界是规模——单机的并发收益有上限,超过千级并发挂起后,文件描述符、内存、下游容量会依次成为新的墙,那时要谈的是分片与横向扩展(第 7 章部署的话题)。把异步当万能药与当玄学都是误读,它是 IO 密集服务的一种执行策略,仅此而已——但在这个定位上,它确实是当前 Python 生态最好的答案。