4.1 响应处理:多形态输出与响应模型契约
4.1 响应处理:多形态输出与响应模型契约
FastAPI 的响应处理分两层:返回值层决定"输出什么数据",response_model 与 Response 类决定"以什么形态与契约输出"。JSON 是默认形态,但 HTML、文件、流式各有专属响应类;response_model 则是输出侧的守门人——过滤字段、执行输出校验、生成文档中的响应结构。本节把这两层机制与 Flask 的 jsonify 体系对照展开。
学习目标
阅读完本节,你应当能够:
- 用 response_model 过滤输出字段并解释其拦截时机;
- 为同一个资源分别设计输入模型与输出模型;
- 按场景选择四个常用 Response 类;
- 用 StreamingResponse 处理大文件与生成式输出;
- 设置状态码、响应头与 Cookie 的声明位置。
response_model:输出侧的第二道契约
先看一个真实的泄漏事故模型。用户表里有密码哈希与邮箱,接口直接返回 ORM 对象:
@app.get("/users/{uid}") def get_user(uid: int): user = db.get(User, uid) return user # ORM 对象的所有字段都被序列化
password_hash 就这样跟着 JSON 出去了。Flask 世界里等价事故极多——jsonify(user.to_dict()) 的 to_dict 忘了排除敏感列。FastAPI 的标准防线是声明输出模型:
from pydantic import BaseModel class UserOut(BaseModel): id: int name: str email: str @app.get("/users/{uid}", response_model=UserOut) def get_user(uid: int): user = db.get(User, uid) return user
返回值先经过 UserOut 的过滤与校验,多出来的字段(密码哈希、内部标记)被丢弃,缺字段或类型不符则直接报错——输出不合法时接口失败,而不是把脏数据发出去。文档页的响应结构同样来自 UserOut,前端看到的契约与运行时行为同源。
拦截时机值得说清:过滤发生在响应序列化之前、业务函数之后,所以业务函数内部仍然可以用完整对象,出关口才收窄。这个设计让"内部宽、外部窄"成为自然写法——对照在函数内手动构造安全字典的方案,后者每个新增字段都要记得同步两处,迟早漏。
输入模型与输出模型:一对而不是一个
第 2 章埋的问题在这里兑现:部分更新接口的"显式置空"与"不修改"语义。完整的三模型方案:
class UserIn(BaseModel): # 创建:可提交 name: str email: EmailStr password: str = Field(min_length=8) is_admin: bool = False class UserUpdate(BaseModel): # 更新:全部可选 name: str | None = None email: EmailStr | None = None class UserOut(BaseModel): # 输出:对外可见 id: int name: str email: str
UserUpdate 的每个字段都是"缺省即不改",配合 model_dump(exclude_unset=True) 只取客户端实际提交的字段——PATCH 语义精确成立。UserIn 里的 is_admin 是创建时的可选项,UserOut 里没有 password——三个模型各管一段生命周期,安全边界画在类型上而不是画在记忆里。Flask 项目里常见的"一个 dict 函数走天下"在这些场景下都是隐患源:输入输出共用结构,敏感字段排除靠手动,更新语义靠 if 链。
⚠️ 常见坑:response_model 的输出校验失败时报的是 500 而不是 422——因为它校验的是你自己的返回值,不是外部输入。看到这类 500,检查方向是"业务代码返回的数据与输出模型不符",比如模型声明 int 字段而数据库返回了字符串。
JSON 之外的四种形态
HTMLResponse:返回完整 HTML 字符串,Content-Type 自动为 text/html。适合健康检查页、极简管理页;完整的模板渲染挂 Jinja2Templates(第 6 章静态文件一节会连同静态资源一起配)。
RedirectResponse:302 跳转, OAuth 流程的中间跳板常用。
FileResponse:文件输出的正确答案。它会设置 Content-Disposition、支持断点续传区间请求、用异步方式读盘不占事件循环:
from fastapi.responses import FileResponse @app.get("/download/{name}") def download(name: str): return FileResponse(path=f"/data/files/{name}", filename=name)
StreamingResponse:数据不落盘或体积未知时使用——生成器逐块产出,数据库大结果集导出 CSV、模型逐 token 输出都是典型场景:
from fastapi.responses import StreamingResponse import asyncio, json @app.get("/stream") async def stream(): async def gen(): for i in range(10): yield json.dumps({"n": i}) + "\n" await asyncio.sleep(0.1) return StreamingResponse(gen(), media_type="application/x-ndjson")
对照 Flask:FileResponse 对应 send_file、StreamingResponse 对应带生成器的 Response、HTML 对应 render_template——能力一一映射,差异在 FileResponse 的异步读盘与区间请求支持更完整,以及返回值可以保持"普通 Python 对象"的形态由框架装箱。
状态码、响应头与 Cookie
三个常用修饰位置。装饰器参数控制默认成功状态码:@app.post("/users", status_code=201)——创建资源返回 201 是 REST 惯例,写在这里比在每个 return 里塞 201 更不容易漏。Response 参数按需注入精细控制:
from fastapi import Response @app.post("/login") def login(resp: Response): resp.set_cookie(key="sid", value="abc", httponly=True) resp.headers["X-Request-Id"] = "r-123" return {"ok": True}
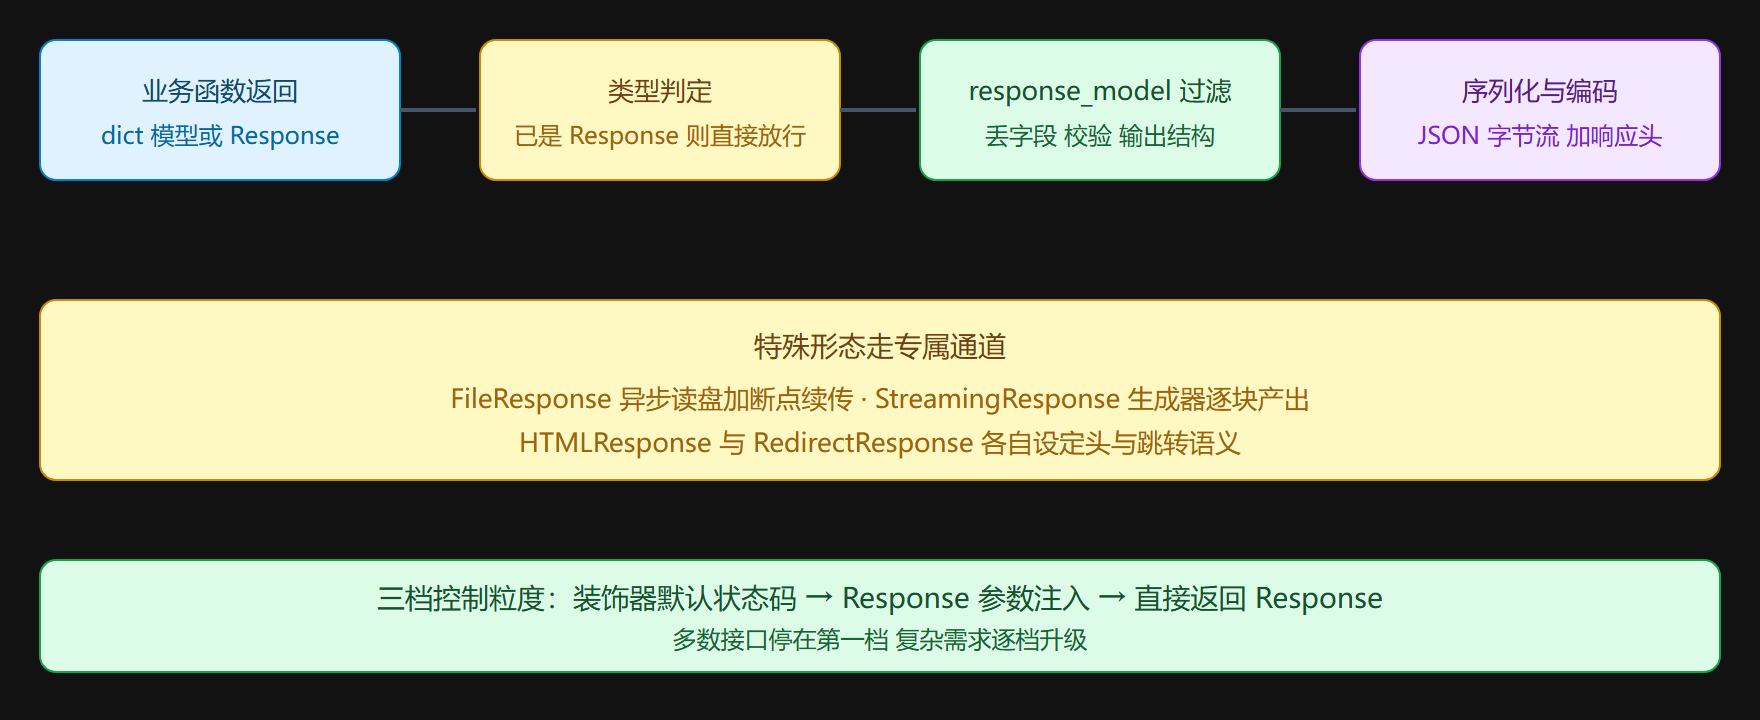
需要完全接管(自定义状态码加自定义体)时直接返回 Response 实例即可,声明过的 response_model 会被跳过。三档控制粒度从粗到细,按需取用——多数接口停在第一档就够。
图示:返回值到字节流的完整链路
序列化的版本插曲
第 2 章 v1 与 v2 的差异在响应侧有一处高频接触点:response_model 的过滤与校验底层调用的正是序列化 API(v2 的 model_dump 家族带 exclude、include、by_alias 等参数)。当输出需要改字段名(数据库下划线对外驼峰)时,v2 用 Field 的 alias 加 model_config 的 populate_by_name 控制,v1 用 Config 的 allow_population_by_field_name——同样的需求两代写法,迁移期项目要统一选定一种约定,避免两种别名策略混用导致文档与实际输出不一致。
实战组合:列表接口的完整输出设计
把本节机制串起来设计一个常见的"分页列表"输出,它是输出契约设计的试金石:
from pydantic import BaseModel class PageMeta(BaseModel): total: int page: int size: int class ArticleOut(BaseModel): id: int title: str author_name: str class ArticlePage(BaseModel): items: list[ArticleOut] meta: PageMeta @app.get("/articles", response_model=ArticlePage) def list_articles(page: int = Query(ge=1, default=1), size: int = Query(ge=1, le=100, default=20)): total, rows = query_articles(page, size) return ArticlePage( items=[ArticleOut(id=r.id, title=r.title, author_name=r.author.name) for r in rows], meta=PageMeta(total=total, page=page, size=size), )
三个设计决定值得复述:输出模型嵌套(items 加 meta 的结构)让前端一次拿到数据与分页信息,不用读响应头;author_name 这类跨表字段的映射发生在构造处,输出模型保持扁平——前端消费简单,文档展示清楚;size 上限 100 在输入侧就限制了单页体积,输出侧的最大响应尺寸因此有了上界——输出契约的体积控制从输入参数开始,这是容易被忽略的联动。
对照 Flask 的典型实现(jsonify 里手拼字典、分页信息放响应头或 query 参数回显),功能等价,差异仍是老三样:结构定义在类型里可被文档消费、字段过滤有防线、新接口照抄模型树即可。当项目里有二十个列表接口时,这套模型树会被反复复制,每个复制品都继承全部保障。
⚠️ 补一个坑:response_model 指向嵌套泛型(如 Page 加 ArticleOut 的参数化)时,写法要用中括号参数化形式并确保子模型都已定义;把 list 直接写在装饰器里(response_model=list[ArticleOut])合法但放弃了外层结构——分页信息就没处放了。结构设计先行,模型跟着结构走。
常见问题速答
**问题:response_model 和直接返回 Response 实例冲突吗?**直接返回 Response 实例时 response_model 被跳过——这是设计好的逃生口,用于完全自定义的响应(二进制、特殊头)。但每个这样的接口等于退出了契约体系,文档不再反映真实响应。原则:能用 response_model 就用,逃生口留给真正无法建模的形态,并在接口描述里注明实际行为。
**问题:响应里需要动态字段(同接口不同条件返回不同字段)怎么办?**先质疑设计——消费方处理动态字段的成本远高于服务端。确有需求(聚合网关、面向前端的聚合层)时用字典返回放弃 response_model,或返回通用对象加文档说明。两个方案都失去输出校验,属于契约体系的有意降级,值得在代码注释里写明原因。
**问题:大响应(几万条记录)怎么处理?**三个动作按序:先分页(多数要全部的需求其实是没设计好分页);真要导出走流式(StreamingResponse 逐块产出,第 5 章后台任务配合生成文件加下载链接是更稳的形态);响应体上限在反向代理层配置(防异常场景的内存放大)。超过兆级的 JSON 响应几乎总有更好的形态。
**问题:HEAD 与 OPTIONS 请求要自己写吗?**不用,框架自动处理:HEAD 复用 GET 的处理器(去掉响应体),OPTIONS 由路由系统应答(CORS 预检另由中间件处理,见 4.3 节)。手动给它们写处理器是新手常见的多余动作。
本节要点回顾
- 输出契约:response_model 过滤字段、校验输出,敏感数据在出关口被丢弃,文档结构与运行行为同源。
- 三模型方案:输入、更新、输出各一个模型,exclude_unset 精确表达 PATCH 语义,安全边界画在类型上。
- 四形态:HTML、Redirect、File、Streaming 各有专属响应类;大文件用 FileResponse 的异步读盘,生成式输出用 StreamingResponse。
- 控制粒度三档:装饰器状态码、Response 参数注入、直接返回 Response,按需升级。
- 500 而非 422:输出校验失败是服务端错误,排错方向指向业务返回值与模型不符。
- 版本注意:别名与序列化参数在 v1 与 v2 里写法不同,迁移期统一约定避免混用。
正常输出讲完,下一节处理失败路径:错误如何分级表达、异常如何统一收口。
延伸与边界
响应体系有一条容易越界的线:序列化性能优化。当接口文档与契约稳定后,有人会为了微秒级收益绕开 response_model 手拼字典——除非测量证明序列化是瓶颈(第 7 章的方法论),否则这是用契约安全换看不见的收益。另一条线是输出模型的膨胀:接口演进中输出模型 tends to 长字段,长到二十个字段时消费方已经无人全用——定期审视输出模型,把没人消费的字段下线(先标注废弃、观察一段时间、再移除),是契约卫生的一部分。响应体系的三层机制(形态、契约、控制粒度)各自独立又互相配合,边界守得好,每一层都能长期保持简单。
值得最后强调的还有输出与输入的不对称性:输入模型可以严格(拒绝一切不合规矩的请求),输出模型必须诚实(如实反映业务状态)。新手常犯的错是把输出模型当第二个输入模型对待——加了过严的校验导致正常运行的数据被自己的输出防线拦下(500)。输出校验的意义是兜住程序错误(拼错字段名、类型漂移),不是复验业务规则——理解这种不对称,response_model 的 500 报错就有了清晰的解读框架。
场景练习
拿第 2 章写过的订单模型做三个输出设计练习。练习一:给创建订单接口配 201 状态码与输出模型(不含内部追踪号),验证文档的响应区出现 201 与字段表。练习二:给订单详情接口设计"含历史与不含历史"两个输出模型(同一 ORM 对象、两个视图),体会输出模型按消费场景裁剪的自由度——这正是输入模型给不了的灵活性。练习三:故意在输出模型里声明一个业务函数没返回的字段,观察 500 报错的信息指向,把这个报错的样子记进你的排错手册——它是输出契约问题最快的识别特征。三个练习合计半小时,做完后 response_model 对你而言就不再是"会写"而是"会调"。
顺带补一个团队协作细节:输出模型的字段变更应当走与接口变更相同的评审——哪怕只是一个字段改类型,对消费方都是破坏性变更。把输出模型文件标记为"高敏感区"(review 必到),是成本最低的契约治理动作。
最后重申一个容易在实战中淡忘的优先级:形态选择先于性能微调、契约完整先于字段精简、控制粒度从粗到细。响应侧的绝大多数线上事故(泄漏、格式漂移、字段误删)都源于跳级——为了性能绕过契约、为了灵活放弃模型。守住三级顺序,响应体系会一直保持"无聊的可靠",而无聊的可靠正是生产系统最好的性格。
- 出口的三级顺序:形态选择先于性能微调、契约完整先于字段精简、控制粒度从粗到细——跳级是响应事故的共同起点。