4.2 错误处理:HTTPException与全局异常处理器
4.2 错误处理:HTTPException 与全局异常处理器
FastAPI 的错误体系由三层构成:框架层的自动错误(422 校验失败、404 路由未命中)、业务层的 HTTPException(可控的业务失败)、全局异常处理器(兜底未预期异常与统一错误格式)。三层各管一段,合起来构成从"输入非法"到"代码 bug"的完整覆盖。本节逐层拆解并与 Flask 的 abort 与 errorhandler 对照。
本节能力目标
阅读完本节,你应当能够:
- 区分 404、422、401、403、409、500 各自的语义归属层次;
- 用 HTTPException 的 detail 携带结构化业务错误信息;
- 定义业务异常类并注册全局处理器,统一错误响应格式;
- 解释自定义异常处理器与依赖注入清理代码的协作时序;
- 搭建"HTTP 状态码粗分类 + 业务错误码细分类"的双层错误体系。
先把状态码的语义层次理清
错误处理混乱的项目,几乎都是状态码语义混乱的项目。一张归属表:
| 状态码 | 归属层 | 典型来源 | 客户端该做什么 |
|---|---|---|---|
| 404 | 框架 | 路由未命中或资源不存在 | 检查地址或放弃 |
| 422 | 框架 | 请求未过签名与模型校验 | 修参数重试 |
| 401 | 认证层 | 令牌缺失或无效 | 重新登录 |
| 403 | 授权层 | 身份有效但权限不足 | 不要重试 |
| 409 | 业务层 | 状态冲突(重复创建、并发修改) | 读最新状态再决策 |
| 500 | 兜底 | 未预期异常 | 稍后重试并报警 |
前两行由框架自动产生,后四行需要你在代码里显式触发。值得强调 409:很多项目把"业务规则不满足"一律塞进 400 或 500,前者让客户端无法区分"参数格式错"与"状态冲突",后者把可预期的情况伪装成事故。状态码是给程序看的控制流信号,不是给运维看的情绪指标。
HTTPException:业务失败的标准出口
from fastapi import HTTPException @app.post("/orders") def create_order(payload: CreateOrder, user=Depends(get_current_user)): sku = inventory.get(payload.sku) if sku is None: raise HTTPException(status_code=404, detail="商品不存在") if sku.stock < payload.qty: raise HTTPException(status_code=409, detail="库存不足") ...
HTTPException 的响应体是 {"detail": ...},detail 除了字符串还能放结构体(字典、列表),为业务错误码留了空间。与 Flask 的 abort 对照:abort(404) 只能给一句描述(abort(404, "msg")),想带结构化信息要 raise 自定义异常再配 errorhandler——能力等价,但 FastAPI 里"抛出即响应"是一等语法,Flask 里是异常体系的借道使用。
头部也能附加:HTTPException(status_code=401, detail="令牌过期", headers={"WWW-Authenticate": "Bearer"})——401 规范要求带上这个头告诉客户端认证方案,细节处见功底。
全局异常处理器:统一格式的收口
项目大了以后错误格式统一是刚需——前端要写一个通用的错误拦截器,格式不统一就得多重判断。标准做法是自定义异常加处理器:
from fastapi import Request from fastapi.responses import JSONResponse class BizError(Exception): def __init__(self, code: str, message: str, http_status: int = 400): self.code = code self.message = message self.http_status = http_status @app.exception_handler(BizError) async def biz_error_handler(request: Request, exc: BizError): return JSONResponse( status_code=exc.http_status, content={"code": exc.code, "message": exc.message}, )
业务代码里从此只需 raise BizError("ORDER_STOCK_SHORT", "库存不足", 409),响应格式由处理器一处保证。HTTP 状态码做粗分类(给重试逻辑与监控看),业务错误码做细分类(给前端交互看)——双层结构兼顾了协议语义与业务表达,比把一切塞进 200 加 body 错误码的"伪 REST"诚实,也比只用状态码的"纯 REST"表达力强。
兜底处理器处理未预期异常:
@app.exception_handler(Exception) async def fallback_handler(request: Request, exc: Exception): logger.exception("未处理异常", extra={"path": request.url.path}) return JSONResponse(status_code=500, content={"code": "INTERNAL", "message": "服务内部错误"})
两个要点:必须记完整堆栈(logger.exception 保留现场),对外只暴露最小信息——内部异常细节(SQL、路径、依赖版本)是攻击者的情报。Flask 的 errorhandler 装饰器在能力上对等(也能按异常类注册),迁移时主要工作是把散落的 abort 字符串升级成错误码体系。
处理器与依赖清理的时序
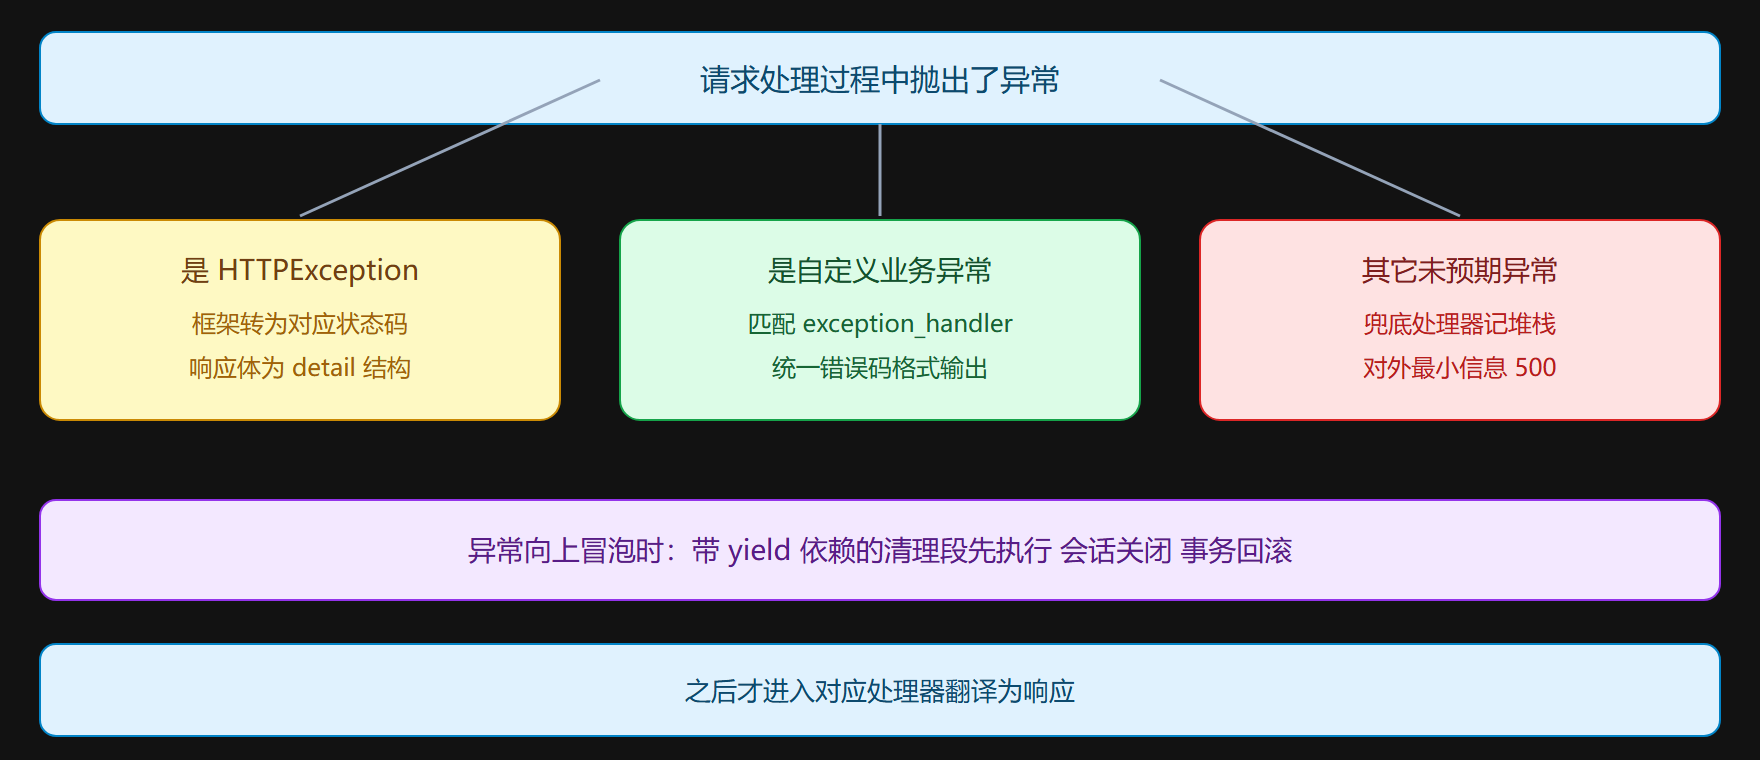
一个容易忽视的协作关系:路由抛出异常后,带 yield 的依赖的清理段(yield 之后的代码)会先于异常处理器执行。这个时序保证了"异常发生时会话必然被关闭、事务必然有回滚机会"——资源清理不依赖异常处理器的存在。推论也成立:如果你在依赖清理段里做事务提交,路由抛了 BizError 时事务不会提交,回滚语义自然成立。把数据库会话的提交与回滚放在依赖里、把错误翻译放在处理器里,两层各司其职——这是第 6 章数据库集成的标准架构,时序基础在此。
💡 关键直觉:错误体系的设计目标不是"少报错",而是让每一类失败都有确定的表达方式与确定的处理位置。确定性强了,前端敢写通用拦截器,监控敢按状态码配告警。
422 能定制吗
框架自动产生的 422 响应格式是固定的(detail 数组),想统一进自己的错误格式(比如外包一层 code 字段)可以注册针对 RequestValidationError 的处理器,拿到 exc.errors() 后自行组装。这是常见需求,但做之前想清楚代价:改掉 422 格式等于放弃与 OpenAPI 生态的错误约定,SDK 与工具链按标准格式写好的解析会失效。更稳的做法是保留 422 标准格式,业务错误走自己的 BizError 通道——两条通道语义不同,不必强行合并。
图示:一次异常的三条可能路径
迁移对照速查
从 Flask 迁移错误体系的对应关系:abort(404, msg) 对应 raise HTTPException(404, detail=msg);errorhandler(CustomError) 对应 exception_handler 装饰器注册的处理器函数;app.errorhandler(500) 的统一兜底对应针对 Exception 的处理器加日志。迁移时的升级机会恰好是两点:把字符串 detail 升级为错误码结构,把"一切皆 400"的旧习惯按语义表重新归位。
实战样本:给存量接口补一套错误体系
用一个迁移场景把本章机制走一遍。接手一个 Flask 老服务:全部错误都靠 abort(400, "各种中文消息"),前端为每条消息写了字符串匹配(脆弱至极),监控里 400 占比奇高但无从分类。改造分四步。
第一步,盘点错误场景并列语义表:凭据类(未登录、令牌过期、权限不足)、状态类(库存不足、订单已取消、重复提交)、资源类(不存在)、参数类(框架 422 已覆盖)。第二步,定义错误码命名规范:域名加场景的两段式(如 ORDER_STOCK_SHORT、AUTH_TOKEN_EXPIRED),错误码进代码常量不再散落字符串。第三步,实现 BizError 与处理器(本章正文的骨架原样可用),存量 abort 调用逐个替换——替换本身就是一次业务语义澄清,很多"400"替换时才发现应该是 409 或 403。第四步,前端联调切换:通用拦截器改为按 status_code 加 code 双键分发,消息文案从前端维护(后端只出稳定错误码)——从此改文案不动后端,多语言也顺带解决。
改造后的可观测性提升最直观:监控按状态码分布直接看出"认证失败与业务失败的比例",错误码维度能定位到具体场景的失败量——这些维度在清一色 400 的时代全部隐形。错误体系本质上是给失败建立的可观测结构,这也是它值得在项目早期就搭好的理由:晚搭的成本不是重写代码,是丢失了本可以积累的失败历史。
常见问题速答
**问题:自定义异常处理器里能改响应头吗?**能,返回的 JSONResponse 支持任意头——401 时补认证方案头就是这么做(正文示例已含)。但别在处理器里做业务补偿(回滚事务之类),那是依赖清理段的职责(时序一节讲过分工),处理器只负责翻译。
**问题:多个异常处理器,匹配规则是什么?**按异常类的继承距离——最具体的处理器优先。自定义异常族(业务异常基类下再分订单异常、支付异常)可以分层注册处理器,共享格式在父类处理器、特化格式在子类处理器。这套机制让错误体系的结构可以随业务演化而加密,不必一开始就设计完。
**问题:异常处理器里的日志怎么打才有效?**三个字段不可省:完整堆栈、请求标识(配合第 4 章访问日志对账)、异常的文本表示。只打出错了三个字的日志是排错时的噪音。另外兜底处理器的日志要与其他错误的级别区分(500 用错误级以上,业务 4xx 用警告级以下),告警规则才有干净的信号源。
本节要点回顾
- 语义分层:404 与 422 归框架、401 与 403 归认证授权、409 归业务状态冲突、500 归未预期事故,状态码是控制流信号。
- HTTPException:业务失败的标准出口,detail 可携带结构化错误信息,headers 可补充协议要求的头。
- 双层错误体系:HTTP 状态码粗分类配监控与重试,业务错误码细分类配前端交互,处理器一处保证格式。
- 兜底纪律:完整堆栈进日志,最小信息出响应;内部细节是攻击面。
- 清理时序:依赖的 yield 清理段先于处理器执行,事务回滚不依赖处理器存在。
- 422 慎改:保留标准格式换取生态兼容,业务错误走独立通道。
延伸与边界
错误体系有两条设计边界值得写在团队规范里。其一,错误码的粒度:码太少(一个"参数错误"包打天下)前端无法精确响应,码太多(每个字段每个场景一个码)维护成本失控——按"前端要有不同处理"的原则定码,处理相同的场景共用一个码。其二,错误的可观测契约:哪些错误进告警、哪些只进日志,应当在定义错误时就声明(严重级别的注释或元数据),而不是出事后逐个补——错误从诞生起就带着它的运维语义,这是错误驱动运维的起点。
另一条延伸指向分布式:跨服务的错误传播(上游的 409 到了网关层怎么聚合、错误码怎么跨服务命名空间)是微服务架构的新问题,本册的单服务错误体系是它的地基——单服务内语义清晰了,跨服务才谈得上映射与聚合。这个话题留给读者在架构升级时带着本册的分层思维去探索。
场景练习
两个巩固练习。练习一:给第 4.2 节的 BizError 体系补一个"限流异常"(429 状态码加重试间隔的响应头),验证自定义头能随异常一起返回——限流响应的标准形态就齐了。练习二:写一个总是抛零除错误的路由,观察兜底处理器的日志与响应(对外最小信息、对内完整堆栈),再写测试断言 500 响应体不含任何内部路径信息——这个测试就是你的信息泄漏防线,值得在每个项目里都放一份。
补一条与监控协作的实践:错误处理器的日志带上的请求标识,应当与第 4.3 节访问日志的请求标识同源——用户报障提供标识,运维用它在访问日志里找到那次请求的耗时与状态,再在错误日志里找到完整堆栈。一条标识串起三层日志,是"可追溯性"三个字的具体落地,也是错误体系与观测体系的接合点。
- 失败也是产品:错误体系的好坏用户直接可感——精确的错误码让前端给出准确的下一步,混乱的报错让用户重试到愤怒。
这套体系建成后的最大回报是心理的:报错不再令人烦躁,因为每类失败都有既定的表达与去处。
另附一条评审习惯:新接口的评审必问一句它的失败形态是什么——回答不出的接口,错误体系对它就是缺席的。