7.1 部署:uvicorn、gunicorn与容器化对比
7.1 部署:uvicorn、gunicorn 与容器化方案对比
生产部署的核心决策只有一个:谁来管理进程的生命周期。传统运维体系里答案是 gunicorn——它守护一组 uvicorn worker 进程,负责崩溃重启与优雅换代;容器体系里答案是编排器——每个容器跑单个 uvicorn 进程,重启、伸缩、发布全部上交 Kubernetes 或 Docker。本节给出两种形态的完整配置与选择理由,以及 worker 数量与连接池的联动规划。
本节能力目标
阅读完本节,你应当能够:
- 写出 gunicorn 加 uvicorn worker 与单进程容器两种形态的配置;
- 用 CPU 核数与利用率指标推算 worker 数量;
- 解释优雅重启的信号语义与零停机发布的条件;
- 区分存活探针与就绪探针的配置差异;
- 避免部署期最高发的三类配置事故。
形态一:gunicorn 进程管理器
传统虚拟机加 systemd 的环境里,gunicorn 是成熟答案:
gunicorn main:app \ -w 4 \ -k uvicorn.workers.UvicornWorker \ --graceful-timeout 30 \ --timeout 60
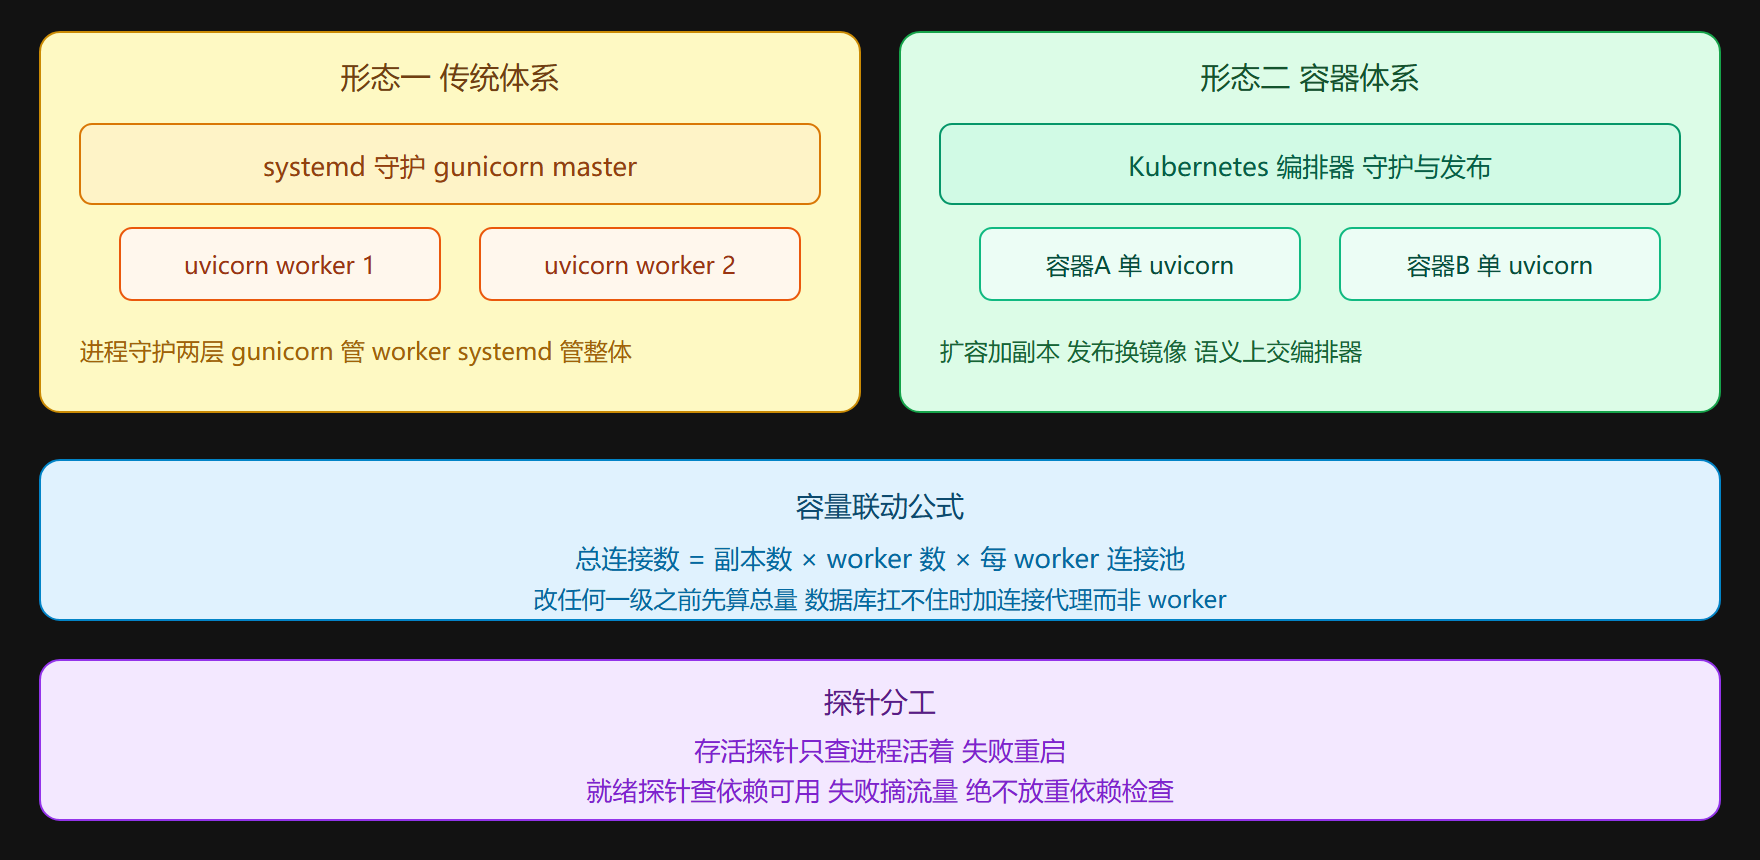
-k uvicorn.workers.UvicornWorker 让每个 worker 是一个完整的 uvicorn 事件循环进程;-w 4 是 worker 数量;graceful-timeout 控制旧 worker 处理完存量请求的宽限期。systemd 单元里 gunicorn 作为前台服务跑,崩溃由 systemd 拉起——进程守护有两层但职责清晰:gunicorn 管 worker 级、systemd 管整体级。发布时向 master 发 USR2 信号可以做双实例平稳切换,或简单粗暴地 graceful 重启(旧 worker 收 HUP 各自完成存量请求后退出)。
这套形态的适用判断:已有 systemd 或传统负载均衡的运维体系、发布频率不高、团队对容器无积累。它的问题在于配置散落——worker 数、超时、环境变量、日志轮转分布在不同层,新人上手要理解整套链条。
形态二:单进程容器
容器环境的最简形态:
FROM python:3.12-slim COPY requirements.txt . RUN pip install --no-cache-dir -r requirements.txt COPY . /app WORKDIR /app EXPOSE 8000 CMD ["uvicorn", "main:app", "--host", "0.0.0.0", "--port", "8000"]
一个容器一个进程,没有 gunicorn——进程守护上交编排器:容器退出即重启(重启策略)、发布即换镜像(滚动更新)、扩容即加副本(Deployment 副本数)。这符合十二要素应用的进程模型,也是各云厂商 Serverless 容器产品的默认预期形态。
镜像层面有几个实践要点:用 slim 基础镜像控制体积(alpine 在 Python 场景因 musl 的 wheel 兼容问题反而添乱,slim 是稳妥选择);依赖安装层与代码拷贝层分开(requirements 不变时命中构建缓存);CMD 用 exec 形态(JSON 数组)让 uvicorn 成为 PID 1 直接接收信号——shell 包装形态会吞掉 SIGTERM,优雅停机失效,这是容器化 Python 服务最高发的坑之一。
形态选择其实是在选"发布与守护的语义归属":让 gunicorn 加 systemd 承担,还是让容器编排承担。两者混用(容器里再跑 gunicorn 多 worker)多数时候是双重管理带来双重复杂度——例外是单容器想榨满多核又不想拆副本的过渡期,可以接受但要有迁移计划。
worker 数量:不是一个孤立数字
uvicorn 是单进程单事件循环,async 路由的并发能力在进程内已经很大;多 worker 的意义在于多核利用(每 worker 一个进程一个核)与进程级隔离(一个 worker 卡死不拖累其他)。推算起点:worker 数等于 CPU 核数,再按两个因素修正——任务偏 IO 等待可略减(事件循环利用率不高时多 worker 边际收益小);内存受限时必须减(每 worker 是完整 Python 进程,几百 MB 起)。
关键是第 6 章的联动公式的部署侧版本:总连接数 = worker 数 × 每 worker 连接池大小。4 worker 各配 10 加 5 的池,数据库侧要准备 60 连接的容量;扩到 8 worker 时数据库压力翻倍——数据库扛不住时该加的是连接代理(PgBouncer 类)而不是继续加 worker。Kubernetes 环境再叠一层:副本数 × 每副本 worker 数 × 池大小,三级相乘,改任何一级前先算总量。
优雅停机与探针
滚动发布的正确性依赖优雅停机链条:编排器发 SIGTERM → uvicorn 停止接受新请求 → 存量请求处理完(宽限期)→ 进程退出 → 编排器摘流量。配置上对应 terminationGracePeriodSeconds 要大于应用的最长请求处理时间;应用侧 uvicorn 默认行为已正确,别用 shell 形态 CMD 破坏它。
健康检查两探针分工:存活探针(liveness)失败触发重启——检查进程真活着(事件循环没卡死),用一个极简的根路径即可;就绪探针(readiness)失败只摘流量不重启——检查依赖可用(数据库 ping 得通)。就绪探针绝不能包含重型依赖检查——数据库抖动会引发全副本摘流量雪崩,这是配错探针的经典事故形态。FastAPI 侧对应两个端点:
@app.get("/healthz") def liveness(): return {"ok": True} @app.get("/readyz") def readiness(): ready = check_dependencies() if not ready: raise HTTPException(status_code=503, detail="依赖不可用") return {"ok": True}
⚠️ 常见部署事故三则:shell 形态 CMD 吞信号导致滚动发布时请求 502;就绪探针带重依赖检查导致雪崩式摘流量;忘了挂载配置或环境变量,容器用默认配置连上了测试库。三者的共同解药是把部署配置也纳入 review 与测试范围——部署是代码,不是运维的口头知识。
图示:两种形态的进程与守护结构
反向代理的位置
两种形态前面通常都有 Nginx 或云负载均衡:TLS 终止(证书与 HTTP/2 在外层终结)、静态资源直出(第 6 章的三级漏斗)、请求缓冲(慢客户端不直接占用应用 worker)、限流兜底。配置要点是代理超时要比应用超时长——外层 60 秒内层 55 秒的顺序才合理,反过来的结果是应用还在处理、外层已向客户端报 504。
一份可直接落地的检查清单
把本节内容收拢成上线前检查清单,照单执行:
- 进程形态:CMD 是 exec 形态(JSON 数组);容器内单进程,没有嵌套 gunicorn(或有,但有迁移计划)。
- 信号链路:本地验证 docker stop 后进程在宽限期内干净退出,无 502 残留。
- 容量三算:副本数 × worker 数 × 连接池 ≤ 数据库连接预算;worker 数与 CPU 核数匹配并有内存余量。
- 探针分工:liveness 只查进程、readiness 查关键依赖;readiness 的依赖列表经过裁剪,不含慢依赖。
- 超时顺序:外层代理 > 应用 > 数据库与下游,三级递减。
- 配置来源:全部环境变量注入,镜像里无明文密钥;配置缺失时启动即失败(fail fast)。
- 观测就位:访问日志(第 4 章中间件)、慢请求日志、池等待指标至少其一可达。
七个条目覆盖了本节全部事故案例的预防面。清单的价值不在条目本身,在于把部署从"运维口头传统"变成"可勾选的工程产物"——它可以进仓库、进 review、进 CI 检查,新人接手服务时按单走一遍就能建立完整心智。
常见问题速答
**问题:worker 数到底几合适,有没有公式?**起点是 CPU 核数(async 路由为主的服务甚至可以少一两个,把核留给系统与网络中断),修正项两个:内存上限(每 worker 数百 MB 起)与下游容量(worker 数乘池大小不超数据库预算)。更重要的是上线后看利用率——CPU 长期低于三成说明 worker 过多(浪费内存),高于八成说明该扩。数字是起点,观测是终点。
**问题:蓝绿发布与滚动发布选哪个?**滚动(逐个换实例)资源省但存在新旧共存窗口,要求接口向后兼容;蓝绿(双环境整体切换)无共存窗口但要双倍资源与快速回滚开关。数据库结构变更两者都要求先兼容后清理的两段式迁移(新增列先加、旧代码下线后再删)——发布策略的选择最终都会落到数据兼容性这个硬约束上。
**问题:配置变更需要重新发布吗?**环境变量注入的配置属于镜像外部,改配置重启容器即可,不必重建镜像——但要把哪些配置可以改完重启生效写清楚,避免改了配置以为生效了。真热加载(不重启生效)的配置走配置中心,那是另一套基础设施,中小项目用重启即生效的简单语义完全够用。
**问题:日志去哪了?**容器最佳实践是标准输出与错误流,收集与轮转交给编排层——进程内写文件与自管轮转是虚拟机时代的习惯,容器里既多余又容易丢。结构化格式(第 4 章访问日志的字段)让收集后的日志可查询,这一步的投入在排错时连本带利收回。
**问题:怎么验证优雅停机真的生效?**压测进行中触发一次滚动更新,观察两点:错误率有没有尖峰(有则信号链路有问题)、旧实例退出前的最后日志是不是处理完了存量请求。上线前做一次这个实验,比上线后在事故里学习便宜太多。
本节要点回顾
- 一个决策:部署形态的本质是选进程守护与发布语义的归属——gunicorn 加 systemd,或单进程容器加编排器,混用要有迁移计划。
- CMD 用 exec 形态:JSON 数组让信号直达 uvicorn,shell 包装吞 SIGTERM 是滚动发布 502 的头号原因。
- 容量三级相乘:副本数、worker 数、连接池联动,扩容前算总量,数据库侧的出路是连接代理。
- 探针纪律:存活查进程、就绪查依赖,就绪探针放重检查等于自造雪崩开关。
- 代理超时顺序:外层大于内层,504 的归属才清晰。
服务跑起来了,下一节让它跑得快:测量、定位、消除瓶颈的完整流程。
延伸与边界
部署话题的两条边界。其一,本册止步于单服务的部署——多服务的编排(服务发现、配置分发、灰度拓扑)属于平台工程的领地,但把单服务的部署语义(守护、健康、优雅、容量)想清楚后,多服务只是这些语义的网络化放大,概念没有新意只有组合。其二,Serverless 形态(按请求计费的函数托管)是单进程容器形态的极端化——冷启动替代了常驻、并发上限由平台托管,第 1 章对比过的部署光谱在这里补全:从 gunicorn 的进程组到函数实例,守护语义逐步上交,成本模型逐步按需——形态选择的背后始终是同一个问题:你想要多少控制权,愿意换多少省心。
写给不同背景的读者各一句:传统运维背景,容器不是威胁是工具,把 systemd 的守护直觉平移到编排器的探针与重启策略即可;开发背景,部署配置是代码,用 review 与测试对待它,别当"运维的事"旁观——上线的那一刻,你就是你自己服务的运维。
一个最小可行上线的完整清单
给独立开发者一个最小可行形态收尾:一台服务器、一个容器、一份 Nginx 配置——应用容器跑单进程 uvicorn,Nginx 终止 TLS 并代理,健康检查用存活探针的单端点,日志进标准输出由服务器收集,配置全走环境变量文件,域名证书用免费证书自动续期。这套形态的服务能力上限大约是每秒数千请求——对绝大多数个人项目与初创产品绰绰有余,而它的全部配置加起来不到五十行。从这套形态出发,第 7.1 节的每个升级路径(加 worker、加副本、上编排)都有明确的触发信号——先跑起来,按信号升级,这是部署话题最健康的节奏,也呼应了第 1 章选型与第 7.3 节结构的同一个哲学:匹配当前的量级。
- 部署是设计:守护、探针、优雅停机、容量三算都是可声明的工程产物——把部署配置当代码管理,服务的可靠就有了版本控制。