7.2 性能优化:定位同步阻塞的代价
7.2 性能优化:定位同步阻塞的代价
性能优化是一门测量优先的手艺:先建立基线,再单变量改动、回归对比,最后只保留被数据证明有效的改动。FastAPI 场景下三大高频瓶颈各有明确的指纹——事件循环被同步调用卡住、线程池被 def 路由排满、连接池被并发耗尽——本节给出逐一排查的手册,以及缓存与超时这两道最常被忽略的防线。
学习目标
阅读完本节,你应当能够:
- 建立可复现的基线测量流程并做单变量对比;
- 从现象指纹反推瓶颈类别(循环阻塞、线程池、连接池、下游);
- 用诊断端点或日志定位卡住事件循环的具体调用;
- 设计缓存与超时策略防止级联劣化;
- 识别三类"伪优化"避免浪费工程时间。
先立规矩:测量的三条纪律
没有基线的优化是玄学。三条纪律:基线可复现——固定并发模型(比如 50 并发持续 60 秒)、固定数据规模、多次取中位数,别拿一次手点刷新当依据;单变量改动——一次只改一个参数,改完重跑对比,改两个就说不清功劳归属;指标看分布——平均值掩盖长尾,P95 与 P99 才是用户体感,吞吐(每秒请求数)与延迟(分位数)一起看, traded-off 才完整。
测量工具从轻到重:开发期用并发命令行工具(ab、hey、vegeta 任一)够了;上线前用场景化脚本模拟真实流量比例;生产环境靠 APM 与慢请求日志持续观测。本节的所有结论都以"你有基线数据"为前提——下面每一条排查建议的输出,都应该是"改动前后两组数字的对比"。
三大瓶颈的指纹与排查
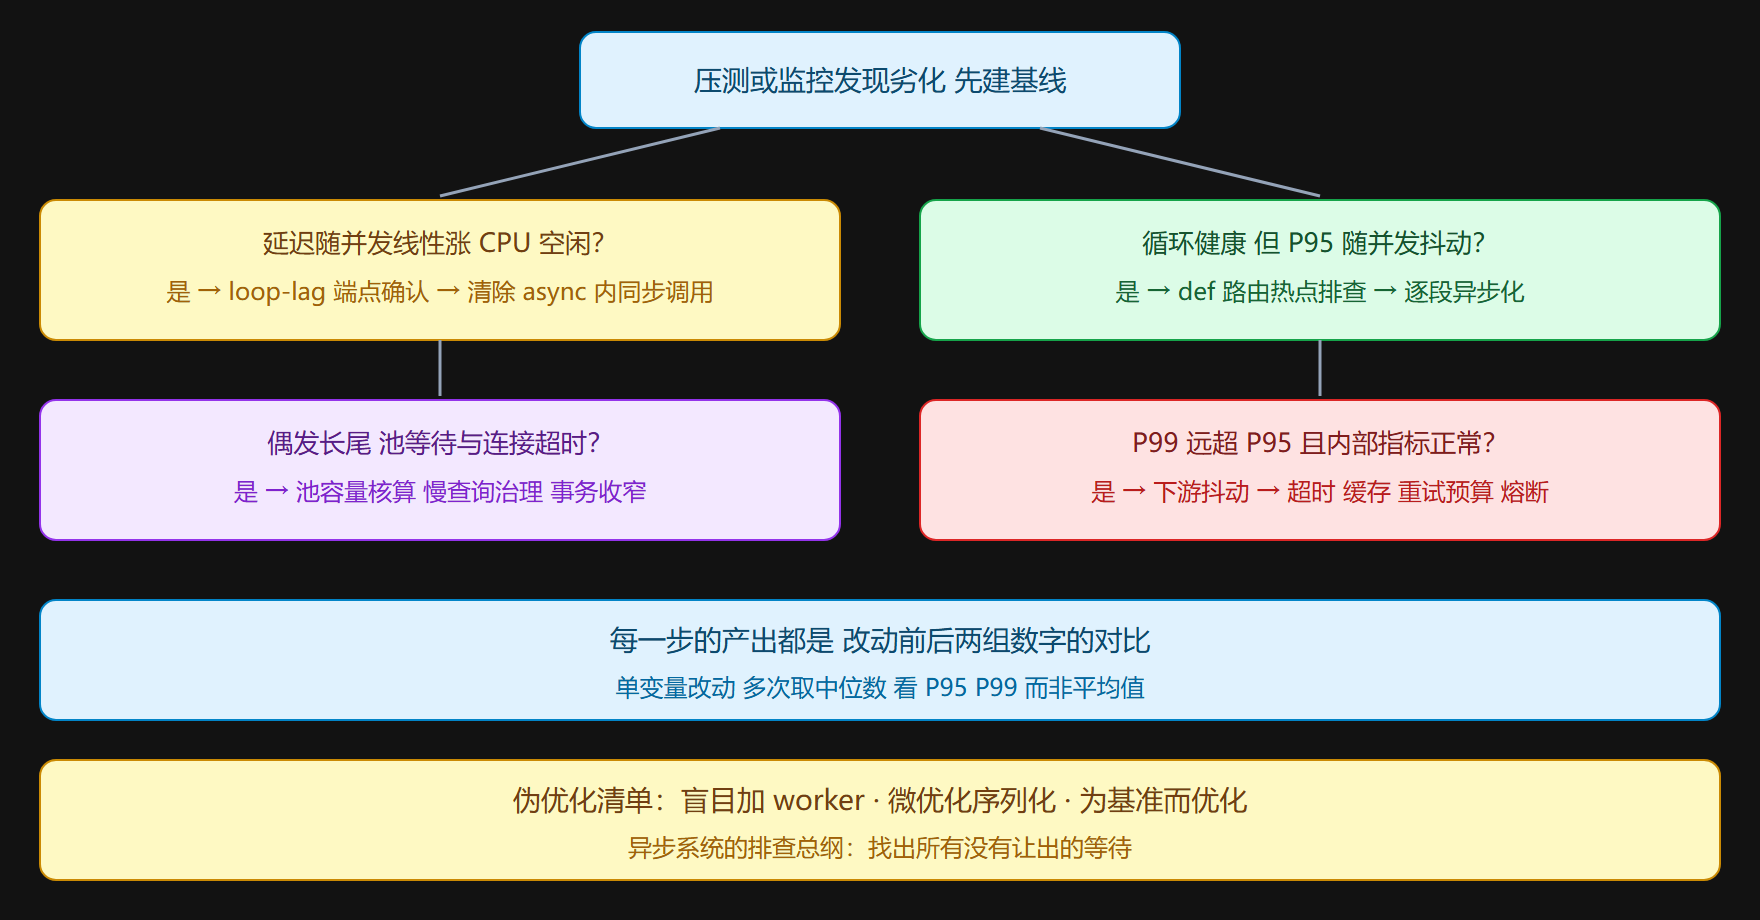
**指纹一:延迟与并发数线性劣化,CPU 利用率很低。**50 并发时 P50 是 1 秒、100 并发时变成 2 秒,而进程 CPU 几乎空闲——请求在排队等某个串行资源。头号嫌疑是事件循环被同步调用阻塞(第 3 章的反模式):async 路由里的 requests、time.sleep、同步 ORM。定位手段一:给可疑接口加计时日志,把总耗时与各步骤耗时打出来,定位到"某一步占 95%"。定位手段二:临时诊断端点测量事件循环的滞后:
import asyncio, time @app.get("/diag/loop-lag") async def loop_lag(): start = time.perf_counter() await asyncio.sleep(0) lag_ms = (time.perf_counter() - start) * 1000 return {"loop_lag_ms": round(lag_ms, 2)}
sleep(0) 让出后立刻回来,间隔就是循环被其他任务占用的时长——健康值在毫秒级以下,几十上百毫秒说明循环里有长阻塞。确认后按第 3 章修法处理:换异步客户端、改 def 路由进线程池、或把 CPU 重活拆到任务队列(第 5 章)。
**指纹二:并发一上 P95 就抖动,但 loop-lag 正常。**事件循环是健康的,排队发生在别处——查 def 路由的占比。线程池默认 40 线程,同步路由每请求占一个,第 41 个开始排队。确认方式:统计 def 与 async def 路由的调用量与耗时分布(访问日志按路由聚合即可),找出"高频加慢"的 def 路由,将其异步化(或至少把其中最慢的下游调用异步化)。线程池参数可以临时调大救急,但那是止痛不是治病——线程池撑并发的能力远弱于事件循环。
**指纹三:偶发的长尾请求,日志里出现池等待或连接超时。**连接池耗尽的典型形态(第 6 章警示过):不是稳定慢,是随机慢——赶上池满就排队。核对三个数字:池大小 × worker 数 vs 数据库最大连接;慢查询是否长期占着连接(一条 10 秒的慢查询等于占用 10 秒的池容量,慢查询治理往往是连接池治理的前置);事务是否意外变长(在事务里调外部接口、发邮件,是经典的"事务里做闲事"反模式,把事务边界收窄到数据库操作本身)。
**指纹四:P99 远高于 P95,且与应用内部指标无关。**查下游与外部调用——第三方接口的偶发抖动直接透传给你的用户。解药在"防护"一节:超时、缓存、重试预算。
防护两件套:缓存与超时
缓存的正确顺序是从外到内:CDN 与反向代理缓存(静态与半静态响应,第 6 章)、应用内缓存(热点数据的字典缓存加 TTL,数据库读压力的泄洪闸)、数据库自身的查询缓存。FastAPI 侧的应用内缓存惯用依赖实现——缓存依赖包裹数据源依赖,命中即返回,天然可挂载可覆盖(第 3 章的机制复用)。缓存的三条纪律:写场景慎缓存(失效逻辑的复杂度常超收益)、TTL 必须有(无 TTL 的缓存是内存泄漏加数据陈旧的合体)、命中率要观测(低于两成的缓存只是在增加代码复杂度)。
超时是防止级联劣化的防火墙:每个外部调用(数据库、第三方、缓存)都要有显式超时,且应用层超时小于外层代理超时(第 7.1 节的顺序原则)。没有超时的系统里,一个下游的故障会以"所有请求挂起"的形态传染全站——线程池或连接池被无限等待的请求占满,健康检查也拿不到资源。超时加有限重试(预算式:窗口内最多 N 次,防雪崩)加熔断(连续失败后快速失败一段时间),三件套是高可用服务的标配,FastAPI 层面用依赖或中间件封装成横切能力(第 3、4 章的机制再次复用)。
三类伪优化
**盲目换服务器或加 worker。**吞吐不达标就加 worker 数,若瓶颈在连接池或下游,加 worker 反而加速耗尽下游——容量三级联动的反向版(第 6 章)。先定位再扩容。
**过度微优化序列化。**Pydantic v2 已经把校验与序列化的热路径做到 Rust 层,典型 Web 应用的耗时大头在网络与数据库;为了再快一点手写 ujson 替换序列化器、绕过 response_model 手拼 dict,收益微毫计,丢掉的是输出契约的保障(第 4 章的泄漏防线)。只有在纯序列化吞吐型服务(日志管道、网关聚合)里这件事才值得排上日程。
**为基准测试而优化。**单接口压测满分、真实流量组合下依然劣化——因为真实负载是混合的(读写比例、热点分布、慢用户连接)。基准是优化的指南针不是 KPI,按真实流量形态构造测量场景,结论才可信。
一次完整的优化会诊记录
用一个综合案例把流程走完。现象:订单列表接口高峰期 P99 达 4 秒,投诉集中在傍晚。基线测量:50 并发持续压测,P50 200 毫秒、P95 1.5 秒、P99 4.1 秒——分布严重长尾,P50 与 P99 差二十倍,指向"偶发排队"而非"整体慢"。
排查一:loop-lag 端点高峰期实测 3 毫秒,事件循环健康,排除同步阻塞。排查二:访问日志按路由聚合,发现该接口是 async 路由,线程池排队不适用,排除。排查三:慢查询日志里一条按状态过滤的查询占多条记录、平均 900 毫秒——索引缺失(status 列无索引,全表扫描),连接被慢查询长期占用,高峰期池排队。修复:加索引,慢查询降到 15 毫秒。回归测量:P99 降到 380 毫秒。后续加固:给该查询加 3 秒超时(防未来的慢查询拖垮池)、池等待指标接入告警(下次劣化先告警后排障)。
这次会诊的路线完全按本章指纹表走:长尾 → 排除循环 → 排除线程池 → 命中连接池与慢查询 → 修复后加防护。没有一步靠猜,每一步都有数字进出——这就是测量优先的完整形态。
💡 关键直觉:异步框架的默认状态是"快",出问题的几乎都是"混进了同步的东西"——阻塞调用、同步路由热点、池等待、下游无超时。排查性能问题的思路因此可以极简:找出系统中所有"没有让出的等待",逐个处理。
图示:瓶颈排查决策树
常见问题速答
**问题:什么时候该引入链路追踪系统?**日志加指标能定位八成问题;剩下的两成(跨服务调用链、方法级热点)才是它的主场。触发信号:问题涉及多个服务、日志对不上时间线、单服务内部找不到热点。接入成本不低(侵入、采样、存储),中小团队先用满日志与指标再加。
**问题:压测环境怎么搭才可信?**三个要求:数据量级接近生产(百万行表与百行表的查询计划不同)、下游依赖有替身(真实第三方压不得,用可编程的假服务模拟延迟)、网络路径接近(同机房与跨区的延迟差会改变结论)。做不到三点时,把压测结论当作方向参考而非容量承诺。
**问题:缓存命中率多少算健康?**看场景:配置类数据应到九成以上,列表页六到八成正常,写多读少的场景三成也可能划算。孤立的百分比没意义,配对的数据才有——命中率加该接口的数据库查询量下降幅度,一起看才知道缓存挡掉了什么。
本节要点回顾
- 三条纪律:基线可复现、单变量改动、看分位数不看平均——没有数字对比的优化是猜。
- 四个指纹:线性劣化查循环阻塞、P95 抖动查线程池、偶发长尾查连接池与慢查询、P99 尖刺查下游。
- loop-lag 端点:sleep(0) 的往返延迟是事件循环健康度的最廉价指标。
- 事务收窄:事务里调外部接口是池耗尽的隐形推手,边界收到数据库操作本身。
- 防护三件套:显式超时(外大于内)、预算式重试、熔断——防的是级联劣化不是单点故障。
- 总纲一句话:找出所有没有让出的等待,逐个处理。
延伸与边界
性能话题的边界要诚实:本节的排查手册针对应用层可见的瓶颈——事件循环、线程池、连接池、下游依赖。基础设施层的瓶颈(网络带宽、磁盘 IO、数据库服务本身)需要另一套工具与权限,发现"应用层全部健康但用户仍然慢"时,排查要下沉到基础设施——这本身就是一个有价值的结论(问题不在你这层)。另一个边界是成本意识:性能优化的投入要与收益定价,每秒十万次调用的热点接口值得三天优化,每天一百次调用的管理接口不值得半小时——第 1 章按量级选型的思维在优化上同样成立。
延伸一条给进阶者:建立服务的性能档案——关键接口的延迟基线随版本演进的记录、历次优化的前后数据与归因,这份档案在容量规划(第 7.1 节)与故障复盘(性能突变的对比基线)两处都会变现。性能工程做到最后,拼的不是技巧存量,是数据的存量。
- 测量先于信念:每个优化决定背后应当有两组数字——没有基线与对比的动作不叫优化,叫占卜。
那张排查决策树值得打印出来贴在工位——性能事故的时刻没人有心情翻教程,但人人看得懂一张树。
附一条团队实践:把每次会诊记录归档成性能事故本,半年后它就是团队最值钱的内部文档——没有之一。