7.3 项目结构:分层组织的对比与选型
7.3 项目结构:分层组织方式的对比与选型
项目结构的选择标准是"团队规模与代码量到了哪一步",而不是"哪种更先进":平铺单文件适合原型与学习,按资源分文件适合小团队, routers 加 services 加 repositories 的分层适合多人协作与复杂业务。结构没有银弹,但每一档的升级时机与代价可以说清楚。本节对比三档结构,并给出配置管理、模型归位、路由聚合的组织原则。
本节能力目标
阅读完本节,你应当能够:
- 判断当前项目该停在哪一档结构,识别升级信号;
- 用 APIRouter 按资源组织路由并统一前缀与标签;
- 设计配置的分层加载(默认值、环境变量、密钥注入);
- 说明 models、schemas、deps、services 各归什么文件;
- 避免过早分层与过晚重构两种结构病。
三档结构对比
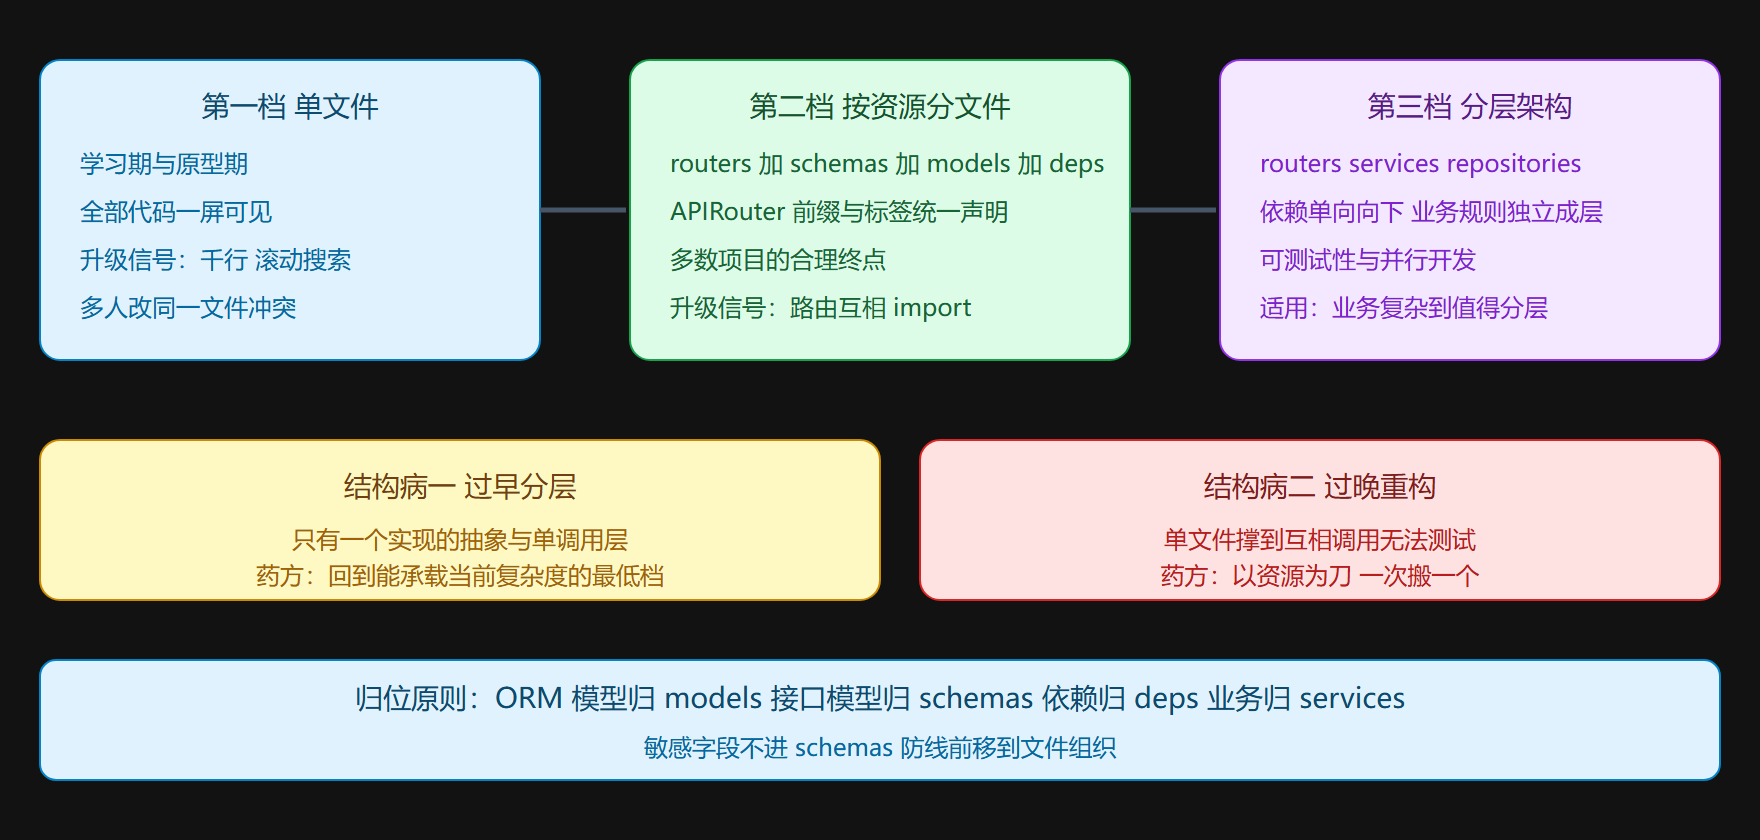
**第一档:单文件。**第 1 章到第 5 章的示例都是这个形态——一个应用文件装下全部路由。它的价值不该被轻视:学习期与原型期,所有代码在一屏内可见、依赖关系零跳转。升级信号:文件超过千行、找一段路由要滚动搜索、两个人同时改产生冲突——出现两条就可以进第二档。
第二档:按资源分文件。
app/ main.py 应用工厂与挂载 routers/ 按资源划分的路由模块 schemas.py 全部 Pydantic 接口模型 models.py 全部 ORM 模型 deps.py 公共依赖(会话、认证) config.py 配置
路由用 APIRouter 组织:
from fastapi import APIRouter router = APIRouter(prefix="/orders", tags=["订单"]) @router.post("") def create_order(...): ... @router.get("/{order_id}") def get_order(order_id: int, ...): ...
main 里 include:
app.include_router(orders.router) app.include_router(users.router)
prefix 与 tags 让路径与文档分组一次声明(第 6 章的标签组织在此落地)。这一档支持到十几人团队、几十个接口,是多数项目的合理终点。升级信号:schemas 或单个路由文件再次膨胀、跨资源的业务逻辑开始在路由里互相 import、新人说不清改一个功能要动哪几个文件。
**第三档:分层架构。**routers(HTTP 边界:参数声明、调服务、组装响应)→ services(业务规则:事务边界、领域逻辑,不认识 HTTP)→ repositories(数据访问:查询与持久化,不认识业务)。加上 domain 或 models 加 schemas 分目录,依赖方向单向向下。它的收益是可测试性(服务层不依赖 TestClient 即可测)与并行开发(接口定义清楚后各层并行);代价是文件数量翻倍、简单功能要跨三层跳转。只有业务规则复杂到值得单独成层时才付这个代价——CRUD 占九成的服务强行三层,得到的是仪式感不是工程质量。
对照 Django 的"约定式"结构(框架指定 app 与文件名):FastAPI 没有约定,结构自由度是遗产也是责任——团队要自己形成并记录约定。这份自由的价值在于:微服务里的小服务可以永远停在第一档,不用拖着三层目录的空壳。
配置管理:三段式加载
配置是结构问题里事故率最高的部分,标准解法是三段式:默认值、环境变量覆盖、密钥单独注入。
from pydantic_settings import BaseSettings class Settings(BaseSettings): app_name: str = "订单服务" database_url: str = "postgresql+asyncpg://localhost/app" debug: bool = False jwt_secret: str model_config = SettingsConfigDict(env_file=".env") settings = Settings()
Pydantic 家族的 settings 库让配置本身也是强类型模型——错误的环境变量在启动时就报错,而不是在某个深夜的请求里。三条纪律:密钥永不进代码库(jwt_secret 无默认值,缺失即启动失败,这是故意的);环境差异全部走环境变量,代码里不出现 if 生产环境 这样的分支;配置对象单例注入(模块级实例或依赖提供),拒绝散落的 os.getenv 调用——后者的类型与来源无法审计。
归位原则:每样东西放哪
模型双轨的文件化(呼应第 6 章):ORM 模型放 models(存储结构),Pydantic 接口模型放 schemas(对外契约),两边字段靠服务层的转换函数衔接——敏感字段与内部字段永远不进 schemas,泄漏防线从运行时(response_model)前移到文件组织。依赖放 deps:会话依赖、认证链(第 5 章)、分页参数(第 3 章),路由从 deps import,测试从 deps override(第 5 章)——依赖是测试与生产的换轨点,集中存放让换轨成本最低。服务层(第三档才有)承接业务规则与事务边界,路由只做"翻译":HTTP 进、领域调用、HTTP 出。
路由文件内部的组织习惯值得统一:每个资源文件按"模型 → 辅助函数 → 路由"的顺序排列,路由按方法序(GET 列表、GET 单个、POST、PUT、DELETE)排列——review 时可预期、跳转时可预判,这类小约定是团队效率的隐形组成部分。
两种结构病
过早分层:三个人以下的项目上三层架构加接口抽象,每次改需求的文件跳转成本超过收益,抽象层里塞满了只有一个实现却要维护签名的"接口"。药方:删掉只有一个实现的抽象,合并只被一处调用的层,回到能承载当前复杂度的最低档。
过晚重构:单文件撑到五千行、路由依赖全局变量互相调用、测试无法隔离——结构债的利息以 bug 率与交付速度支付。药方:以"资源"为刀切分(一个资源的路由、模型、依赖整体搬走),一次切一个资源、测试护航,两周内可完成第二档迁移——结构重构的最小可行单元是资源,不是层。
从第二档到第三档:一次真实的演进记录
记录一个五人团队的演进,作为两档之间过渡的实例。起点:第二档结构运行一年,routers 目录七个文件,schemas 单文件已两千行。触发事件:订单改价需求横跨三个路由文件,业务逻辑(改价规则、审计、通知)写在路由里,测试要构造完整 HTTP 上下文——交付延期三天,决定进第三档。
迁移分三步。第一步立契约:services 层的接口先以空实现加类型签名铺开(订单服务、库存服务、通知服务各一个类),路由改调服务——此时业务逻辑还在路由里,只是转发。第二步搬逻辑:按资源逐个把路由体里的业务段搬进服务方法,每搬一个资源跑全量测试(第 5 章的分层在这里兑现价值:路由单测保行为不变)。第三步收尾:schemas 按资源拆分成包,repositories 从服务里的查询代码提炼。全程两周,期间正常需求未停——渐进式迁移的关键是每一步结束系统都是可发布的,没有长期分支、没有一次性大合并。
迁移后的收益在三个月后显形:新需求"批量改价"直接写服务层测试与实现,路由只加了一个薄壳——因为业务规则已经集中在服务层,新接口是"暴露已有能力"而不是"重新实现规则"。这就是结构投资的回报形态:不是立刻变快,而是让下一批需求变快。
图示:三档结构的演进与升级信号
常见问题速答
**问题:结构要不要一次到位上第三档?**不要。第三档的成本(文件跳转、抽象维护)在业务复杂度上来之前是纯支出。但可以在第二档里预埋条件:路由函数保持薄(业务逻辑集中在一个函数体内而非散落),未来搬进服务层时是整块平移而不是考古挖掘。预埋的成本几乎为零,值得养成。
**问题:多环境(开发、测试、生产)的配置文件怎么组织?**环境变量为主(正文三段式),环境差异全部外置。惯例是本地开发允许一个环境文件(加进忽略清单防泄密),持续集成与生产全靠注入。想给新人一键起环境,用容器编排的样例文件(含默认值)而不是往代码库里塞真实配置。
**问题:通用工具目录该怎么控制?**反模式预警:工具目录是不知道放哪就放这的杂物抽屉,长开后什么都有、谁都依赖它。规则化替代:按用途命名(日期、分页、序列化各一个小模块),每个模块职责一句话能说清;说不清的就该重新归位。通用目录的膨胀速度是结构健康度的反向指标,月度看一眼。
本节要点回顾
- 三档递进:单文件 → 按资源分文件 → 分层架构,升级信号分别是文件膨胀与冲突、路由互相 import 与业务逻辑无处安放。
- APIRouter:prefix 与 tags 一次声明,路径与文档分组同源;include_router 组装应用。
- 配置三段式:强类型 Settings、密钥无默认值强制显式注入、环境差异全走环境变量。
- 归位原则:双轨模型分文件、依赖集中供测试换轨、服务层承接事务边界——文件组织是运行时防线的静态前移。
- 两种结构病:过早分层删冗余抽象,过晚重构以资源为刀逐个搬迁。
- 结构无银弹:微服务里停在第一档不是落后,是匹配复杂度的正确选择。
结构定形,最后一节收束全册:如何与官方生态同步地持续深入,避免被过时资料带偏。
延伸与边界
结构话题的边界:本册谈的是单服务的内部结构——多服务的划分(按业务能力拆、按数据归属拆)是架构层的课题,但判据同源(第 1 章的量级匹配、第 6 章的职责归属),学过单服务的结构演进再去理解服务拆分,会发现是同一把刀在不同尺度的挥动。另一个易忽略的边界是结构文档化:三档结构各自都有"新人第二天能改对文件"的标准,但达到标准靠的不是结构本身而是一份简短的结构说明(哪个目录放什么、改动走什么路径)——结构是约定,约定要落纸。
延伸给成长中的团队:当结构演进的讨论开始每周出现时,是引入架构决策记录的时机——每次结构变更留一页纸(背景、选项、决定、后果),半年后回看这些记录,团队的架构判断力会显形为可传承的资产。结构管理的终点不是完美的结构,而是健康的演进能力。
补一段结构与测试的呼应:第 5 章的测试分层对结构选择有反向检验力——如果你的路由单测必须连数据库才能跑,说明数据访问没有从路由里分离;如果改一个小需求要动五个文件,说明模块边界切错了位置。测试的痛感是结构问题的放大器,比任何架构评审都诚实。团队可以把"新接口的测试好不好写"当作结构健康的日常指标:好写说明分层干净,难写说明耦合超标——用测试当结构的体温计,结构病会在早期而非晚期被发现。
- 结构服务于变化:好结构的检验标准不是当下的整齐,而是下一次需求来时改动落在几个文件——为变化留余地是组织的全部目的。
结构话题的最后一句仍然是那句老话:匹配当下的量级,为可预见的增长留缝,其余交给重构。
附一个自查动作:每季度花十分钟数一数最大文件的行数与目录里的文件数,两个数字的走势就是结构健康的年轮,连续两季恶化就该启动一次有计划的重构。