1.1 从MapReduce到Spark:中间结果的搬家史
1.1 从 MapReduce 到 Spark:中间结果的搬家史
本节摘要:Spark 诞生的动机,是消灭 MapReduce 引擎里反复落盘的中间结果。本节从执行引擎视角对比两代计算模型每一步把数据放在哪,解释内存计算、DAG 调度与惰性求值如何合力把"磁盘税"降到最低,并给出代价与边界。
一次 MapReduce 作业在引擎里发生了什么
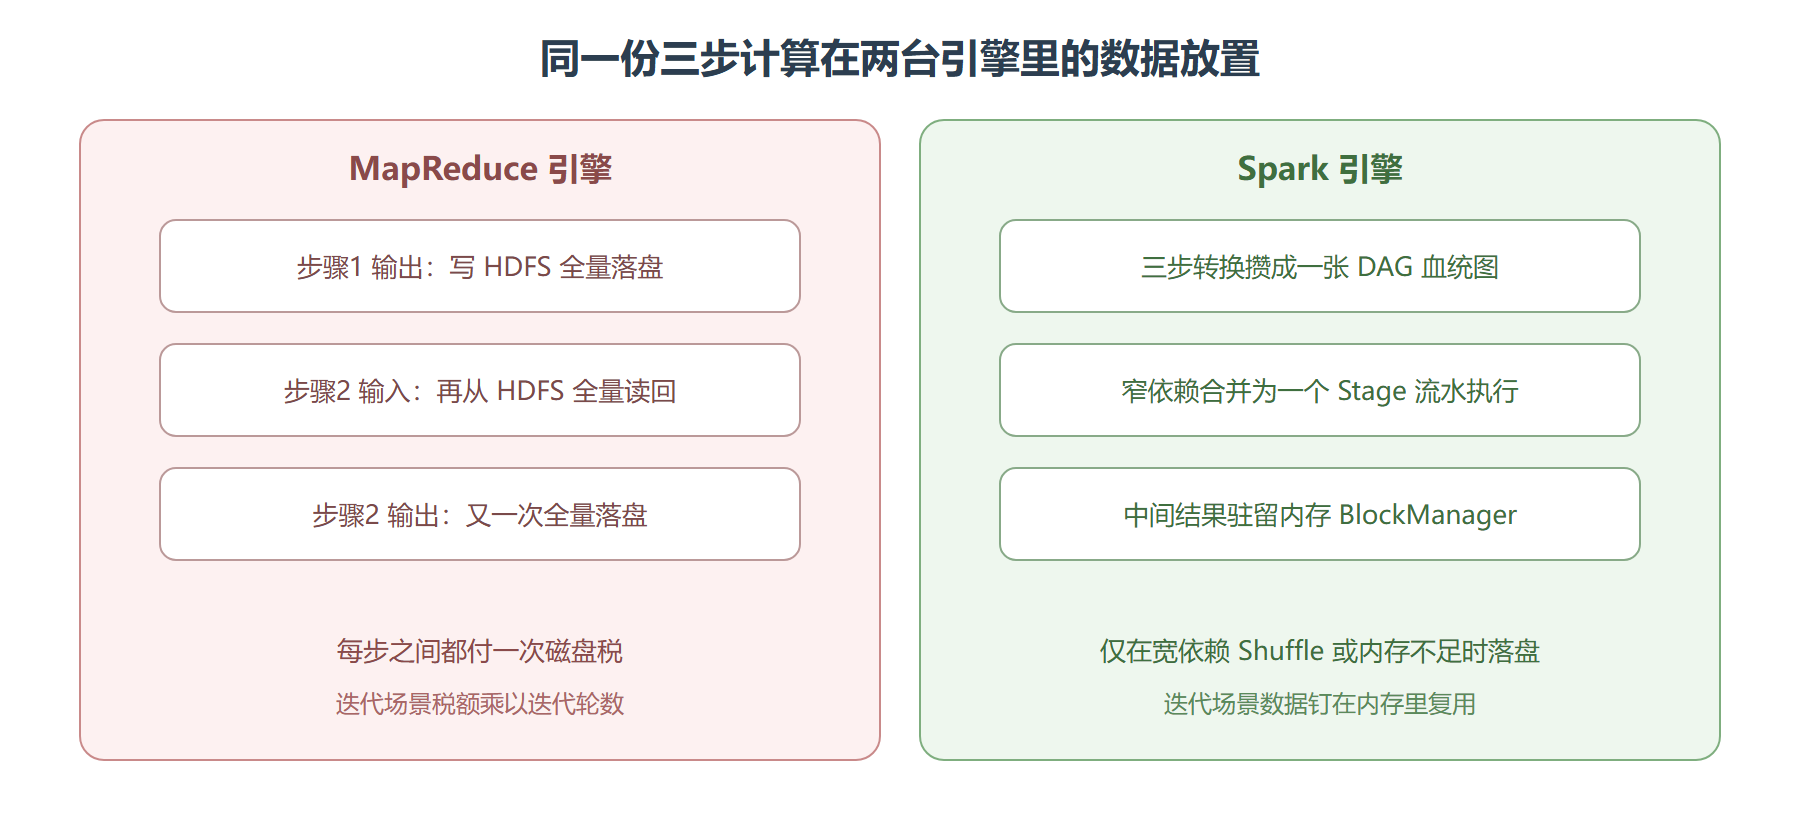
老引擎的执行模型是严格的两段式:Map 阶段读输入、写出中间键值对到本地磁盘;Reduce 阶段再从各台机器的磁盘上把属于自己的分片拉过来(这一步叫 shuffle 拉取)。哪怕链两个作业——比如先聚合再排序——第一个作业的输出也必须完整落进 HDFS,第二个作业再完整读出。
巡检这台老引擎,日志里的瓶颈非常典型:CPU 利用率低,磁盘 IO 与网络 IO 打满。计算只占几分钟,剩下的时间数据都在路上。
Spark 改了三处记账规则:
- 中间结果优先驻留内存,放不下才溢写磁盘( spills ),由 BlockManager 统一登记。
- 多阶段算子先攒成 DAG,行动算子触发时统一编译,能合并的窄依赖合并进同一个 Stage,一次流水线执行。
- 惰性求值:转换算子只记血统不执行,引擎因此能看到全局,做老引擎做不到的整体优化。
两代引擎中间结果放置对比
动手验证:惰性求值不是偷懒
from pyspark.sql import SparkSession spark = SparkSession.builder.appName("EngineTour").master("local[*]").getOrCreate() sc = spark.sparkContext rdd = sc.parallelize(range(1, 1000000)) mapped = rdd.map(lambda x: x * x) # 什么都没发生,只登记了一条血统 filtered = mapped.filter(lambda x: x % 7 == 0) # 仍然没发生 print(filtered.toDebugString().count("\n")) # 打印血统深度前先数层数 print(filtered.count()) # 行动算子触发:此刻引擎才编译并执行
toDebugString 输出的每一行都是一条血统边。在 count() 之前,集群上没有任何一个 Task 被派出;count() 一到,引擎把整条链压进尽量少的 Stage 一次性执行。这就是"引擎看全局"的直接证据。
工程取舍
内存驻留不是免费的。缓存的数据会挤占执行内存(第 6 章的内存配比会展开);血统过长则单分区重算代价大,需要 checkpoint 截断。我的习惯:迭代型作业显式缓存每轮输入,纯 ETL 作业一律不缓存——后者每个分区只被消费一次,缓存纯属浪费。
# 血统过长时的截断手段:checkpoint 把"怎么算"换成"算好的快照" sc.setCheckpointDir("ckpt-events") hot = filtered.checkpoint() # 此刻触发一次真正的计算并落可靠存储 # 之后 hot 的血统从这条边截断,任何重算不再回溯到源数据
⚠️ 常见坑:把 Spark 当"更快的 MapReduce"来写,每个阶段后立刻落 HDFS 再读回来。引擎精心设计的内存通路被这种写法整段绕开,性能退化回老引擎,还多占了一份存储。
迁移视角:老代码搬进新引擎要改什么
把一套 MapReduce 作业链迁到 Spark,改动的不是语法而是结构思维。老引擎的每个作业是独立程序,链式逻辑靠"上一个作业的输出目录"衔接;新引擎里该把它们写成同一个 SparkSession 内的连续转换,让中间结果以 RDD 形态留在内存——如果迁移后每个阶段仍然落盘再读,等于换了引擎没换用法,性能收益几乎为零。巡检迁移质量有个粗暴指标:数作业里 HDFS 写入的次数,数一次心疼一次,理想状态下整个链路只在最终结果处写一次。
另外两代引擎对"组合"的表达力差异值得体会。MapReduce 想做过滤后再聚合,必须串两个作业、两次落盘;Spark 里 filter 接 reduceByKey 是同一份血统上的两行代码,引擎自行决定把它们压进哪些 Stage。表达力的背后是调度自由度——作业边界的决定权从程序员手里交给了引擎,这正是第 2 章 Catalyst 还会继续加码的方向。
历史脉络补一笔也有助于建立坐标:Spark 出自加州大学伯克利分校的 AMPLab,2010 年开源、2013 年捐给 Apache,论文里最著名的一张对比图就是迭代任务上比 MapReduce 快一到两个数量级——那批实验的关键设定正是"数据装入内存后反复消费"。换句话说,Spark 的成名作不是"算得快",而是"不算第二遍",理解了这一点,后续章节里缓存、检查点、微批的所有设计动机都有了共同出处。
给一个可自查的迁移练习:找一个现成的两段式 MapReduce 作业(或伪代码),在纸上改写成 Spark 版——先把两段合并成一份血统,再标出唯一的 Stage 边界,最后决定中间结果要不要缓存。三步都画得出来,说明"内存计算"对你是可操作的工程事实而不只是口号;画不出来,回头把血统与宽依赖两段再读一遍。练习的参考答案可以在本节开头的对比图里对勘——两代引擎的分水岭恰好落在中间结果的存放位置这一格上。往后每一章的优化议题,几乎都能还原成"这次把搬运成本挪到了哪"的同款追问,保持这个追问习惯,全册就有了主线。引擎的历史还会在后面几章反复回声,届时你会认出每一次改进都在回答同一个老问题:数据该放在哪、算力该怎么贴过去。
本节要点回顾
- 磁盘税:MapReduce 的核心开销是阶段间全量落盘再读回,迭代场景按轮数放大
- 三处改动:内存驻留、DAG 统一编译、惰性求值,共同构成 Spark 引擎的提速基础
- 血统即账本:引擎记录"怎么算"而非"存在哪",这是容错与优化的共同根基
- 边界仍在:宽依赖 Shuffle 与内存不足时,数据依然落盘——引擎不是魔法