1.2 RDD:引擎记账的基本单位
1.2 RDD:引擎记账的基本单位
本节摘要:RDD(弹性分布式数据集)是 Spark 引擎的记账单位——不可变、可分区、带血统的分布式数据抽象。本节从执行视角拆解 RDD 的五个属性,用分区实验观察 Stage 划分与宽窄依赖,并讲清缓存、持久化级别与血统重算的配合关系。
引擎眼里的 RDD 长什么样
写代码时 RDD 像一个集合;在引擎眼里它是一张登记卡,五个字段:分区列表、每个分区的计算函数、依赖列表(指向父 RDD)、可选的分区器、可选的优先位置。真正被"物化"的只有分区数据本身,其余四项全是元信息。血统重算的底气来自依赖列表:丢了哪个分区,就沿依赖边把那个分区的计算函数重跑一遍。
依赖分两类,直接决定执行形态:
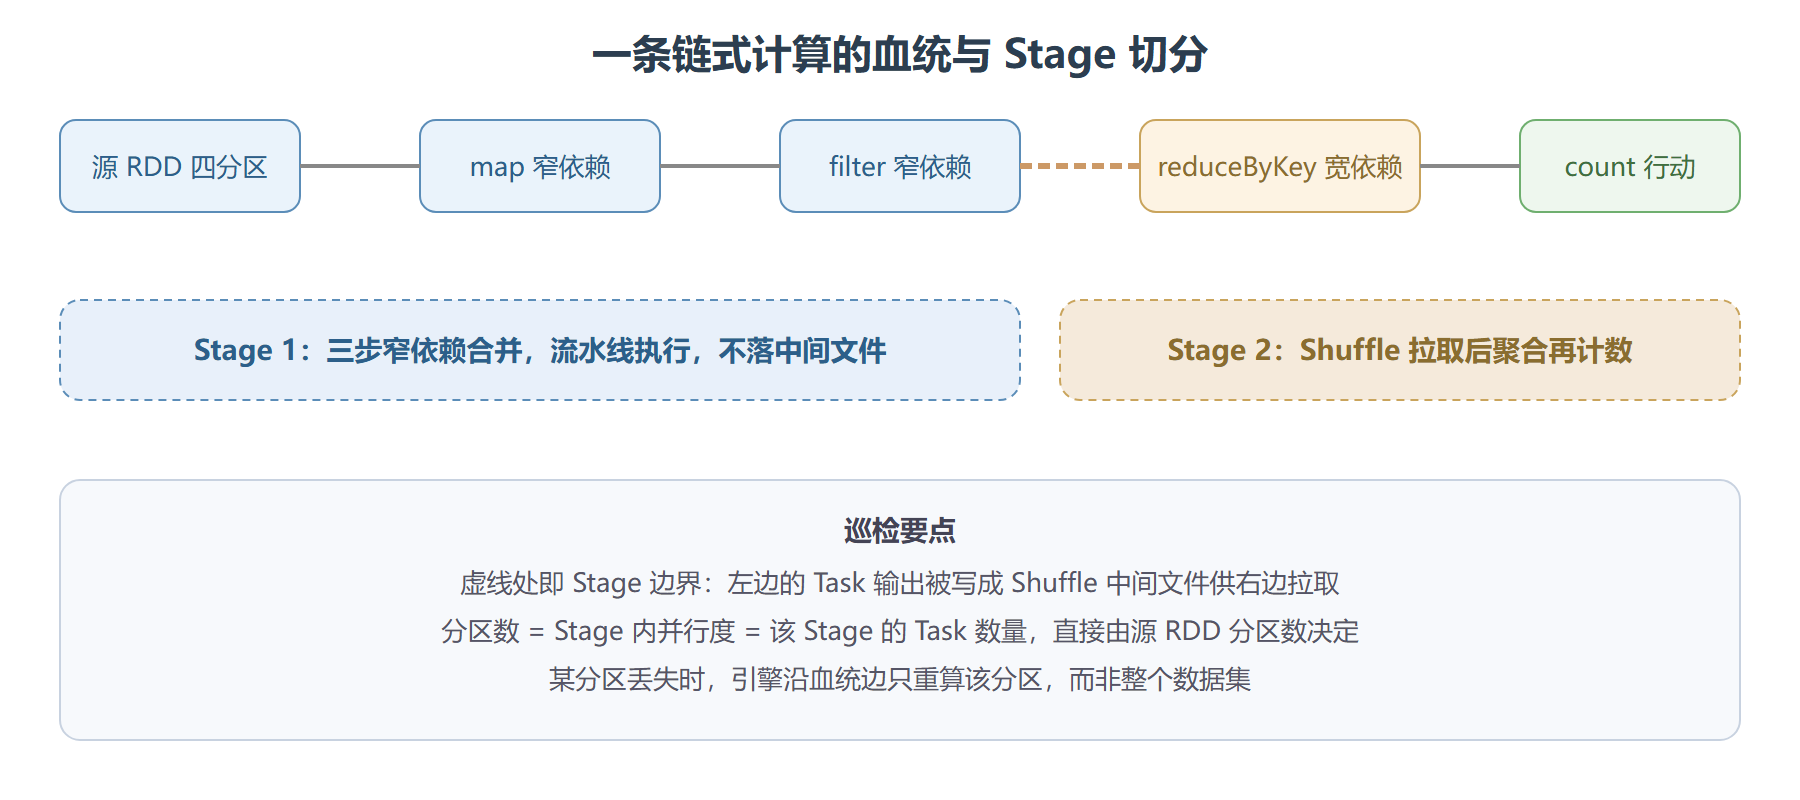
- 窄依赖:每个父分区最多被一个子分区消费(map、filter、union)。引擎把连续窄依赖压进同一个 Stage,数据在内存里流过流水线。
- 宽依赖:子分区要消费多个父分区(groupByKey、reduceByKey、join 非同分区)。引擎在此切 Stage 边界,触发 Shuffle——各 Executor 先把数据按目标分区写成本地中间文件,下一 Stage 的 Task 再来拉取。
宽窄依赖与 Stage 边界示意
分区实验:亲眼看 Stage 与 Task
from pyspark.sql import SparkSession spark = SparkSession.builder.appName("PartitionLab").master("local[*]").getOrCreate() sc = spark.sparkContext rdd8 = sc.parallelize(range(100), 8) # 手工指定 8 个分区 print("分区数:", rdd8.getNumPartitions()) # 8:Stage 1 将派出 8 个 Task grouped = rdd8.map(lambda x: (x % 3, x)).reduceByKey(lambda a, b: a + b) print("聚合后分区数:", grouped.getNumPartitions()) # 默认由 Shuffle 并行度参数决定 # 血统可视化:能直接看到 Stage 边界落在 reduceByKey 上 print(grouped.toDebugString())
调大 spark.sql.shuffle.partitions(或 RDD 侧传入 numPartitions 参数),Stage 2 的 Task 数随之变化;Stage 1 的 Task 数纹丝不动——因为它由源分区数决定。这个实验值得在本地模式亲手跑一遍。
缓存:把血统的终点钉住
血统重算适合偶发故障,不适合反复消费。同一 RDD 被 count() 两次,不缓存就重算两遍。
hot = grouped.cache() # MEMORY_ONLY:内存放不下则部分分区直接重算 hot.count() # 第一次触发计算并登记到 BlockManager hot.count() # 第二次读缓存,血统短路
| 持久化级别 | 存放位置 | 特点 |
|---|---|---|
| MEMORY_ONLY | 仅内存 | 默认;放不下的分区不缓存、用时重算 |
| MEMORY_AND_DISK | 内存优先,溢出落盘 | 大数据集反复消费的稳妥选择 |
| DISK_ONLY | 仅磁盘 | 内存极度紧张时保底 |
| MEMORY_ONLY_SER | 内存中序列化 | 换 CPU 解压省内存,对象大时划算 |
💡 关键直觉:缓存改变的是"重算还是读取",不改变血统本身——缓存失效后引擎仍能沿血统把分区补回来。所以缓存是性能选项,不是正确性依赖。
常见误读三则
其一,"不可变"常被误解成数据不能删。它指的是 RDD 对象一经构造,五个字段不再变化——你要的任何"修改"都是生成一张新登记卡,旧卡还在血统里挂着。这也是 Spark 可以放心做流水线优化的前提:没有原地改写,就没有隐蔽的副作用。
其二,"弹性"的翻译容易让人以为是性能弹性。它指的其实是容错弹性——分区丢了不用整机恢复,沿血统单分区重算即可。至于资源弹性,那是第 6 章动态分配的职责,别把两个"弹性"混为一谈。
其三,血统不是越长越好。一条上百步的血统在 Driver 端的解析开销、以及单分区故障时沿全链重算的代价,都可能大到不可接受。工程惯例:消费超过两次的中间结果上缓存,血统超过百步或跨 Stage 反复复用的场景上 checkpoint 截断——两种手段一个省算力、一个砍血统,配合使用。
再交代一个容易被忽略的属性:分区器。当 RDD 经过按 key 的 Shuffle 后,引擎会记住"当前数据按什么规则分布在哪些分区",后续若再来一次同 key 的聚合或连接,可以免掉重复 Shuffle。这就是"分区器可继承"——宽依赖之后紧跟同 key 操作往往比直觉便宜。反过来,中间插了一次 map 改变了 key,继承链断裂,第二次 Shuffle 照付。读懂 toDebugString 里分区器的标注,就能预判哪些 Shuffle 是必要成本、哪些是被无意打散的浪费。
分区数的选择顺带定个调:没有万能数字,但有推算式。源数据量除以目标单分区大小(经验值一两百 MB 一个分区),得到 Shuffle 前的合理分区数;Shuffle 后的分区数另算,以"总核数的两到三倍"为起点再按倾斜情况微调。分区太小则任务调度开销占比高,太大则并行度不足且单点故障重算代价大——两个方向都疼,按数据量推比拍脑袋稳。本节的分区实验就是这套推算的动手版,建议跑完顺手改几个数字多看几组对照。看懂分区,才算真正拿到这台引擎的方向盘。
本节要点回顾
- 登记卡视角:RDD = 分区 + 计算函数 + 依赖 + 分区器 + 位置偏好,物化的只有数据
- 宽窄依赖:窄依赖合并进同 Stage 流水执行,宽依赖切 Stage 并触发 Shuffle
- 并行度:Stage 内 Task 数由分区数决定,Shuffle 后分区数可独立配置
- 缓存语义:钉住血统终点避免重算,级别按"是否容忍重算"来选