1.3 Driver与Executor:一次提交的全程巡检
1.3 Driver 与 Executor:一次提交的全程巡检
本节摘要:Spark 运行架构由 Driver、集群管理器、Executor 三类角色构成。本节按时间顺序巡检一次应用提交的全过程,标注每个角色的职责边界与故障责任区,并给出"问题出在 Driver 侧还是 Executor 侧"的判断清单。
三个角色各管什么
- Driver:用户 main 函数所在进程。创建 SparkSession、把算子翻译成 DAG、切 Stage、派 Task、汇总结果。整个集群里只有它"懂"你的业务代码。
- 集群管理器:资源中介。Standalone、YARN、Kubernetes、Mesos 四种货源,负责按申请启动 Executor、回收资源。它不知道你的计算是什么。
- Executor:Worker 节点上的常驻进程。内部一个线程池,每个线程跑一个 Task;同时用 BlockManager 存放缓存与 Shuffle 中间文件,并通过心跳向 Driver 汇报指标。
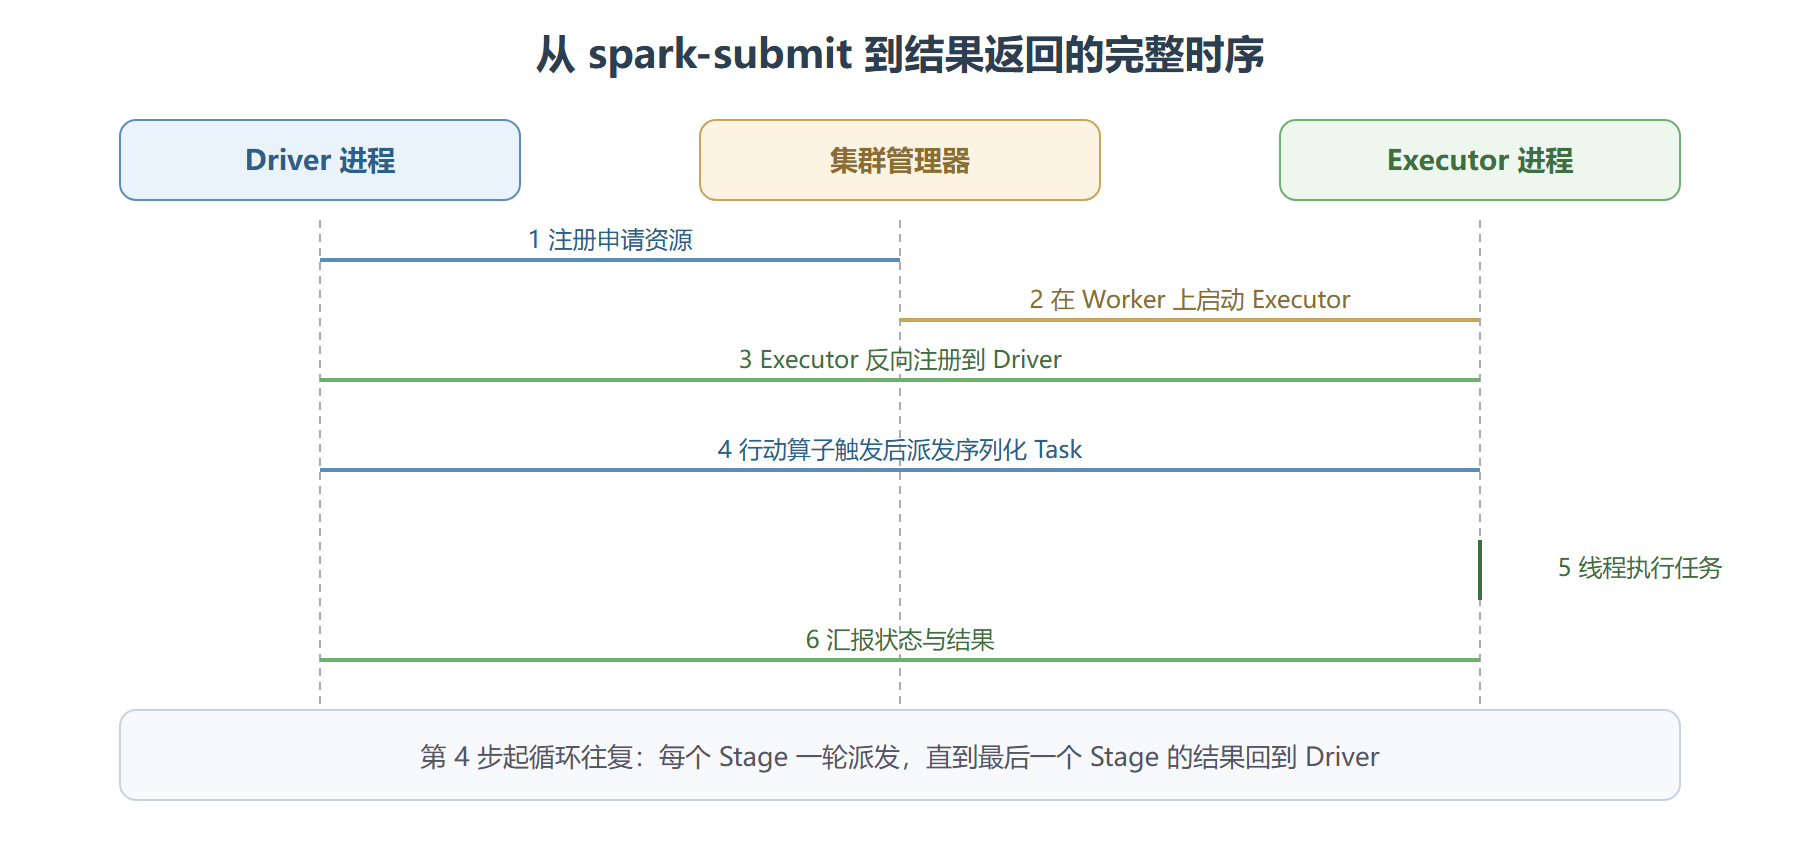
一次提交的时序巡检
用最小的程序验证角色分工
from pyspark.sql import SparkSession spark = (SparkSession.builder .appName("RolesDemo") .master("local[2]") # 本地模式:Driver 进程内模拟集群管理器并起 2 线程 Executor .getOrCreate()) sc = spark.sparkContext print("应用编号:", sc.applicationId) # Driver 生成,全局唯一 print("Driver 端默认并行度:", sc.defaultParallelism) rdd = sc.parallelize(range(1000), 4) rdd.map(lambda x: x * 2).filter(lambda x: x > 500).count() spark.stop()
换成 local[2] 后 Stage 内同时只有 2 个 Task 在跑,其余 2 个排队——Executor 的线程池就是并行度的物理上限。这个小实验直观说明:分区数决定"想并行多少",核心数决定"能并行多少"。
故障责任区速查
| 症状 | 责任侧 | 典型原因 |
|---|---|---|
| Driver 端 OOM | Driver | collect 大数据集、广播过猛、累加器滥用 |
| Executor 频繁失联 | Executor / 节点 | 内存不足被系统杀掉、GC 停顿超过心跳容忍 |
| 任务一直 ACCEPTED 不跑 | 资源侧 | 队列配额不足、Executor 尚未启动完毕 |
| 个别 Task 拖尾 | 数据侧 | 分区不均导致数据倾斜,与角色本身无关 |
⚠️ 常见坑:在 Executor 上执行的 lambda 里引用了 Driver 端大对象——它会被闭包捕获并随每个 Task 序列化传输,Task 越多放大越狠。大对象该用广播变量发一份,而不是让闭包带着跑。
from pyspark import Broadcast # 闭包携带 vs 广播变量的对照 lookup = {"a": 1, "b": 2} # 假设这是一份 200MB 的字典 bad = rdd.map(lambda x: lookup.get(x)) # 闭包捕获:每个 Task 序列化一份副本 bc = sc.broadcast(lookup) # 广播:每个 Executor 只存一份 good = rdd.map(lambda x: bc.value.get(x)) # Task 读本地只读副本,零重复传输
心跳与失联:巡检的时间感
角色之间的协作靠两条静默的通道维持:Executor 向 Driver 的心跳(默认几秒一拍,超时未达即判失联),以及 Task 运行状态的回执。理解心跳节奏是排障的"时间感"基础——一次 GC 停顿若超过心跳容忍窗口,Executor 会被误判死亡,其上所有 Task 重新派发;而 Task 汇报有独立超时,所以常见"Task 卡住但 Executor 存活"的僵局,此时 UI 上 Stage 进度条停在同一数字,日志却一片安静。遇到这类现象先看心跳与 GC 指标再翻代码,方向就对了。
顺带把 Driver 的单点风险记入巡检本:Driver 进程一死,作业元数据、聚合中的结果、Executor 连接全部蒸发——这正是第 6 章 cluster 部署模式与第 3 章检查点要联手解决的问题。本章只需建立印象:这台引擎的大脑只有一个,后面的可靠性设计都在围着这个事实打转。
还有一条职责边界常被新手搞混:SparkSession 与 SparkContext 的关系。SparkContext 是老资格的引擎入口,管 RDD、广播、累加器;SparkSession 是它的上层包装,多了 SQL、DataFrame 与 Hive 支持的入口。一个 JVM 里默认一个会话,算子代码里拿到的各种上下文对象,最终都汇到同一套调度组件上——入口可以有多副面孔,大脑始终只有一个。
最后给一个自查练习:在 local 模式跑任意作业,打开 UI 的 Executors 页签,对照本节的角色表逐行认领——Driver 是谁、Executor 有几个、每个多少任务多少缓存。五分钟的对照胜过五遍阅读,角色分工一旦在 UI 上对上号,后面所有章节的执行叙述都自动有了画面。做完别忘了顺手点开一次作业的 DAG 图——Stage 边界与 Task 圆点就是下一节内容(其实正是第 2 章)反复引用的视觉底稿,先混个眼熟,后面事半功倍。本节的角色表与下一章开头还会再见一次,届时它们将换上 SQL 的外衣出场。角色不变、外衣常新,这是 Spark API 演化的固定套路,也是本册反复印证的一条暗线。
本节要点回顾
- 职责三分:Driver 管逻辑与调度,集群管理器管资源,Executor 只认 Task 字节码
- 反向注册:Executor 由管理器启动后主动连回 Driver,此后任务分发走直连通道
- 并行度物理上限:Executor 线程数,分区数超出部分只能排队
- 排障第一步:先定位问题落在哪一侧,再看对应角色的日志与指标