2.1 Spark SQL与Catalyst优化器
2.1 Spark SQL 与 Catalyst:Driver 里的编译流水线
本节摘要:Catalyst 是 Spark SQL 的查询编译器,把声明式查询经解析、分析、逻辑优化、物理规划、代码生成五步变换为可执行计划。本节逐站巡检这条流水线,用 explain 实验观察谓词下推与列裁剪的真实效果,并说明 Tungsten 执行层在此基础上的内存布局改造。
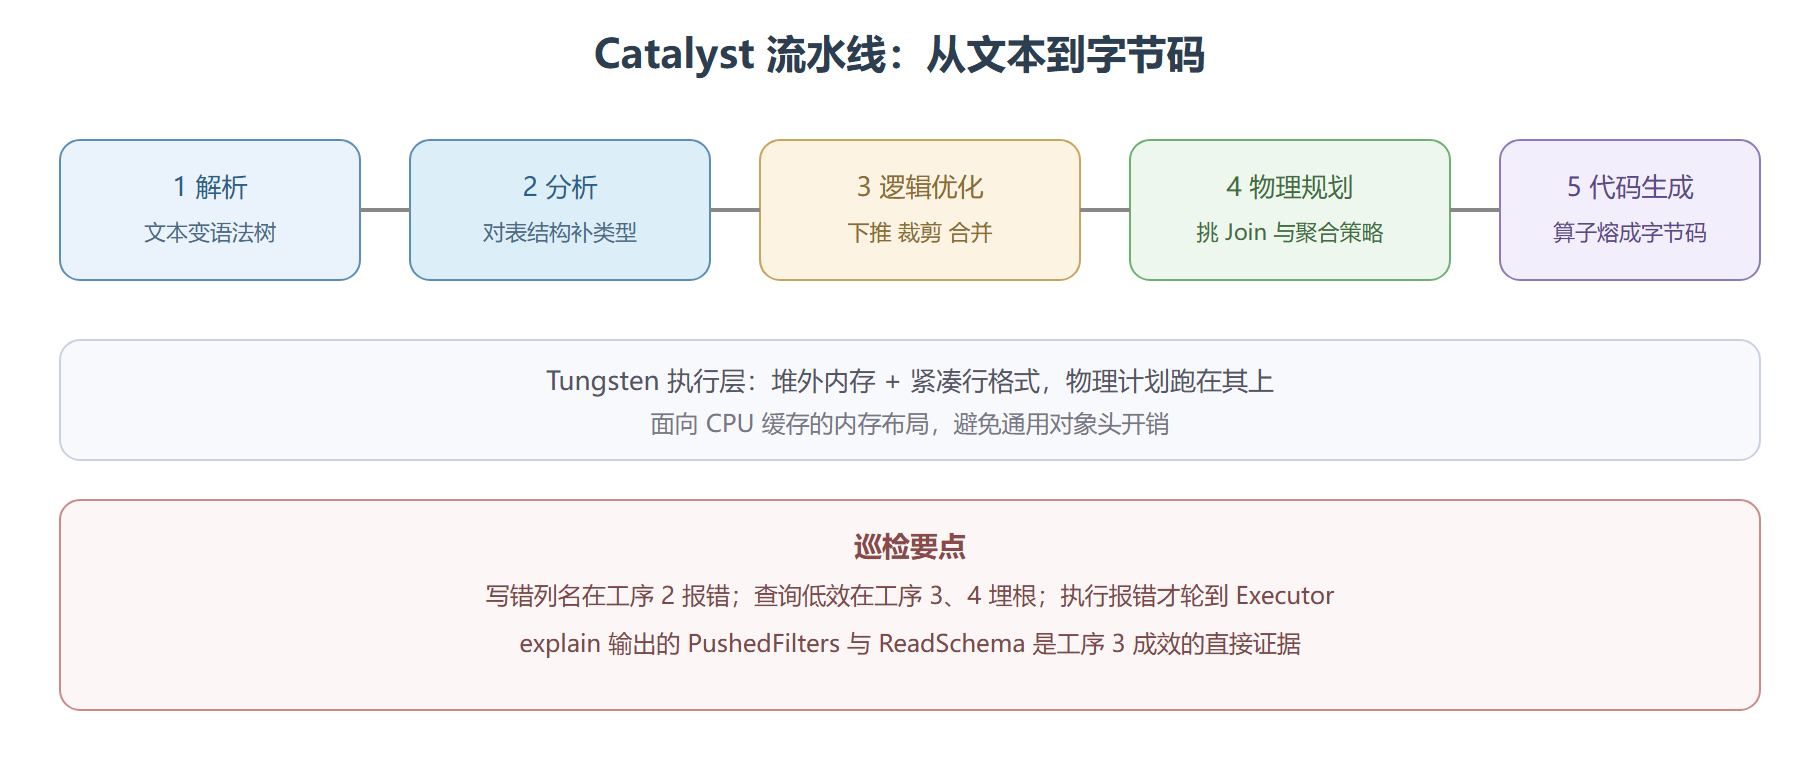
一条查询的五道工序
你在终端敲下 SQL,到 Executor 拿到 Task 之间,Driver 内部开了一条小工厂流水线:
- 解析:SQL 文本变成语法树(未解析计划),此刻只认语法不认表。
- 分析:对照 Catalog 里的表结构、列名、类型,把语法树补全成有类型的逻辑计划。
- 逻辑优化:基于规则改写——谓词下推(把过滤推到读取层)、列裁剪(只读用到的列)、合并相邻过滤、常量折叠。这是"引擎替你改代码"的核心工序。
- 物理规划:同一逻辑计划对应多种物理策略(Broadcast Join 还是 SortMergeJoin、Hash 聚合还是 Sort 聚合),按代价估算挑一种。
- 代码生成:WholeStageCodegen 把一串算子熔合成一段生成的字节码,消除虚函数调用与中间对象,数据在寄存器里流转。
from pyspark.sql import SparkSession spark = SparkSession.builder.appName("CatalystLab").master("local[*]").getOrCreate() df = spark.read.option("header", True).csv("orders") # 声明式读取,尚未发生 IO q = (df.filter("amount > 100") .select("user_id", "amount") .groupBy("user_id") .sum("amount")) q.explain(True) # 打印解析、分析、优化、物理四级计划
explain 输出里找 PushedFilters: [amount > 100] 与 ReadSchema 只剩两列——第 3 道工序在你眼前发生了:过滤被推到数据源层,不用的列根本没进引擎。对 Parquet 这类列存格式,效果是数量级的。
五道工序与职责分布
Catalyst 与 RDD 的分工
Catalyst 输出的物理计划,最终仍交给 DAGScheduler 切 Stage、派 Task——第 1 章的引擎主干没有变。变化在主干上游:RDD API 的血统图由你手工搭建,Catalyst 的血统图由优化器自动改写后再搭建。两套入口,一台引擎。
💡 关键直觉:把 Catalyst 当成"坐在 Driver 里的老司机"。你负责说清楚目的地(查询语义),它负责选路线(物理计划)。但老司机也有看走眼的时候——统计信息缺失时 Join 策略选错,需要你用 Hint 人工干预,2.4 节展开。
-- 一眼看懂五道工序的观察窗口:extended 格式 EXPLAIN EXTENDED SELECT user_id, count(*) AS pv FROM events WHERE event_type = 'click' GROUP BY user_id -- 输出依次是 Parsed、Analyzed、Optimized、Physical 四级计划 -- 对比 Analyzed 与 Optimized 两段:Filter 的位置移动即谓词下推, -- Project 列表变短即列裁剪——两处改写都能肉眼抓到
Tungsten 补一刀:执行层的物理改造
Catalyst 决定"跑什么计划",Tungsten 决定"计划里的数据长什么样"。它把行编码成紧凑二进制,字段偏移直接算出来,省掉通用对象的头开销与指针追踪;聚合缓冲、排序缓冲尽量放堆外,减轻 GC 压力;算子边界由代码生成熔成单循环,消除虚函数调用。对巡检者的意义:UI 里 WholeStageCodegen 字样出现得越完整,说明越多算子被熔进了一段字节码;反之计划里成串的普通算子节点,往往意味着某步退回了慢路径,比如用了一个不支持代码生成的自定义函数。
把两级改造串起来读:Catalyst 是"编译器优化",Tungsten 是"指令与内存布局优化",两者叠加才是 Spark SQL 相对 RDD API 的完整提速来源。少了任何一级,explain 上看似相同的逻辑都可能跑出数倍差距。
这条流水线还解释了一个日常现象:为什么 DataFrame 的错误常在运行期而非编译期报出。Python 侧的链式调用只是拼装计划,列名对不对、类型合不合法,都要等 Driver 端解析计划时才检查——所以"代码写完没报错、一触发行动算子才炸"不是玄学,是编译时机后移的必然结果。写 DataFrame 的正确姿势因此是:长链拆段、尽早触发一次小行动算子做冒烟验证,别把半天的逻辑攒到一个 collect 上一次性爆雷。
还要习惯一个心智转变:explain 输出是 SQL 工程师的"汇编"。初期只需认得 Exchange(搬运)、Filter(过滤)、Scan(扫描)、Join 策略名这几类节点,就足以读懂八成计划的病情;熟练后自然会长出"看计划猜耗时"的手感——哪一步数据量最大、哪一步边界最多,性能病灶几乎总是那两三行。这个能力没有任何捷径,唯一路径是每写一条查询都顺手 explain 一眼,一个月即可成型。下一节的 DataFrame 操作正好是练手素材,边学算子边认计划节点,两件事互相喂。数据库背景的读者还可以把执行计划里各节点与熟悉的最优树对照,概念基本一一有对应。
本节要点回顾
- 五道工序:解析、分析、逻辑优化、物理规划、代码生成,全部发生在行动算子触发前
- 可观察:explain 输出能直接看到下推与裁剪痕迹,是 SQL 巡检的第一工具
- 策略选择:物理规划按代价在多种 Join、聚合实现间挑选,依赖表统计信息
- 同一引擎:物理计划仍走 DAG → Stage → Task 主干,Catalyst 只改写血统