2.2 DataFrame与Dataset:结构化数据的执行入口
2.2 DataFrame 与 Dataset:结构化数据的执行入口
本节摘要:DataFrame 是带 Schema 的分布式行集合,Dataset 是带类型参数的 DataFrame。本节从执行视角讲两者的关系与取舍——列名在编译期还是运行期检查、lambda 在引擎内还是引擎外执行——并过一遍高频算子的执行代价。
DataFrame:把结构信息交给引擎
RDD 的每个元素对引擎是黑盒对象,序列化、比较、哈希都只能走通用路径。DataFrame 多了一张 Schema 登记表:每列的名字与类型引擎全知道,于是 Tungsten 能用紧凑二进制格式存行、直接对字节做比较与聚合,序列化开销近乎归零。代价是你放弃了对每行对象的随意操作自由。
from pyspark.sql import SparkSession from pyspark.sql import functions as F spark = SparkSession.builder.appName("DfLab").master("local[*]").getOrCreate() df = (spark.read.option("header", True).csv("orders") .withColumn("amount", F.col("amount").cast("double"))) result = (df.filter(F.col("amount") > 100) .select("user_id", "amount") .groupBy("user_id") .agg(F.sum("amount").alias("total"), F.count("*").alias("cnt")) .filter(F.col("cnt") >= 3) .orderBy(F.desc("total"))) result.show(5)
巡检这段代码的执行要点:两个 filter 一个被下推到读取层、一个作用在聚合后,由 Catalyst 自动安放;orderBy 引发一次全量 Shuffle 排序——如果只取前几名,改用 limit 配合的写法引擎可以走 TakeOrdered 途径,省掉整轮排序。
Dataset:类型安全那一档
在 Scala / Java 里,Dataset 把行映射为自定义类型,lambda 里拿到的是编译期检查过的对象:
case class Order(userId: String, amount: Double) val ds = spark.read.option("header", "true").csv("orders") .as[Order] // 带类型的 Dataset val big = ds.filter(o => o.amount > 100) // 类型安全,但注意下面一行 val typed = ds.filter("amount > 100") // 字符串版:仍走 Catalyst 优化
两条 filter 的执行路径不同:字符串表达式经 Catalyst 编译,享受代码生成;对象 lambda 属于"转换算子回退区",引擎要把二进制行解码成对象再执行,之后再编码回去。类型安全的舒适是用这条解码通道换的。
| 维度 | RDD | DataFrame | Dataset |
|---|---|---|---|
| 编译期类型检查 | 有 | 无(运行期查列名) | 有 |
| Catalyst 优化 | 不参与 | 全程参与 | 表达式全程,lambda 受限 |
| 执行开销 | 通用对象序列化 | 紧凑二进制,最快 | 介于两者之间 |
| 适用语言 | 全部 | 全部 | Scala、Java |
Python 里 DataFrame 与 Dataset 名字合流(Python 的 Dataset 就是 DataFrame),上表的后一列只在 JVM 语言里需要操心。
高频算子的执行代价速记
select / withColumn:窄依赖,无 Shuffle,几乎白送groupBy().agg():宽依赖,一次 Shuffle,注意聚合后分区数join:代价取决于策略——小表广播无 Shuffle,大表走 SortMerge 要两次排序加一次 Shufflerepartition:人为 Shuffle,用于打散热点或控制并行度distinct:本质是按全列分组,别当成廉价操作
⚠️ 常见坑:在循环里反复
withColumn拼接几十个派生列。每次调用都复制一份逻辑计划,计划膨胀到 Catalyst 分析超时。一次性用select配多个表达式,或withColumns批量接口。
巡检案例:一次 join 的两种命运
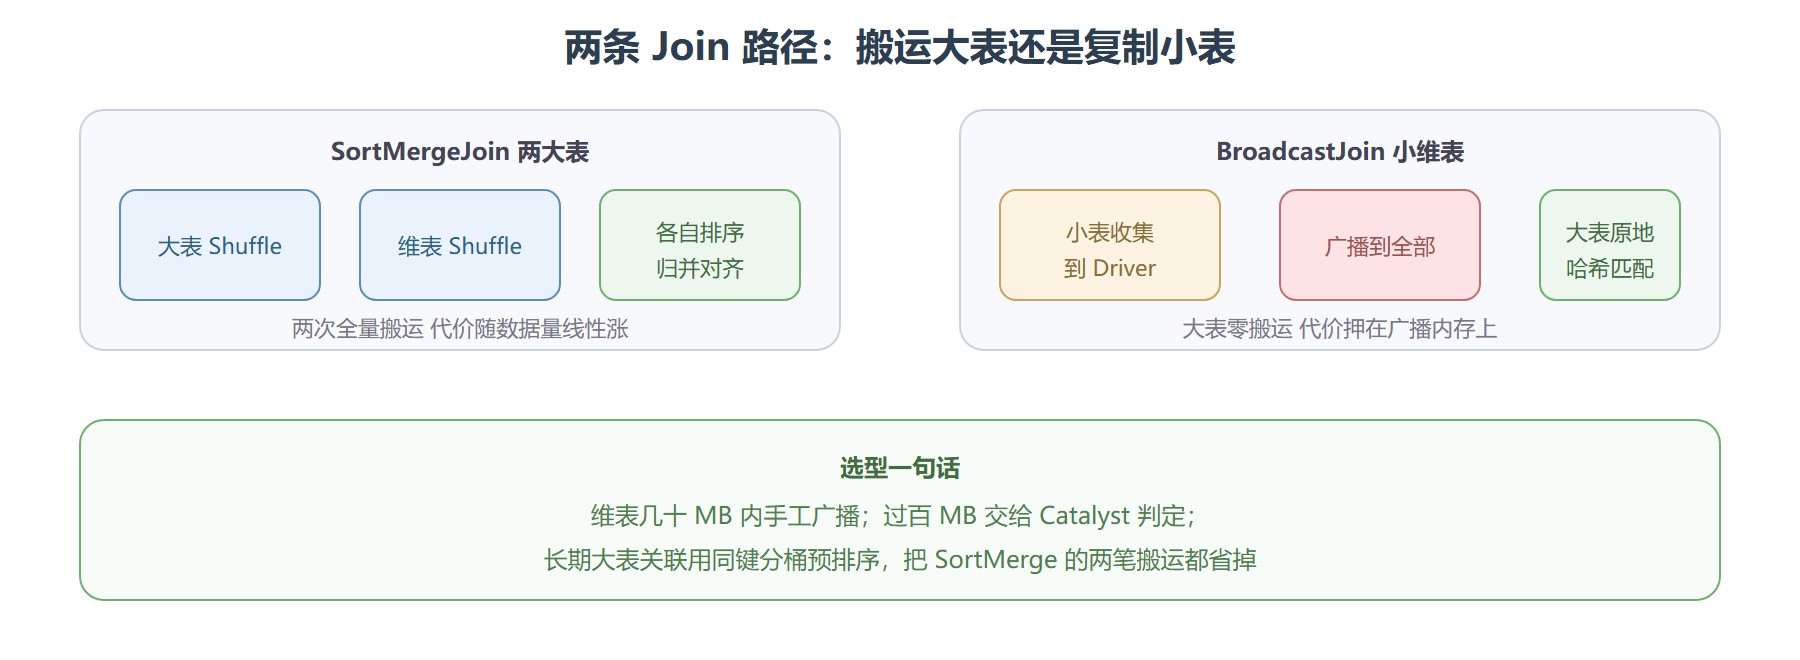
背景:订单表两亿行,用户维表三十万行,按 user_id 关联打用户标签。操作一:直接 join。结果:Catalyst 判定两表都"大",选择 SortMergeJoin——两边各按 key 排序再归并,Spark UI 里两个 Stage 各一次全量 Shuffle,总耗时 26 分钟,Shuffle 写量合计 11GB。操作二:维表先广播。
from pyspark.sql import functions as F labels = spark.read.parquet("user_labels") # 30 万行,约 40MB orders = spark.read.parquet("orders") # 2 亿行 result = orders.join(F.broadcast(labels), "user_id") result.explain(True) # 物理计划里 BroadcastHashJoin:维表收集到 Driver 再广播 # 大表全程不移动,Shuffle 写量归零
结果二:同集群 9 分钟跑完,Shuffle 写量为零,Driver 与每个 Executor 各多占 40MB 内存。解读:广播 join 把"两边搬运"换成了"小表复制",代价全押在 Driver 收集与广播的内存上——维表过百 MB 或有倾斜风险时反而会翻车,所以 Catalyst 的自动判定有阈值参数可调,手工广播要自己掂量体积。变式:若维表涨到八百万行,广播不可行,退回 SortMergeJoin 的同时给 user_id 预分桶(两表按同一分桶键落盘),排序与 Shuffle 都能省掉,这是仓库表设计的常用手段。
💡 关键直觉:读 DataFrame 代码时脑内自动给每个算子贴"窄/宽"标签,宽依赖处立刻追问 key 分布——这两问能提前抓住八成的性能事故。
两种 Join 策略的搬运路径
图:SortMergeJoin 与 BroadcastJoin 的 Stage 对照
本节要点回顾
- Schema 是门票:结构信息让引擎用上紧凑格式与代码生成,这是 DataFrame 快的根本
- lambda 回退区:Dataset 的对象级 lambda 绕开代码生成,能写表达式就别写 lambda
- join 策略决定 Shuffle 次数:写代码时就要预判走广播还是排序归并
- 计划会膨胀:链式调用无成本是错觉,逻辑计划在 Driver 里越滚越大