7.3 WebFlux响应式车道
7.3 WebFlux 响应式车道
本节摘要:异步请求解决了单个慢接口占线程的问题,响应式 WebFlux 把整套模型换掉——少量事件循环线程扛全部请求,等待被表达为数据流上的订阅。本节讲模型差异、用代码对照两种写法,并给出"是否值得迁移"的判断清单,避免为了响应式而响应式。
换的是什么模型
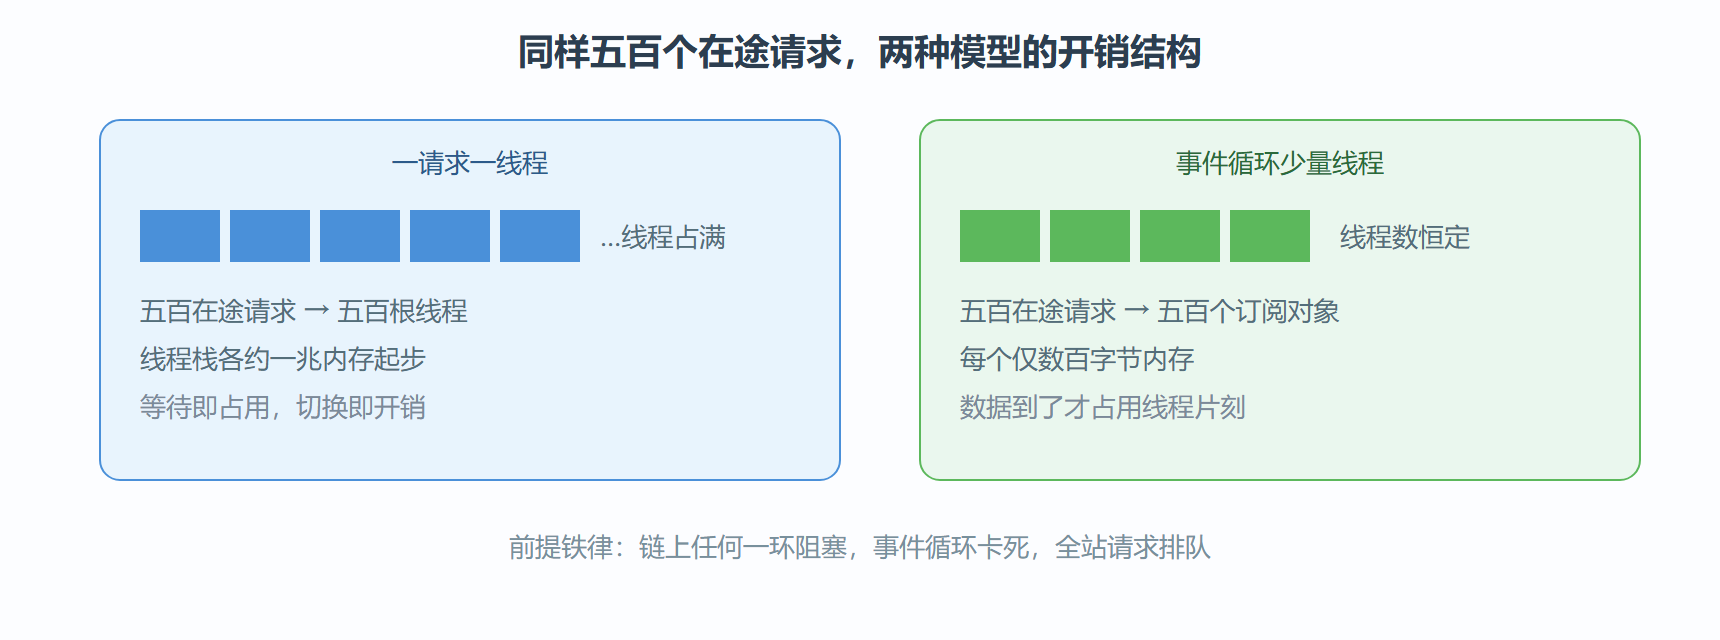
MVC 的经济学:一请求一线程,两百根线程池约等于两百个并发等待上限。WebFlux 的经济学:十几根事件循环线程永不阻塞,谁的数据到了就处理谁,等待的请求只是内存里的一个订阅记录——并发上限从"线程数"变成"内存可容纳的订阅数"。
代价是代码模型整体改变。同一个查价接口,两版对照:
// MVC 版:线程在调用期间阻塞 @GetMapping("/price") public PriceVO price(Long id) { Product p = repo.findById(id).orElseThrow(); return new PriceVO(p.getId(), p.getPrice()); } // 响应式版:方法立即返回流,订阅发生在线程外 @GetMapping("/price") public Mono<PriceVO> price(@RequestParam Long id) { return repo.findById(id) // 返回 Mono 而非实体 .map(p -> new PriceVO(p.getId(), p.getPrice())); }
Mono 是零或一个元素的流。调用立即返回,真正的数据库往返发生在订阅时刻,结果到达后回调继续。链上每个算子声明"数据到了之后做什么",整条链就是一张执行计划表,没有一根线程在原地干等。
再看一个多元素的例子:商品列表接口要把库里的一串商品转成视图对象,还要对缺货商品打标。Flux 是零到 N 个元素的流,算子逐个声明处理规则:
// Flux 版商品列表:整条链没有一处等待 @GetMapping("/list") public Flux<PriceVO> list() { return repo.findAll() // Flux<Product>,0..N 个元素 .filter(p -> p.getStatus() != 3) // 过滤已下架 .map(p -> { // 逐个映射为视图对象 PriceVO vo = new PriceVO(p.getId(), p.getPrice()); if (p.getStock() <= 0) { // 缺货打标 vo.setSoldOut(true); } return vo; }) .sort(Comparator.comparing(PriceVO::getId)); // 按 id 稳定排序 } // 订阅发生后:每到达一个元素就流过一次 filter→map, // 客户端拿到的是元素陆续到达的流,而非攒齐后的一个大列表
对照 MVC 版列表接口的写法(返回 List,查全、映射完、排序好再一次性返回),差别不在代码行数,而在"什么时候占用线程":MVC 版全程占着调用线程直到列表组装完毕;Flux 版只在每个元素流过的瞬间占用事件循环线程片刻。元素越多、单元素等待越长,这一差异越明显。
图 7-3 两种模型的线程经济学对比
铁律与边界
上面的前提需要再强调:事件循环线程绝不阻塞。链上任何一处调用了阻塞的老驱动或同步接口,十几根线程很快全体卡死,后果比 MVC 里线程耗尽更剧烈(后者至少还能排队)。因此迁移到响应式不是换注解,而是全链路都要非阻塞:数据库要换响应式驱动,下游调用要换响应式客户端,连日志都要留意。这也是"是否迁移"的核心判断:
| 判断项 | 倾向迁移 | 倾向留守 MVC |
|---|---|---|
| 并发形态 | 海量长连接或慢下游等待 | 常规业务接口为主 |
| 团队经验 | 熟悉流式编程 | 响应式调试经验为零 |
| 依赖生态 | 数据层有响应式驱动 | 核心依赖仅提供同步接口 |
| 计算形态 | 输入输出密集 | 计算密集 |
我的立场保守:多数业务系统用 7.1 节的异步请求加消息队列已足够解耦;只有连接数与等待数确实大到线程模型撑不住(网关、推送、聚合查询层),响应式的收益才配得上它的复杂度。
💡 混合是允许的:响应式 WebFlux 处理海量接入层,内部服务保持 MVC,边界上用适配器桥接——技术选型不是信仰宣誓。
迁移前的一个自测问题
判断团队是否准备好换车道,有一道好题:给你一段返回嵌套流的代码,能否不运行就画出"订阅发生几次、各自在哪个线程上继续"?答不出就先补流式编程的基本功,否则上线后的每一次故障都会变成玄学——错误栈在算子之间跳来跳去,连"哪一行代码出的问题"都不再直观。调试体验的下降是响应式最隐性的成本:断点打到算子里,冻结的是事件循环线程,整个应用随之一起停摆,必须改用日志与特定钩子观察。响应式不是高级版的 MVC,而是另一种编程范式,尊重它的学习曲线,是本节最想留下的态度。
本节要点回顾
- 并发上限换了计量单位:从线程数到内存可容纳的订阅数
- 流即执行计划,订阅时刻才发生真实往返
- 全链路非阻塞是铁律,一处阻塞全线卡死
- 多数场景异步加消息已够,网关级并发才值得上响应式
读完自测
合上书回答:MVC 与 WebFlux 各自的并发上限以什么计量;阻塞调用混进事件循环的后果为什么比线程耗尽更严重;"是否迁移"判断表里的四项分别是什么。四项说不全就再读一遍对照表——它是本节最值得带走的一张决策卡。
最后给一个保守但实用的行动建议:如果你的系统此刻运行良好,什么都不用做;如果线程池水位告警频发、慢下游拖垮快接口,先做 7.1 的异步化与缓存,这两步能解决大部分压力;只有当接入层连接数以十万计时,再认真评估本节的迁移判断表。响应式是旅程末端的选项,不是默认答案。
补充一个判断细节:输入输出密集与计算密集的区分并不总是显然——加密解密、报表聚合这类看似普通的逻辑往往属于计算密集,把它们搬进事件循环只会拖慢全体。评估时看线程在等待还是在烧中央处理器,而不是看业务名字听起来像什么。