7.2 消息接力:JMS与Kafka
7.2 消息接力:JMS 与 Kafka
本节摘要:第 5 章的应用内事件把工作挪出了请求路径,但它只在一个进程里流动;消息中间件把同样的接力跨进程化,还附赠削峰、缓冲与重放。本节用统一的监听抽象对接 Kafka 与传统队列,讲清两种中间件的取向差异、投递语义的坑,以及事件与消息的边界。
同一套注解,两种中间件
Spring 对 Kafka 与 JMS 队列提供了几乎同形的编程模型。发送方:
@Service public class OrderEvents { private final KafkaTemplate<String, String> kafka; public OrderEvents(KafkaTemplate<String, String> kafka) { this.kafka = kafka; } public void orderPaid(Long orderId) { kafka.send("order-events", orderId.toString(), "{\"type\":\"PAID\",\"orderId\":" + orderId + "}"); } }
消费方:
@Component public class ShippingConsumer { @KafkaListener(topics = "order-events", groupId = "shipping") public void onMessage(String payload) { // 同组多实例时,分区在实例间分配,一条消息只被组内一个实例处理 System.out.println("物流组收到:" + payload); } }
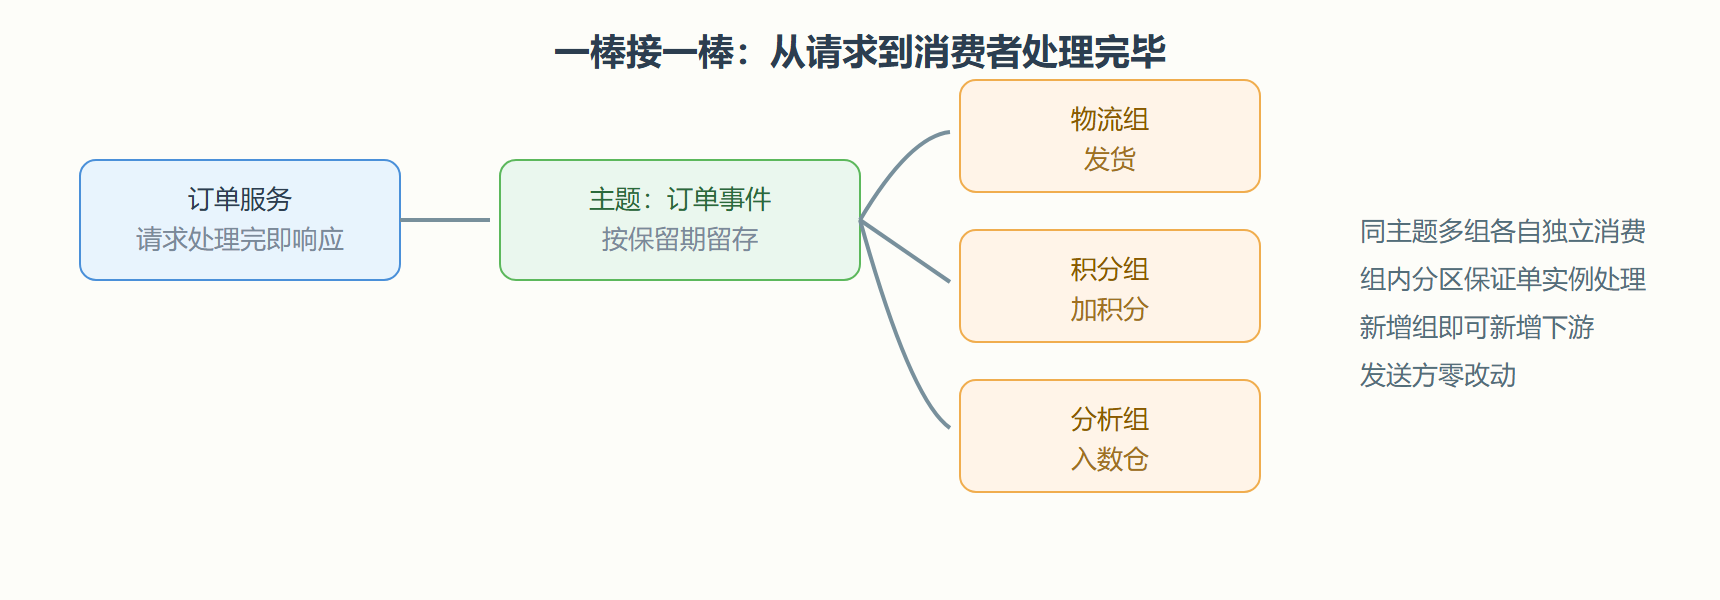
换到传统队列,发送与监听注解换成对应的一对,业务代码结构不变——抽象的价值再次体现:旅程视角下,消息系统是请求结束后的下一棒,发送方决定接棒人是谁(主题与组),至于怎么送达、何时送达,是中间件的职责。
两种中间件的取向差异
| 维度 | Kafka 类日志流 | JMS 类队列 |
|---|---|---|
| 消息留存 | 按时间保留,可重放 | 取走即删 |
| 消费模型 | 拉取、偏移量自管 | 推送、服务端派发 |
| 吞吐取向 | 高吞吐批量顺序写 | 低延迟单条投递 |
| 典型用途 | 事件流、数据管道、审计回溯 | 任务分发、点对点交接 |
留存机制的差别影响深远:队列删了就是没了,消费者宕机重启期间错过的消息永久丢失;日志流按保留期存着,消费者重启后从上次位置继续,甚至可以把偏移量拨回上周重演一遍事件——审计与数据修复场景里这是决定性能力。
图 7-2 请求结束后工作在消息系统里的接力路径
投递语义:至少一次与幂等
默认投递是"至少一次":消费者处理完但在提交偏移量前崩溃,重启后同一条消息会再来一遍。因此消费者必须幂等——同一消息处理两次与一次效果相同。常用手法:
@KafkaListener(topics = "order-events", groupId = "shipping") public void onMessage(ConsumedEvent e) { if (processedRepo.existsByEventId(e.eventId())) { return; // 去重表挡住重复投递 } shippingService.ship(e.orderId()); processedRepo.save(new ProcessedEvent(e.eventId())); }
以唯一事件号建去重表是最朴素的实现,业务唯一键约束(如订单号唯一)也是天然屏障。宁可多想一步幂等,也别指望"不会那么巧重复"。
⚠️ 应用内事件(5.3 节)与跨进程消息不是替代关系:前者解耦进程内的调用栈,后者解耦系统与系统。小系统直接上消息中间件,运维成本常常先于收益到来。
实战:亲手复现一次重复投递并验证幂等
背景:团队质疑"消息真的会重复吗",用实验代替争论。操作:第一步,写一个故意有缺陷的消费者——处理完成与提交偏移量之间留一个人工触发的崩溃点:
@KafkaListener(topics = "order-events", groupId = "demo") public void onMessage(ConsumedEvent e, Acknowledgment ack) { shippingService.ship(e.orderId()); // 先处理 if (System.getenv("CRASH_FLAG") != null) { throw new IllegalStateException("处理完但没提交,模拟崩溃"); } ack.acknowledge(); // 后提交:中间崩溃即重复 }
第二步,发送一条消息并置崩溃标记:日志显示发货已执行,随后消费者报错重启。第三步,去掉标记再启动:同一条消息被再次投递,ship 第二次执行——重复投递从概念变成日志里的事实。结果(修复后):引入前文去重表逻辑重放全过程,第二次投递在去重表前被挡下,业务只执行一次。解读:先处理后提交的窗口期就是重复的来源,顺序无法绝对消除,幂等才是可靠的防线。变式:把顺序倒过来(先提交后处理),重复消失了但出现新问题——处理失败的消息被跳过,成了"至多一次"投递,丢失比重复更难补救。两种语义各失一端,工程上普遍选"至少一次加幂等"。
最后补一条消费部署经验:同组多实例扩容时,实例数超过分区数后多出来的实例空转——扩容上限由分区数决定,这是容量规划里最常被漏算的一笔。订单与顺序也要提一句:分区内严格有序、跨分区不保证,需要顺序的数据(同一账户的流水)必须用同一键路由到同一分区。
本节要点回顾
- 统一监听抽象下,队列与日志流编程模型几乎同形
- 日志流可重放,审计回溯与消费补课靠留存机制
- 至少一次投递逼出幂等,去重表或业务唯一键是标准答案
- 事件管进程内,消息管进程间,别越位使用
读完自测
三问回收:重复投递的窗口期出现在处理与提交之间的哪个位置;扩容消费者实例的上限由什么决定;同一账户的流水为何必须同键。答完这三问,本节的投递语义就吃透了。