8.4 Batch批处理的离线旅程
8.4 Batch 批处理的离线旅程
本节摘要:并非所有工作都以"一个请求"的形态发生——月末对账、日志清洗、积分结算是对百万行数据的批量处理。本节讲批处理框架的作业—步骤—分块三层数据结构、断点重启的实现方式,最后给一张"请求式还是批处理"的判断表,为全书的旅程视角补上离线形态。
批处理不是"循环加提交"
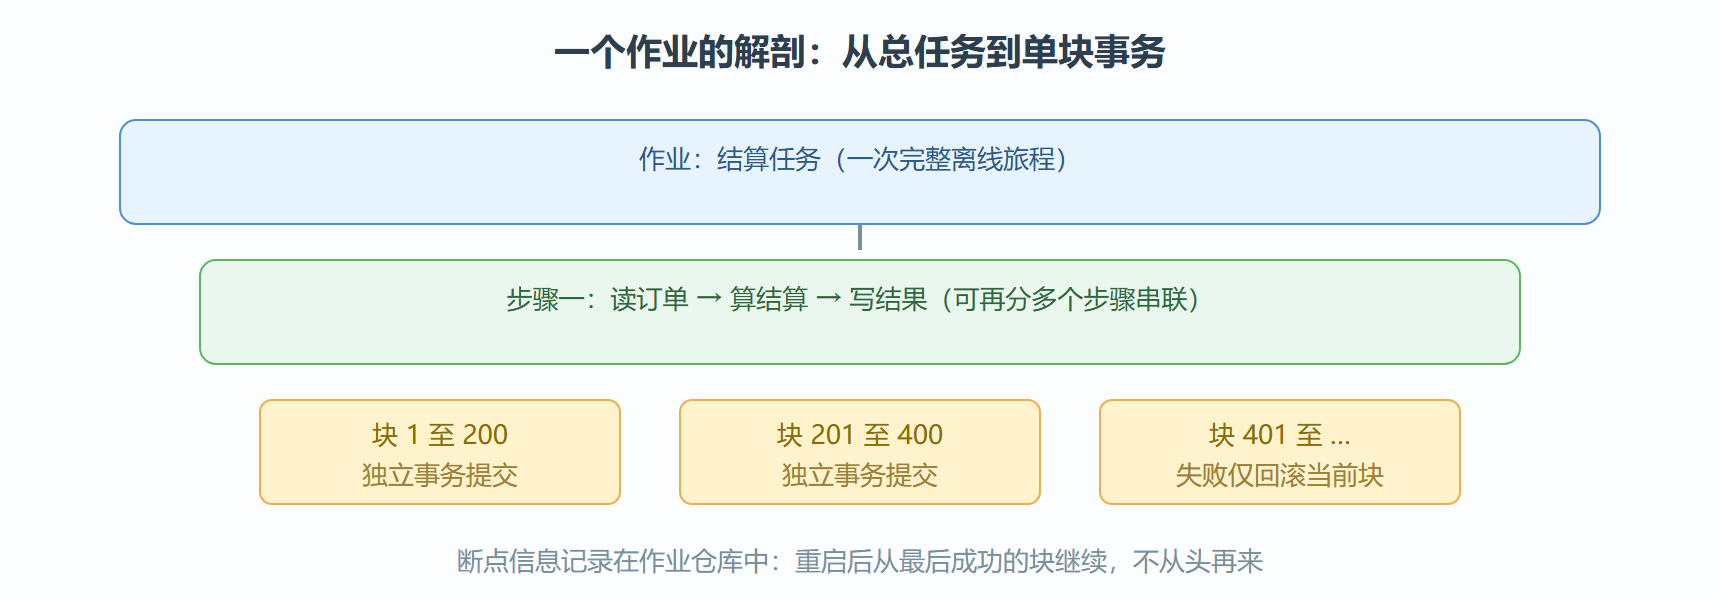
一百万行的结算,朴素写法(循环里逐条保存)慢到没法用;一次全查全改又把内存与事务撑爆。批处理框架的答案是分块:一次读一百条、处理一百条、写一百条,循环推进。用注解描述这个结构:
@Configuration @EnableBatchProcessing public class SettlementJobConfig { @Bean public Job settlementJob(JobRepository repo, Step settleStep) { return new JobBuilder("settlementJob", repo) .start(settleStep) .build(); } @Bean public Step settleStep(JobRepository repo, PlatformTransactionManager tx, ItemReader<Order> reader, ItemProcessor<Order, Settlement> processor, ItemWriter<Settlement> writer) { return new StepBuilder("settleStep", repo) .transactionManager(tx) .<Order, Settlement>chunk(200) // 每块两百条一事务 .reader(reader) .processor(processor) .writer(writer) .build(); } }
三段职责:读组件负责分页取数、指针推进;处理组件做纯转换(一条订单算一条结算,无副作用,利于重跑);写组件批量落库。每块一个事务——失败只回滚当前块,前面已提交的块不受影响。
图 8-4 作业、步骤与分块的执行结构
断点重启:离线旅程的"断点续传"
夜间任务跑到第七十万行时机器重启,从头再来既浪费又危险(已写入部分需要清理)。框架把执行进度(作业实例、步骤执行、读写条数、提交块数)持久化到数据库的作业仓库表里,重启同一作业参数时自动定位到失败块继续。这也解释了处理组件为什么要设计成无副作用的纯转换:重跑安全是断点机制的前提。凡有外部副作用(发通知、调第三方)的动作,要么设计成幂等,要么挪到独立的幂等步骤。
处理与写组件的落地代码各举一段。处理组件做订单到结算单的纯转换:
// 处理组件:无副作用纯转换,重跑任意次结果一致 @Component public class OrderProcessor implements ItemProcessor<Order, Settlement> { @Override public Settlement process(Order order) { if (order.getAmount() == null) { return null; // 返回 null 表示过滤掉该条,不进入写 } Settlement s = new Settlement(); s.setOrderId(order.getId()); // 只做字段搬运与计算 s.setAmount(order.getAmount().multiply(new BigDecimal("0.98"))); // 结算系数 s.setState(0); // 待确认 return s; } } // 写组件:批量落库,注意这里绝不能写"单条 save"循环 @Component public class SettlementWriter implements ItemWriter<Settlement> { private final SettlementRepository repo; SettlementWriter(SettlementRepository repo) { this.repo = repo; } @Override public void write(Chunk<? extends Settlement> chunk) { repo.saveAll(chunk); // 整块批量插入,两百条一次往返 } } // 运行日志可验证分块提交:每两百条出现一次 step execution 更新, // 失败重启后日志从最后成功块的下一块继续,已提交块不再出现
请求式还是批处理
一张判断表收束全节,也收束全书:
| 判断项 | 走请求式(前七章的旅程) | 走批处理(本节) |
|---|---|---|
| 数据量 | 单条或少量 | 万行以上 |
| 时效 | 用户在线等待 | 可延迟到夜间窗口 |
| 失败处理 | 当场提示重试 | 断点续跑 |
| 典型任务 | 下单、查询、支付 | 对账、结算、清洗、归档 |
💡 两形态会合流:批处理作业的每一块内部,读—处理—写的写库仍发生在第 4 章的事务边界内;作业的调度触发也常来自第 7 章的消息。旅程视角到这里闭环——离线批量不过是把一次请求要做的事,摊到了时间轴上。
批处理的两个运维要点
其一,块大小不是越大越好:块大事务少、吞吐高,但失败重跑的成本与内存占用也变大;块小则相反。经验起点是几百条一块,用真实数据量各压一次,取总时长与单块耗时的平衡点。其二,作业要有防重入:调度器与网络抖动可能让同一作业被触发两次,靠作业名的唯一性约束或分布式锁拦住并发执行,比事后清理重复数据便宜得多。这两点都属于第一次上批处理才会踩的坑,提前一天知道就省一周。
本节要点回顾
- 分块三段式:读、处理、写,每块独立事务
- 作业仓库记录进度,重启从失败块续跑
- 处理组件保持无副作用,重跑安全是断点的前提
- 判断表分流两类工作,在线走请求,离线走作业
读完自测
三问收束:分块大小调优的两个反向指标是什么;断点续跑为什么要求处理组件无副作用;你的系统里哪类任务该从请求式改造成作业式。答完第三题,全书"旅程视角"的最后一次应用也就完成了。