8.3 微服务中的请求接力
8.3 微服务中的请求接力
本节摘要:请求旅程跨出单进程后,要穿过一批新的关卡:网关统一入口、注册中心寻址、跨服务调用、熔断降级,以及贯穿始终的链路追踪。本节按一个跨服务请求的实际路径讲这些设施如何协作,并讨论旅程拉长后代价与治理的平衡。
一单跨两服务的旅程
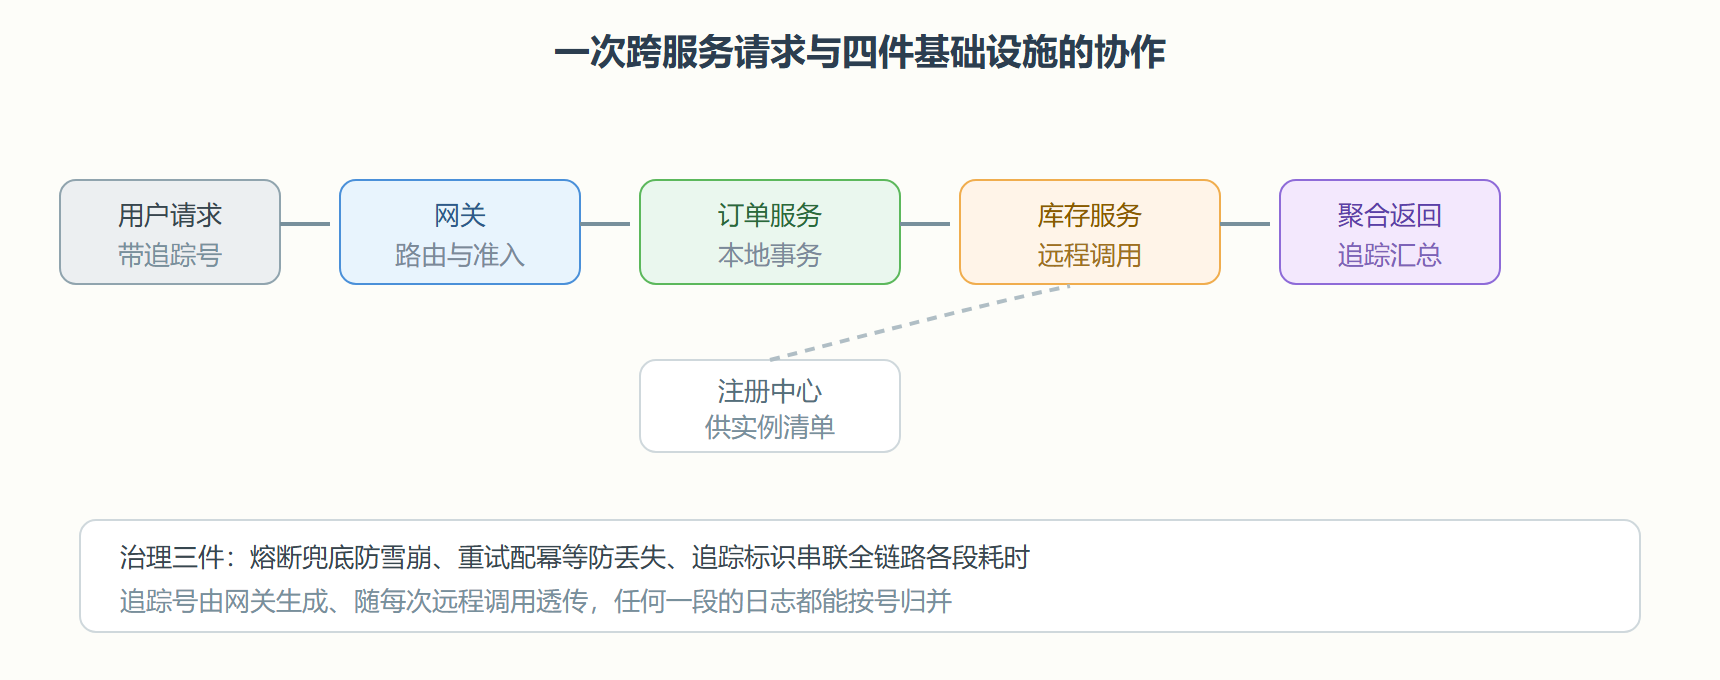
用户查订单详情,订单服务还要向库存服务要库存。请求的真实路径:先到网关,网关按路径路由到订单服务;订单服务本地处理中需要库存,向注册中心要库存服务的可用实例清单,挑一个发起远程调用;库存服务处理回传;两段结果聚合返回。任何一环失败都可能雪崩,于是每段远程调用都该有熔断兜底。
网关一层的典型配置(概念示例):
spring: cloud: gateway: routes: - id: order-route uri: lb://order-service # 负载均衡解析服务名 predicates: - Path=/api/orders/** - id: stock-route uri: lb://stock-service predicates: - Path=/api/stock/**
服务间调用用声明式客户端,写法像本地接口:
@FeignClient(name = "stock-service", fallback = StockFallback.class) public interface StockClient { @GetMapping("/api/stock/{sku}") StockVO getStock(@PathVariable String sku); } @Component class StockFallback implements StockClient { public StockVO getStock(String sku) { return StockVO.unknown(sku); // 库存服务不可用时返回兜底值 } }
调用方拿到的体验与第 3 章的依赖注入如出一辙——声明所需,框架递来实现,只是"实现"背后是一次远程旅程。这也是微服务最容易骗人的地方:接口长得像本地调用,成本却是网络级的。
图 8-3 跨服务请求的全路径与追踪标识
旅程拉长的代价清单
远程调用把原来进程内的方法调用变成跨网络协作,新账单上有四项必须认:部分失败(对方活着但超时,最难判);重试风暴(上游重试乘下游多倍放大,重试必须配幂等与退避);数据一致性(跨服务没有共享事务,要靠第 7 章的消息加最终一致);排障半径(一个报错要跨三个服务查日志,没有追踪就是盲人摸象)。所以拆分决策要克制:领域边界清晰、团队规模到位、独立伸缩诉求真实,三条都占再拆,用模块化单体起步并不丢人。
💡 追踪号的价值在故障时刻兑现:把网关生成的标识写进每段日志的公共字段,用户报障时拿号一查,全链路各段耗时立刻摊开。
演练:一次跨服务超时的完整排障
背景:用户反馈订单页偶发十秒才打开,三个服务各自日志都"没有异常"。操作按追踪号的线索走。第一步,取号:从报障记录拿到追踪号,在各服务日志里检索该号,找到同一请求的四段记录。第二步,拼图:四段时间戳相减——网关到订单服务八十毫秒,订单服务本地六十毫秒,订单调库存九千毫秒,聚合回传一百毫秒,瓶颈定格在跨服务调用一段。第三步,深挖:库存服务自身日志无错误,但该时段垃圾回收日志密集,长暂停与超时时间吻合;根因是库存服务堆内存吃紧,并非网络问题。修复:调大堆并优化一处大查询后,偶发超时消失。
解读:这次排障没有用任何神秘工具,靠的是"标识贯穿加时间戳相减"的基本功——链路追踪的本质就是把第 1 章"给九站插小旗"的实验自动化、跨进程化。变式:若当时熔断已配置且阈值设为三秒,用户看到的是八百毫秒的降级页而不是十秒等待——把演练改成"先配熔断再注入故障",团队对熔断价值的认识会具体得多。
关于服务间契约的一点补充
跨服务调用最大的隐性成本是契约演化:提供方改一个字段名,所有消费方在运行期才集体报错——编译器帮不上忙,因为边界上没有共享类型。治理手段从轻到重有三档:轻量做法是消费方测试打桩(用提供方的契约样例驱动测试,样例变了测试先红);中档是契约测试工具,双方各自跑同一份契约,两边都绿才算兼容;重档是共享接口包,版本统一但有耦合枷锁。新团队从轻量档起步足够,关键是让"提供方改接口"这件事在合并前就能惊动消费方——契约问题的本质是沟通问题,工具只是通信线路。
本节要点回顾
- 新四件关卡:网关、注册中心、熔断、追踪,各管旅程一段
- 声明式客户端像本地调用,成本却是网络级,别被骗
- 重试必须配幂等与退避,否则故障自我放大
- 拆分三条件:边界、团队、伸缩诉求,不满足先模块化
读完自测
三问收束:跨服务排障的第一步动作是什么;熔断器三态如何轮转、降级兜底和它是什么关系;拆分前的三个条件你所在的项目满足几条。第三题结合自身答,比任何标准答案都有价值——它直接给出你该不该微服务化的结论。
与全书的呼应
到这里,第 1 章的九站地图已扩展成跨进程版本:每一站多了一层"如果是远程的会怎样"的追问。带着这张放大版地图回看前七章,每个框架组件的位置与边界会更加清晰。
全书最后一条建议:无论是否微服务化,第 1 章的九站地图都值得每季度重画一次——加一个中间件、换一个数据库驱动,站点的顺序与成本都会变。地图的更新频率,就是架构认知的更新频率。带着它读任何新框架,你问的第一个问题永远是:这个组件站在旅程的哪一站。
最后留一个思考题作为全书的收尾:如果让你为自己当前的系统画一张请求旅程图,它有几站?哪一站最贵?哪一站最脆?把答案画出来贴在团队看板上,这本书的所有内容就都落了地——地图不是教材的插图,而是你系统的自画像。
再补一句关于熔断参数的体感:阈值设得太敏感,正常抖动也会触发降级,用户频繁看到兜底页;设得太迟钝,熔断形同虚设。起步值不必纠结,先按经验设一组,再用真实流量的失败率数据每两周校准一次——熔断器的参数是养出来的,不是拍出来的。