2.2 代谢网络与通路地图
2.2 代谢网络与通路地图
代谢通路是酶促反应按底物-产物关系串联成的路线图,如糖酵解十步反应把葡萄糖变成丙酮酸。通路数据库(KEGG、Reactome、HMDB)把几万条反应组织成可查询的网络——它是代谢组学从"差异名单"走向"机制解释"的桥梁。
通路是流量网络,不是零件清单
糖酵解十个代谢物单独看只是一张浓度表,连成通路后才回答"糖往哪个方向流、卡在哪一步"。通路图的本质是有向图:节点是代谢物,边是酶促反应(带方向与化学计量),酶本身受基因表达和变构调节控制。
以糖酵解的一段为例,用邻接表表达比画图更接近数据库的真实存储:
glycolysis = { "GLC": ("G6P", "己糖激酶"), "G6P": ("F6P", "磷酸葡萄糖异构酶"), "F6P": ("F16BP","磷酸果糖激酶 PFK"), # 通路的限速步骤 "F16BP":("G3P", "醛缩酶"), "G3P": ("PEP", "多步反应"), "PEP": ("PYR", "丙酮酸激酶"), } # 上游抑制 PFK 时,F6P 堆积、F16BP 下降—— # 这种"底物升/产物降"的组合模式,是通路层面判断抑制位点的证据
代谢组学解读中的关键手法正来自这里:单个代谢物变化说服力弱,一组按通路拓扑排列的协同变化说服力强。色氨酸下降 + 犬尿氨酸上升,指向犬尿氨酸通路分流,这比任何单分子差异都更有机制感。
网络的三个组织层次
层次透视
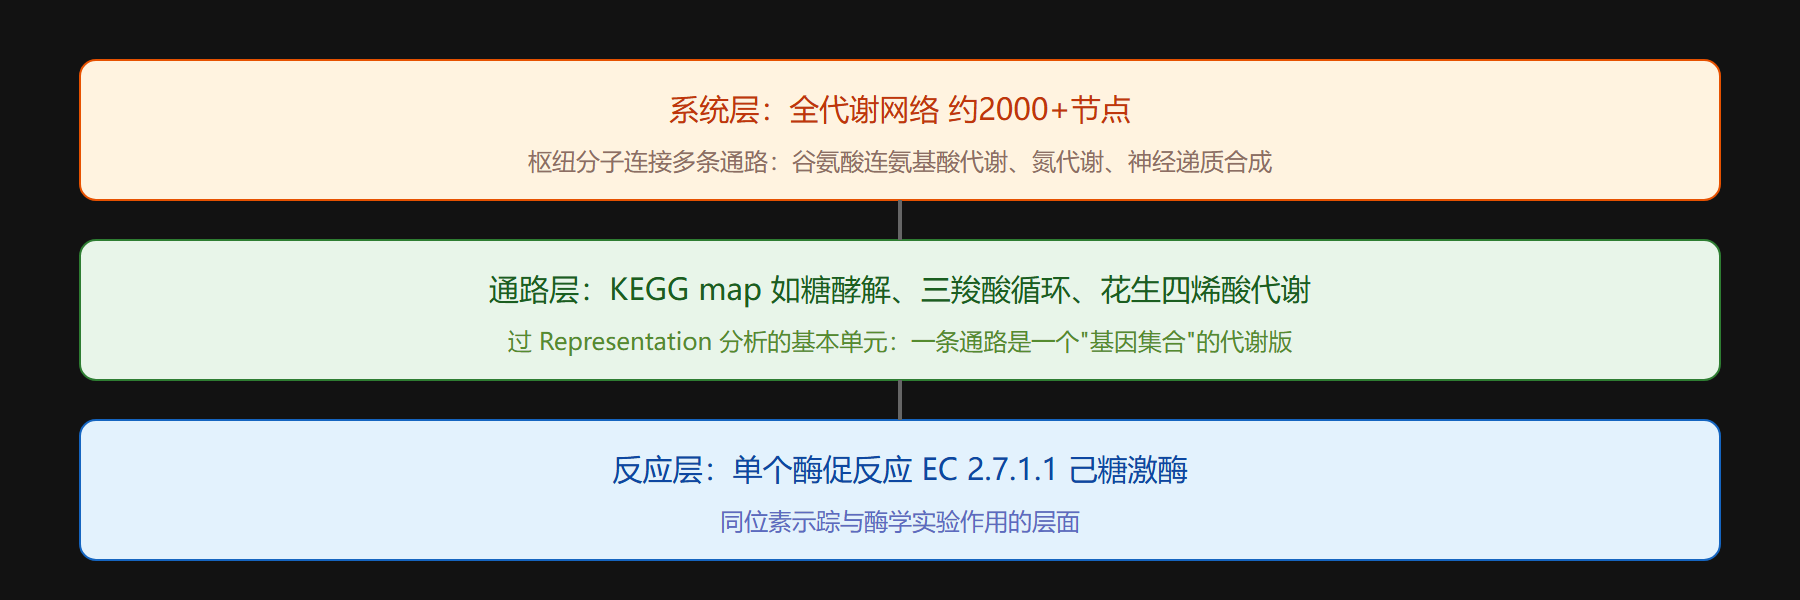
主要数据库一览
| 数据库 | 组织方式 | 代谢组学里的典型用法 |
|---|---|---|
| KEGG | 通路图 + KO 编号 | 通路富集分析的事实标准 |
| HMDB | 人类代谢物条目 | MS/MS 检索、注释校对 |
| Reactome | 通路-反应层级 | 哺乳动物通路细节更全 |
| LipidMaps | 脂质分类命名体系 | 脂组学命名的权威来源 |
| MetaCyc | 跨物种通路 | 微生物/植物研究 |
枢纽节点:网络的交通枢纽
谷氨酸、丙酮酸、乙酰辅酶 A 这类分子同时出现在四五条通路上,像城市里的换乘枢纽——任何一条线路拥堵都会在这里显现。这带来解读上的双刃性:枢纽分子变了,你很难直接说清是哪条通路的问题,需要看它邻域里其他节点的协同方向。
💡 关键直觉:通路分析的价值不在"找到一条 p 值最小的通路",而在把几十个散点差异压缩成两三个有方向的生物学陈述。
本节要点回顾
- 通路 = 有向图:底物-产物边 + 酶调控,数据库按此存储
- 协同模式优于单点:底物升产物降的组合才能定位受阻步骤
- 三层组织:系统网络 → 通路 → 反应,分析粒度逐层下降
- 枢纽分子敏感但归因难:需邻域协同证据
- 数据库分工明确:KEGG 做富集、HMDB 做注释、LipidMaps 管命名
第 3 章回到现实:怎么设计实验把这些分子测准。
网络的拓扑统计:代谢组学为什么天然适合网络分析
常见模式生物的代谢网络约含 1000–2000 个代谢物节点、2000–5000 个反应边。对酵母代谢网络的分析显示度分布呈幂律:少数枢纽代谢物(ATP、NADH、丙酮酸、谷氨酸)连接数占全部边的相当比例。这个"无标度"结构有两层直接后果:其一,动一个枢纽代谢物会波及全网络,解释了能量代谢扰动为何总表现为系统性表型;其二,网络的鲁棒性来自冗余路径——单一酶缺失常被旁路补偿,因此代谢组学差异往往出现在"通量重新分配"的交界代谢物上,而不是缺失酶的直接底物。
| 网络统计量 | 典型值(人类代谢网络 Recon3D) | 代谢组学含义 |
|---|---|---|
| 节点(代谢物) | 约 4000+ | 覆盖了 HMDB 核心集 |
| 边(反应) | 约 13000 | 远超可测量上限 |
| 连通分量 | 1 个巨分量 | 差异代谢物总能连成通路故事 |
| 枢纽节点度 | ATP 约 500+ | 能量代谢是最常见的受扰轴 |
从差异列表到子网络:一个最小实现
# 输入:差异代谢物列表 + 反应邻接表(节选自 TCA 与氨基酸代谢) edges = [("柠檬酸", "异柠檬酸"), ("异柠檬酸", "aKG"), ("aKG", "琥珀酸"), ("琥珀酸", "延胡索酸"), ("谷氨酸", "aKG"), ("谷氨酰胺", "谷氨酸"), ("延胡索酸", "苹果酸")] hits = {"aKG", "谷氨酸", "琥珀酸"} # 非靶向筛选的差异代谢物 # 找被差异代谢物锚定的最短通路片段(本例手工 BFS 一层邻域) adj = {} for a, b in edges: adj.setdefault(a, set()).add(b); adj.setdefault(b, set()).add(a) for h in hits: print(f"{h} 的直接邻居: {sorted(adj.get(h, []))}") # 输出显示三个 hit 通过 aKG-谷氨酸转氨反应相连: # "谷氨酰胺分解 + TCA 中段"子网络被打亮,这就是通路富集的网络版逻辑
脚本展示的"锚定邻域"是 over-representation analysis(ORA)的朴素版:实际工具(MetaboAnalyst、Mummichog)用超几何检验或网络传播替代人工判断,但输入输出结构完全一致——差异代谢物进、打亮的子网络出。第 5 章会展开这些方法的统计学差异与选择标准。
地图的版本问题
通路数据库(KEGG、Reactome、HMDB 通路视图)之间并不一致:同一通路收录的酶数可差 30%, organism-specific 版本与参考通路的差异更大。做通路富集时的一个实操要点是固定数据库版本号并在方法学部分注明(如 "KEGG 2023-06 release"),否则半年后复核可能无法复现。把"地图"当作有版本的数据库而非公共常识,是结果可重复性的隐形前提。
网络视角还改变"差异代谢物"的解读方式。孤立的浓度升高有两种机制——生成上调或消耗下调——通路位置能提供区分线索:若上游前体与下游产物同时升高,更像生成侧上调;若上游升高而下游降低,则提示下游酶受阻(底物堆积模式)。教科书案例是遗传性酶缺陷患者的代谢组:缺陷酶的底物大量堆积、产物缺失,旁路产物出现,这三点组合在网络图上构成"堵塞指纹",新生儿筛查的判读逻辑即由此而来。培养"把浓度表放回网络再读"的习惯,是从操作员到分析者的分水岭。