3.2 样本采集与预处理流程
3.2 样本采集与预处理流程
前处理的目标只有一个:让离开移液枪的那份提取物尽可能代表体内那一刻的化学状态。淬灭酶活性、去除蛋白质、富集目标化学域——三步里每一步的化学依据都来自第 2 章。
血浆:最常见也最容易做坏的一种
标准工序与化学理由对照:
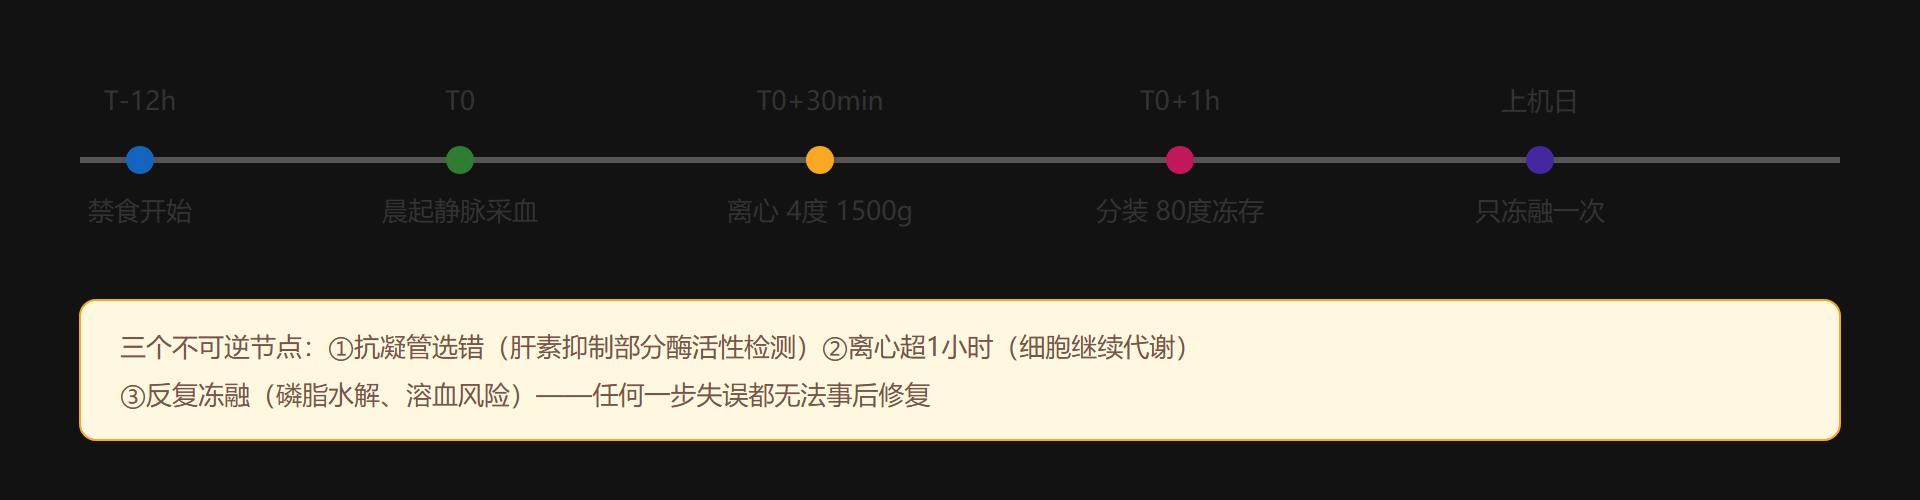
血浆采集时间线
前处理的主流三选一:
| 方案 | 操作 | 测什么 | 得失 |
|---|---|---|---|
| 蛋白沉淀 | 3 倍体积冷甲醇/乙腈 | 广谱非靶向 | 简单快速,磷脂残留会污染反相柱 |
| 液液萃取 MTBE | 有机相取脂质 | 脂组学 | 脂质回收高,极性物全丢 |
| 固相萃取 SPE | 柱上富集洗净 | 靶向痕量物 | 灵敏但通量低、每柱有批次差 |
血清 vs 血浆:不是文字游戏
血清要等凝血 30-60 分钟,期间血小板持续释放代谢物、细胞继续耗能——血清的代谢谱系统性偏离体内状态。代谢组学默认用血浆(EDTA 或肝素抗凝),除非与历史血清队列对接。
尿液:最容易被忽略的归一化问题
尿浓度随水合状态大幅波动,必须归一化:肌酐归一化(默认)、比重法、渗透压法。不归一的尿液代谢组学数据,组间差异里很大一块是"谁喝水多"。
组织样本:淬灭是第一秒的事
活检或手术取下的组织,离体后酶还在工作。标准动作:离体 30 秒内液氮速冻或干粉保存。冷缺血每多一分钟,ATP/AMP 比值、乳酸都在变。做回顾性研究时,一定要核对组织库的冷缺血记录——这项 metadata 常常比分组信息更能解释数据方差。
💡 关键直觉:前处理方法一旦换掉,数据就不再可比。很多实验室把"提取方案版本号"写进数据文件名,比事后回忆可靠得多。
本节要点回顾
- 血浆优先于血清:凝血等待期的代谢漂移不可控
- 三个不可逆节点:抗凝管、离心时限、冻融次数
- 前处理三选一:沉淀管广谱、MTBE 管脂质、SPE 管痕量靶向
- 尿液必须归一化:肌酐法是默认选项
- 组织第一秒定生死:速冻时机与冷缺血记录
下一节讲质控体系——怎么知道这一批数据可信。
时间线是预处理的核心变量
代谢组学样本的"新鲜度窗口"以分钟计:全血在室温放置 10 分钟,乳酸升高、葡萄糖下降即超出仪器噪声;血清分离凝血过程本身释放代谢物(细胞持续代谢约 30 分钟),因此血浆(抗凝即刻离心)更适合代谢组学。组织样本从取出到冻存应控制在 30 秒内(液氮速冻),脑组织尤甚——死后缺血数分钟即可让能量代谢物全面翻盘。这张时间账决定了采样现场必须"离心理机、液氮罐、标签系统"三件套齐备。
| 样本类型 | 关键时限 | 推荐抗凝/稳定剂 | 常见错误 |
|---|---|---|---|
| 血浆 | 离心前 ≤ 30 min,4°C | 肝素/EDTA(避免柠檬酸盐污染) | 用血清做糖代谢研究 |
| 尿液 | 采后 2 h 内冻存 | 无菌操作,测肌酐校正 | 室温过夜 |
| 组织 | 取出到液氮 ≤ 30 s | 无 | 冰上"慢慢冻" |
| 细胞 | 培养基快速抽滤/离心 | 冷 PBS 漂洗 2 次 | 用胰酶消化(引入应激) |
| 粪便/肠内容物 | 立即冻存 | 考虑加稳定剂 | 反复冻融 |
提取溶剂体系的配方逻辑
# MTBE 法与甲醇水法对脂质/极性代谢物的分配估算(回收率%文献典型值) protocols = { "MTBE:MeOH:H2O (10:3:2.5)": {"脂质": 92, "磷脂": 95, "氨基酸": 65, "有机酸": 58}, "MeOH:H2O (8:2) 冷激": {"脂质": 35, "磷脂": 40, "氨基酸": 90, "有机酸": 88}, "ACN:MeOH:H2O (2:2:1)": {"脂质": 55, "磷脂": 60, "氨基酸": 85, "有机酸": 82}, } goal = "全谱覆盖" for p, rec in protocols.items(): worst = min(rec.values()) print(f"{p}: 最差回收 {worst}%({'全谱友好' if worst > 55 else '偏科,需双提取'})") # 结论:单溶剂体系必有盲区,全谱研究用 MTBE 双相法一次拿两相
冻融与储存:被低估的变量
-80°C 长期储存中,胆碱磷脂会缓慢降解为溶血磷脂(lysoPC 升高是老样本的经典假信号);反复冻融 3 次后多数氧化型脂质显著上升。规范做法是分装成单次使用量、记录冻融次数并把"储存时长"作为协变量纳入统计模型。批间比较时,匹配储存时长比匹配更多混杂都重要——这条经验只有踩过坑的实验室才会写进 SOP。
提取环节的损失追踪
# 用内标回收率判断提取是否合格(目标 70–130%) is_spiked, is_measured = 100.0, 84.0 # 加入量与测得量(任意单位) recovery = is_measured / is_spiked * 100 print(f"内标回收率 {recovery:.0f}% → {'合格' if 70 <= recovery <= 130 else '批次作废'}") # 每批样本的回收率还应看分布:若组间回收率不同,差异分析前必须校正 batch = [82, 85, 79, 88, 84, 120] # 六个提取批的回收率% import statistics as st print(f"批间中位 {st.median(batch):.0f}%,最大偏离 {max(abs(b-85) for b in batch)}%")
内标时机也有讲究:提取前加入的同位素内标能同时校正提取损失与离子化波动,进样前才加的只能校正后者。方法学写作中注明内标加入时机是审稿常查项。回收率超出允收窗的批次,正确处置是整批重提而不是事后统计补救——本章的每个时限与门槛,最终都为了一个目标:让"进样瓶里的组成"忠实代表"生物体内的组成"。
最后给细胞样本补一段常被低估的细节:培养基成分本身就是代谢物污染源。血清中的葡萄糖、氨基酸与脂质会混入胞内谱,标准做法是冷铵甲酸盐或冷 PBS 快速漂洗两到三次,但漂洗本身又带来应激风险(低温激冷激活磷酸化级联),因此漂洗时间要压在三秒以内并立即用冷溶剂淬灭。贴壁细胞用甲醇直接抽滤法可以在一秒内同时完成淬灭与裂解,悬浮细胞则用快速离心加冷溶剂。这类以秒计的操作细节,正是胞内代谢组数据能否反映真实状态的关键,也是两个实验室"同一样本不同结果"的最常见出处。